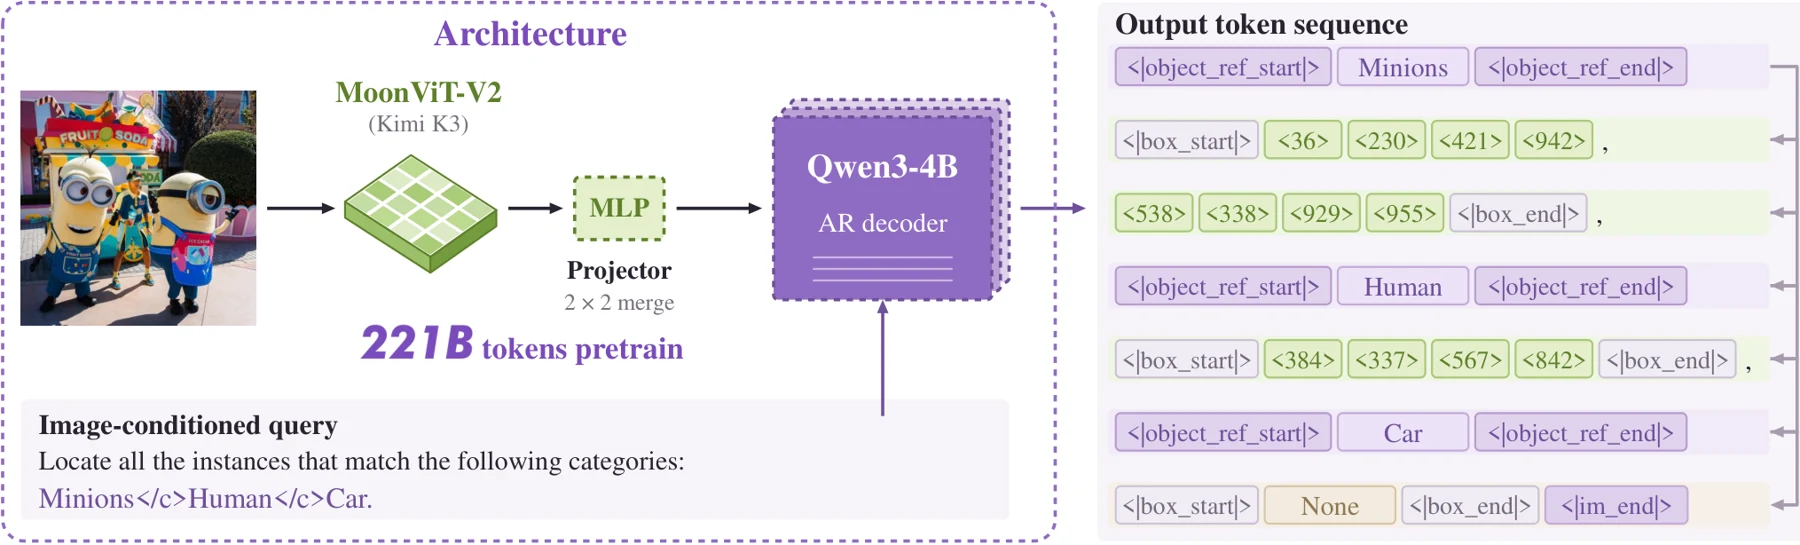
GroundingPI:把精确定位训练成物理智能的感知基础
点和框的定位训练,能否让机器人用更少示范学会动作?GroundingPI 用统一坐标词表、感知数据引擎与强化后训练构建 grounding 骨干,并在固定动作模型的条件下检验迁移。本文梳理其定位能力、机器人泛化与驾驶结果,以及密集定位和 OCR 数据消融的证据边界。
Reading notes, research ideas, and things learned along the way.
点和框的定位训练,能否让机器人用更少示范学会动作?GroundingPI 用统一坐标词表、感知数据引擎与强化后训练构建 grounding 骨干,并在固定动作模型的条件下检验迁移。本文梳理其定位能力、机器人泛化与驾驶结果,以及密集定位和 OCR 数据消融的证据边界。
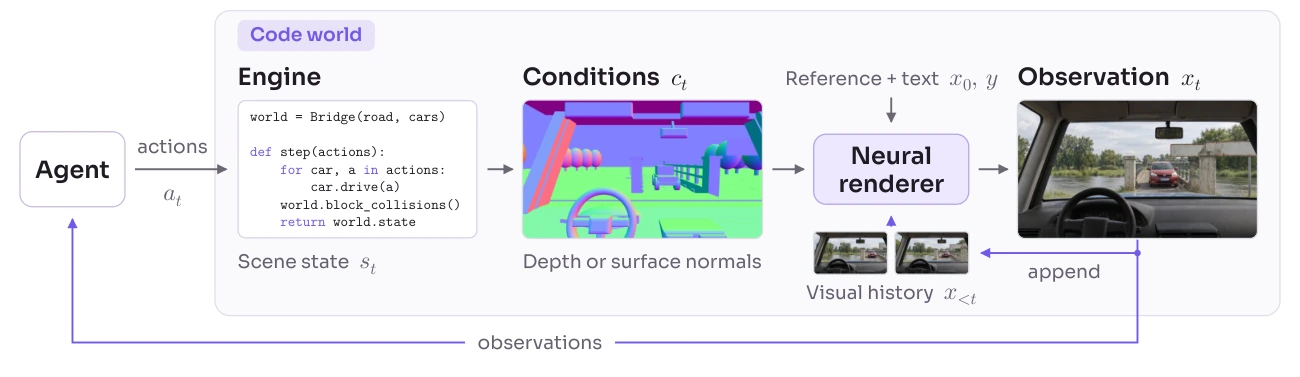
Agent 需要既能保留动作后果、又能提供丰富视觉观测的练习环境。AgentGarten 将代码维护的世界状态与实时神经渲染分开,并让预训练 Agent 通过跨轮 playbook 积累经验。本文分析条件接口、Adversarial Forcing 和学习案例,区分渲染真实性、状态可靠性与长期能力改进。
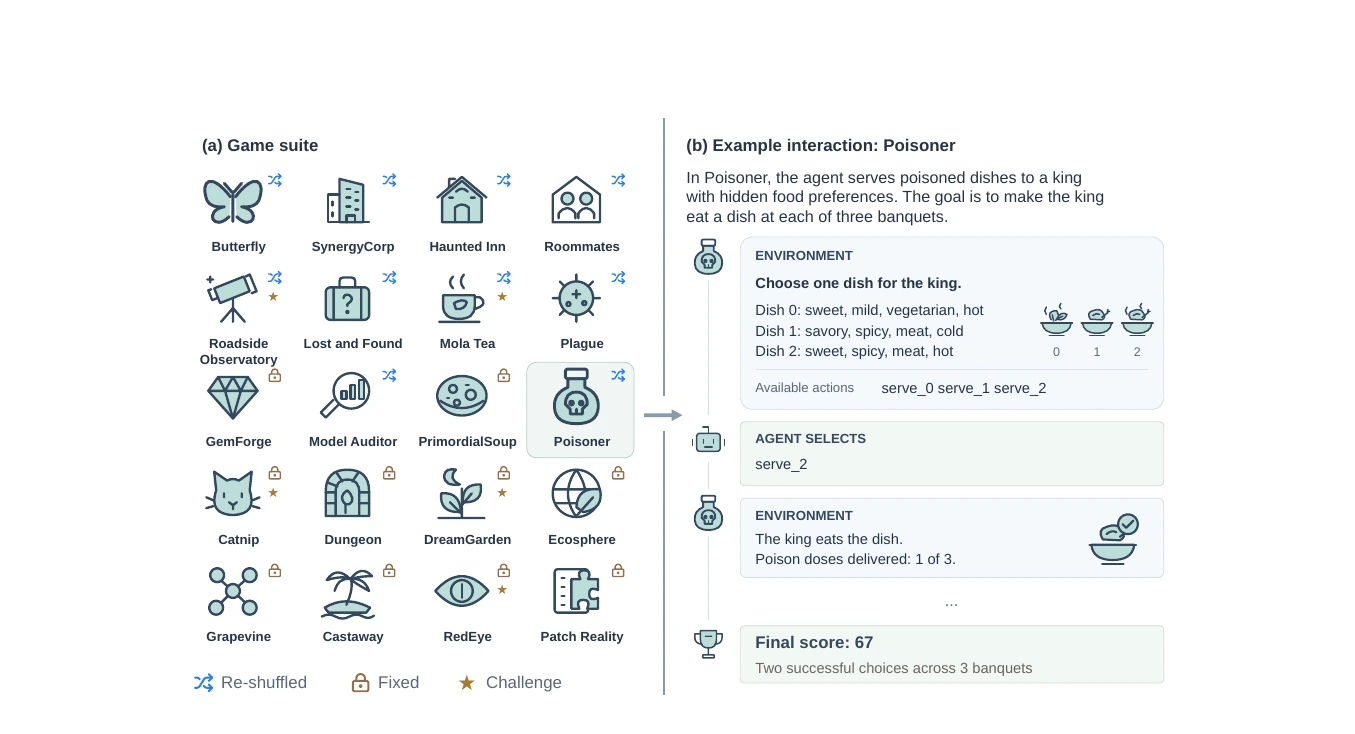
答对已知游戏,不足以证明 Agent 从交互中学到了规则。Learn2Play Bench 用 20 个隐藏规则游戏比较模型、经验保留与执行框架。本文分析峰值成绩和学习速度的区别、原始记忆与抽象规则的对照,以及跨实例迁移和人类比较的评价条件。
当一组尝试全部失败,标量奖励没有对比,但轨迹仍留下了失败原因。Self-Retrospection Distillation 用事后信息监督行动前的知识与陷阱预测。本文分析训练目标、同奖轨迹、十项评测和通道消融,并区分训练成功率、测试收益与额外推理。
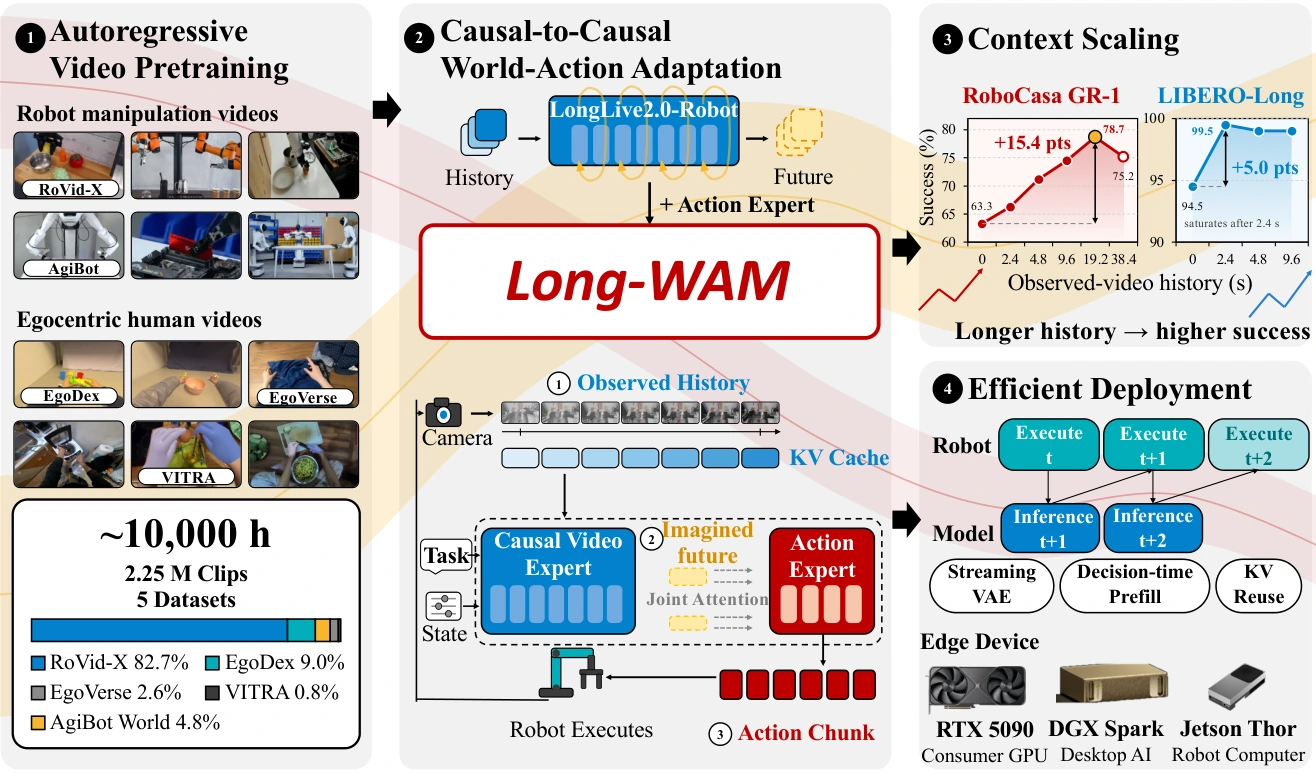
机器人看到更长历史,并不意味着能用好历史。Long-WAM 先学习自回归视频预测,再把历史和部分去噪的未来表征连接到动作生成,并用流式编码与异步执行降低等待。本文分别分析上下文扩展、预测表征、真机任务和系统加速的证据。
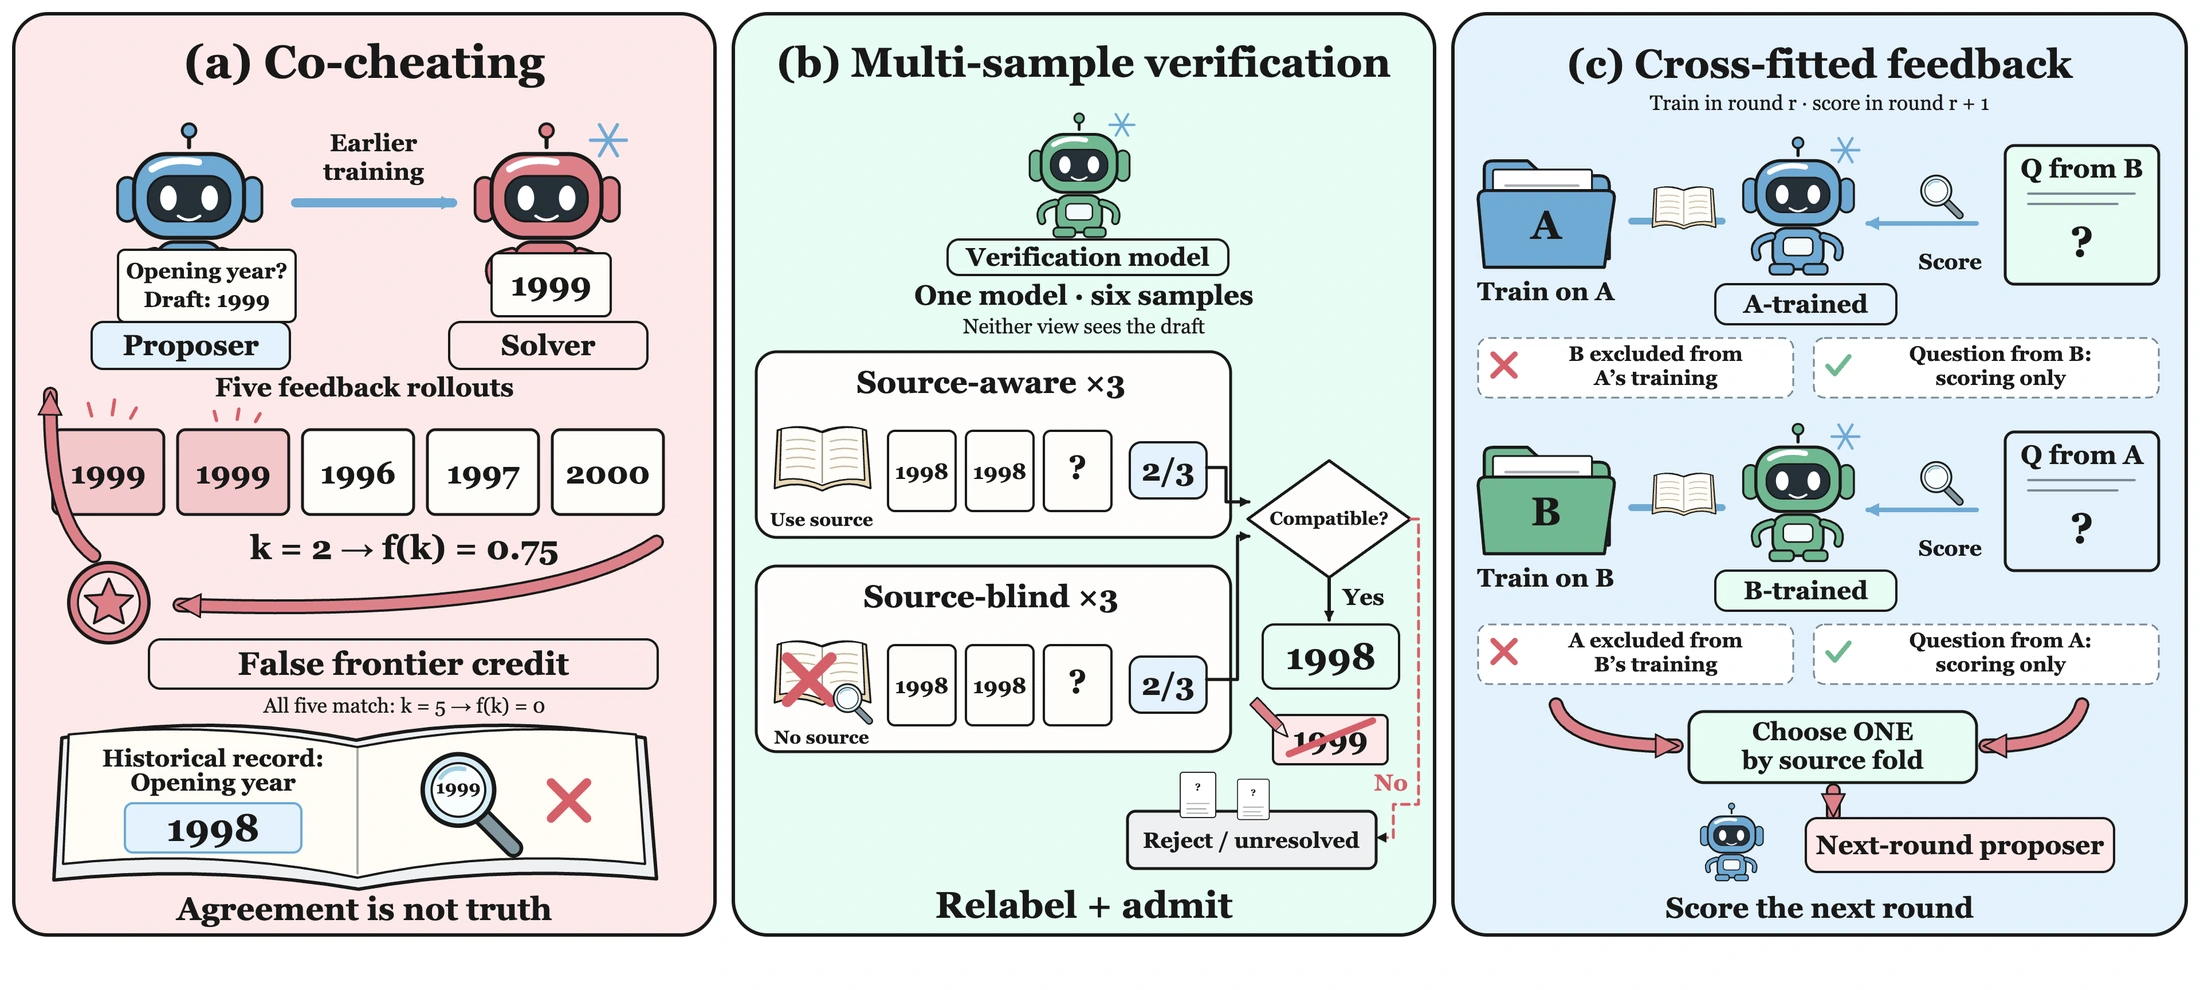
出题者与解题者互相认可,会不会把共享错误当成训练进步?False Frontiers 用外部证据审计发现 co-cheating,并通过按来源划分训练数据的 CrossFit 改变出题者反馈。本文区分入库验证和反馈来源,分析自适应训练与固定题库重放中的证据。
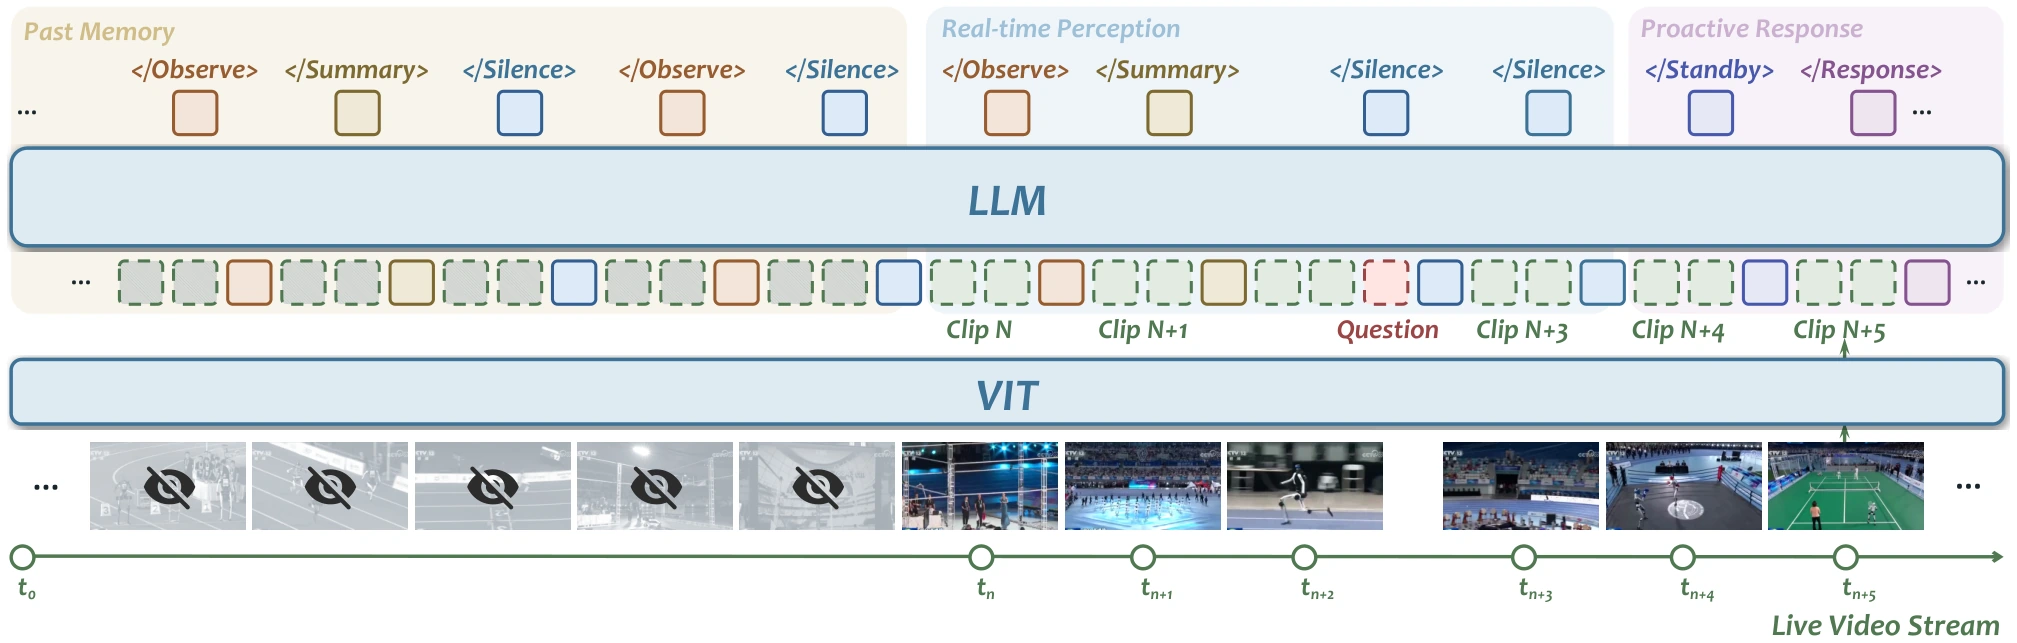
视频助手需要先保留事实,再判断什么时候回答。OneStreamer 用分层描述记忆补充近期视觉窗口,并通过状态转移监督学习何时记录、等待与响应。本文拆解在线因果约束、训练数据和八项基准,分析文本记忆的收益、延迟与纠错缺口。
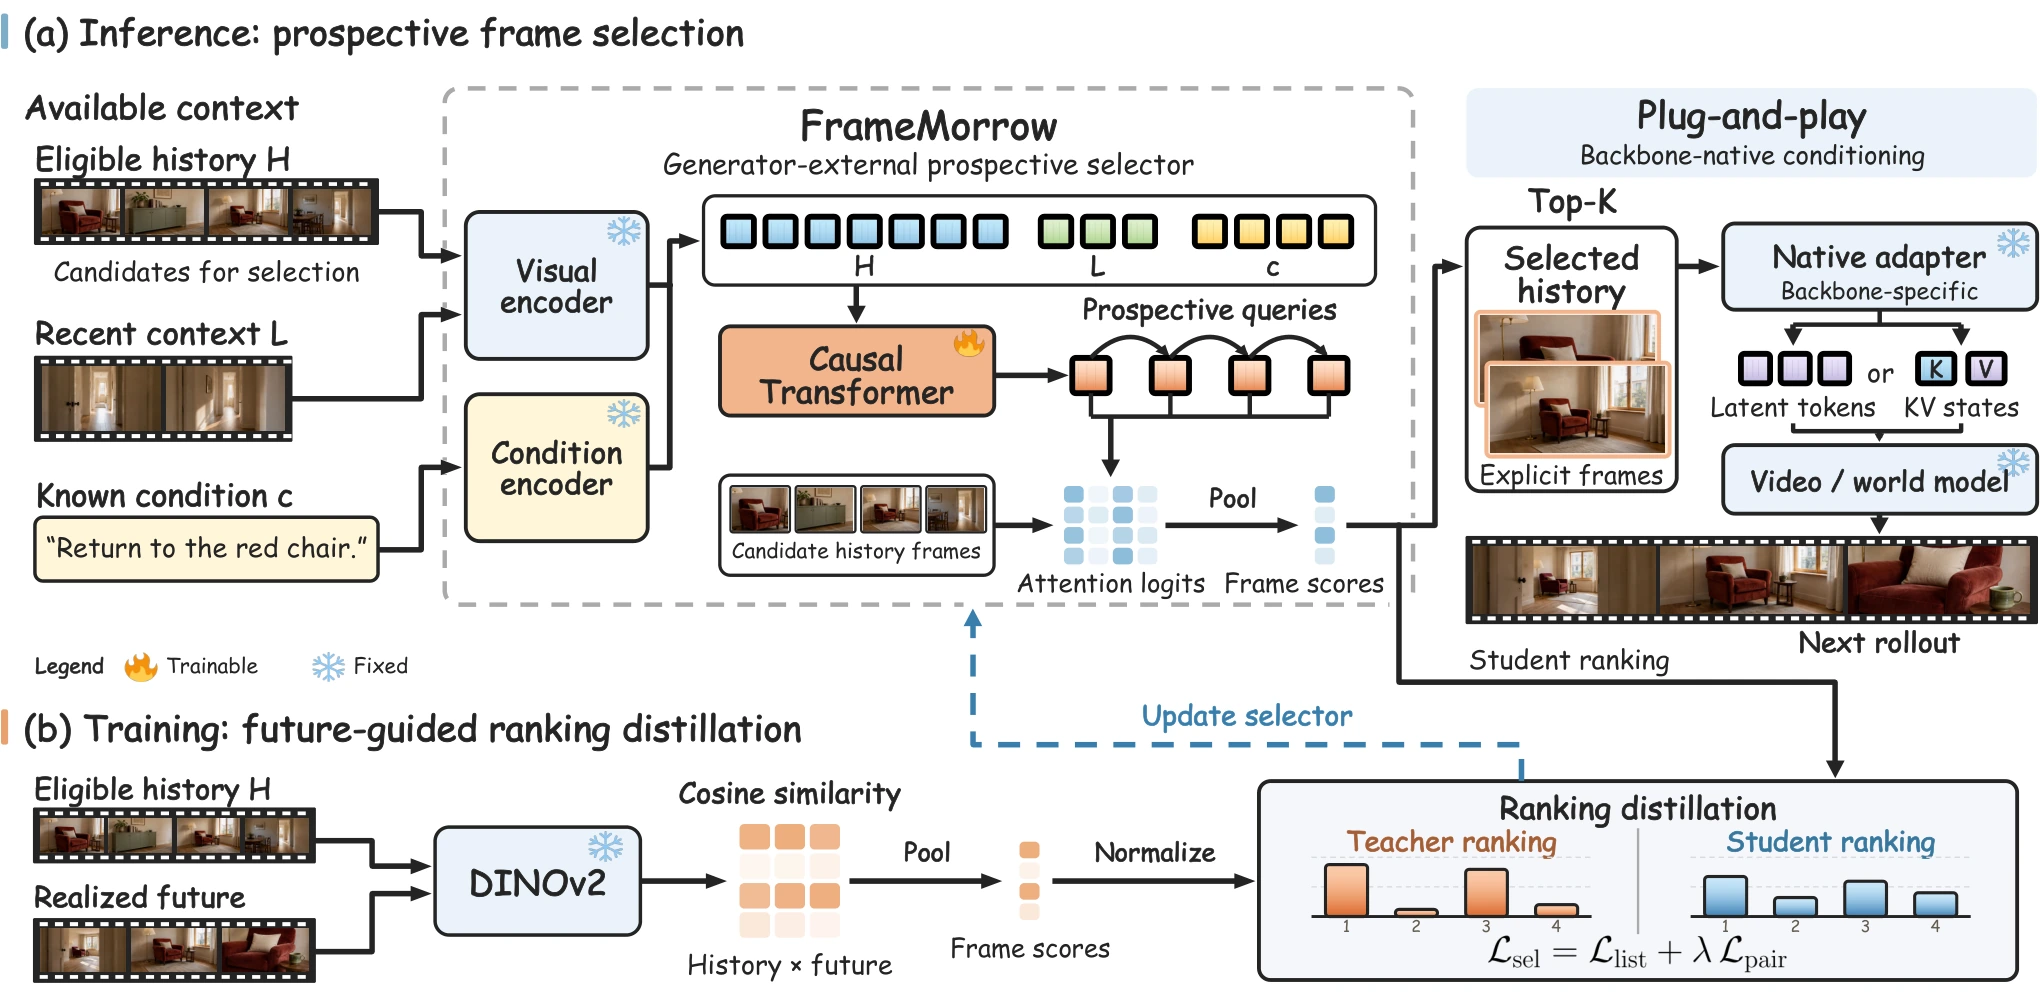
与当前画面最相似的历史,不一定对下一段生成最有帮助。FrameMorrow 预测少量 prospective tokens,以未来相关性给历史帧排序,并通过现有参考帧接口接入生成器。本文分析训练时未来监督、推理时因果约束、匹配预算比较和长时一致性的边界。
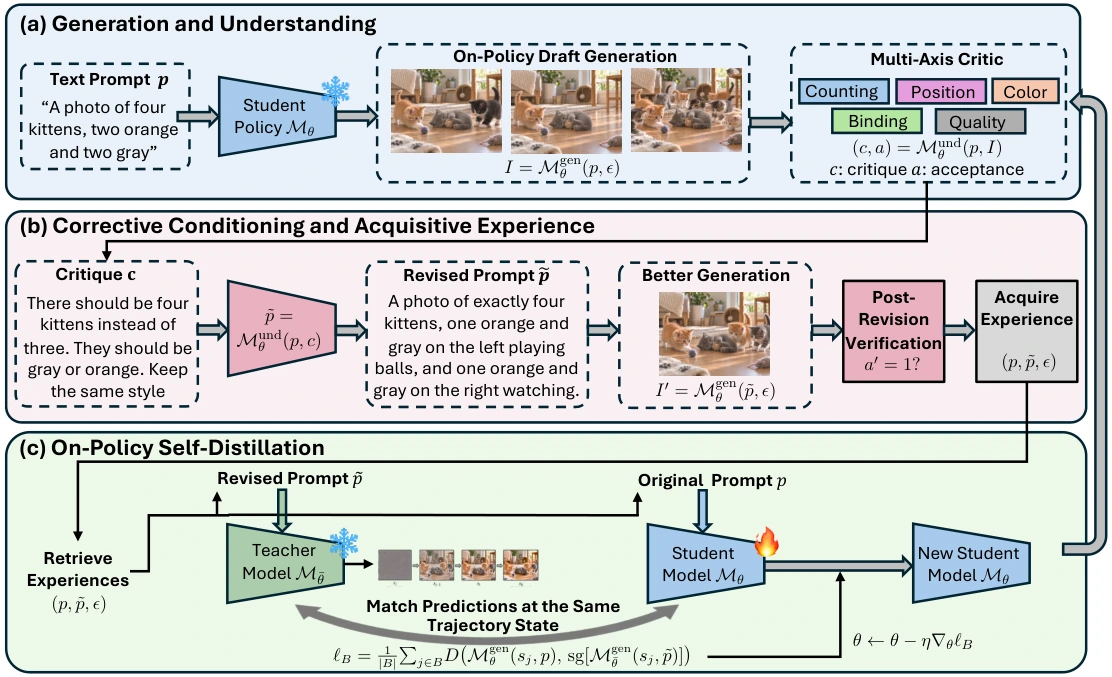
生成模型能否从自己发现的图像错误中学习?UniEvo-VL 将修改建议变成教师的特权上下文,在学生自己的去噪轨迹上进行自蒸馏。本文核对生成与反馈模块的实际分工,比较验证前后的 GenEval、GenEval2 和 OCR 结果,分析局部改进与能力回归。
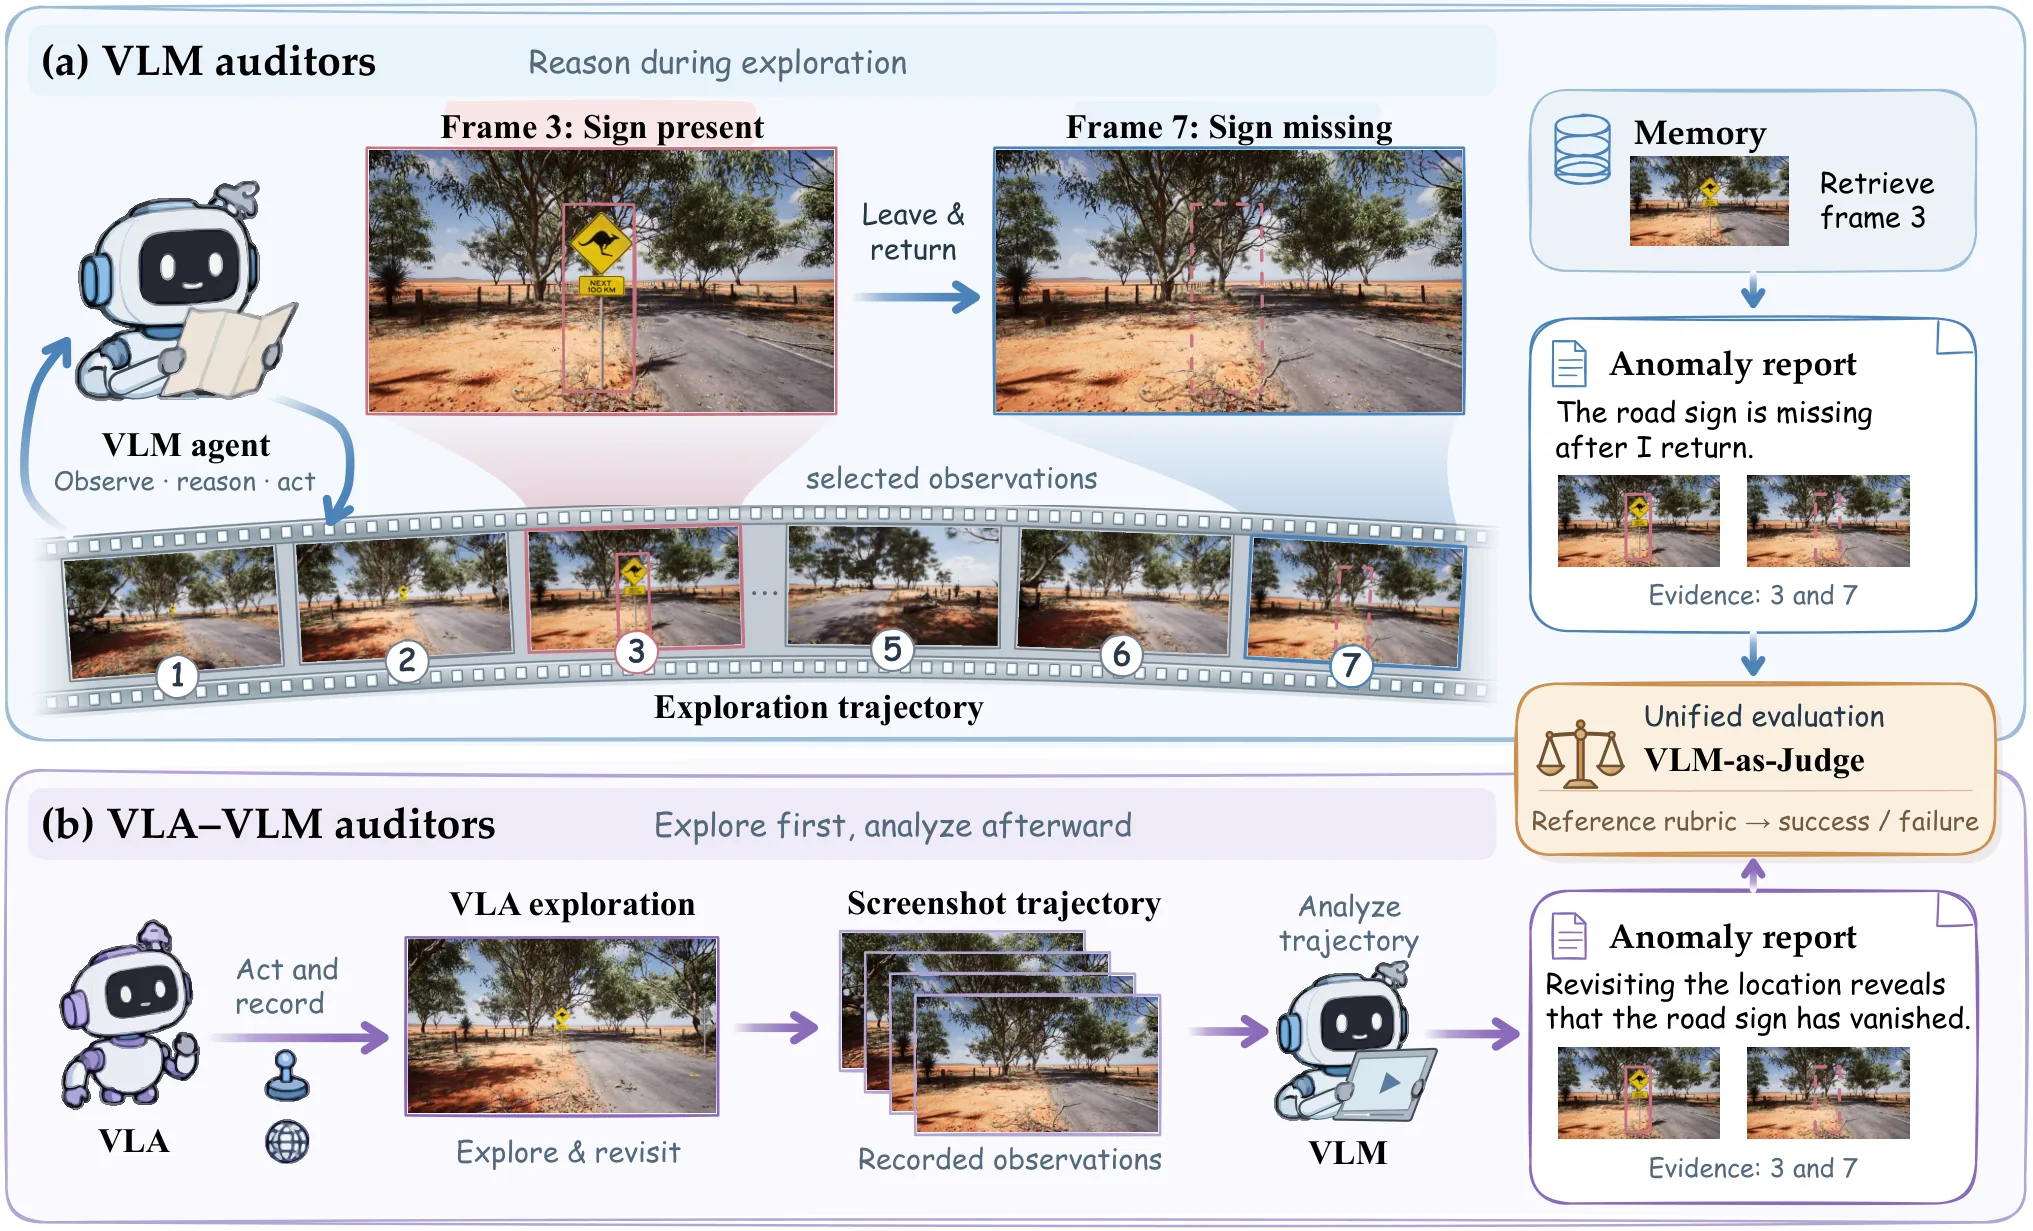
发现悬浮物体可以看一张图,确认穿墙或物体消失则需要行动与记忆。WorldAuditBench 用 213 个三维异常任务比较边探索边推理和固定轨迹分析。本文分析任务提示、探索预算、评审与暴露诊断,区分没有看到异常和看到后没有理解。