LoopVL:共享参数怎样在循环中重新读取视觉证据
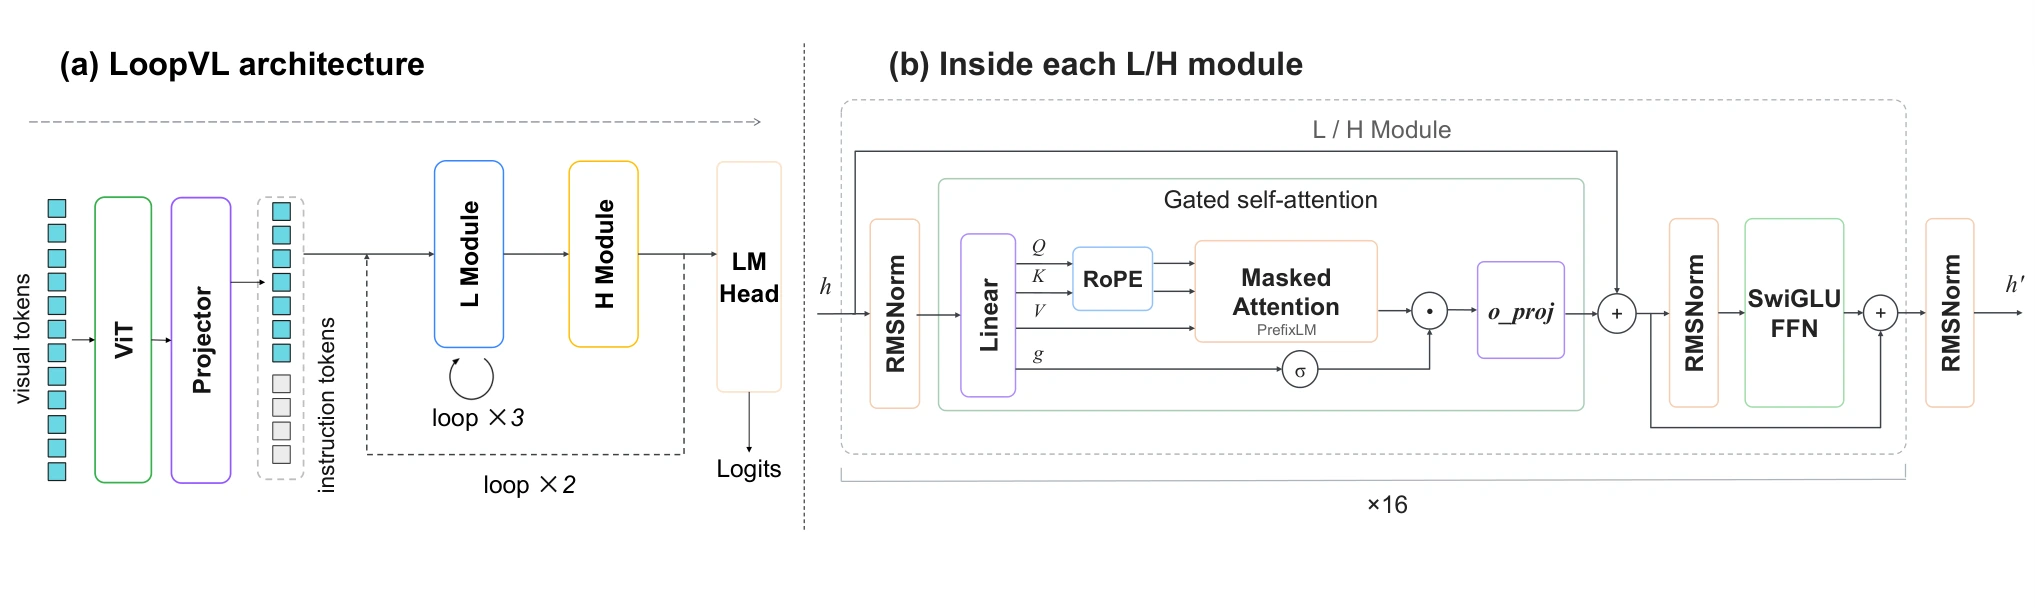
视觉语言模型增加有效深度,是否必须增加同等规模的参数?LoopVL 让低层与高层模块循环更新多模态状态。本文从计算预算、训练和推理循环的匹配、视觉注意力变化出发,分析参数复用的收益,以及为什么更多循环不自动带来更好答案。
Reading notes, research ideas, and things learned along the way.
视觉语言模型增加有效深度,是否必须增加同等规模的参数?LoopVL 让低层与高层模块循环更新多模态状态。本文从计算预算、训练和推理循环的匹配、视觉注意力变化出发,分析参数复用的收益,以及为什么更多循环不自动带来更好答案。
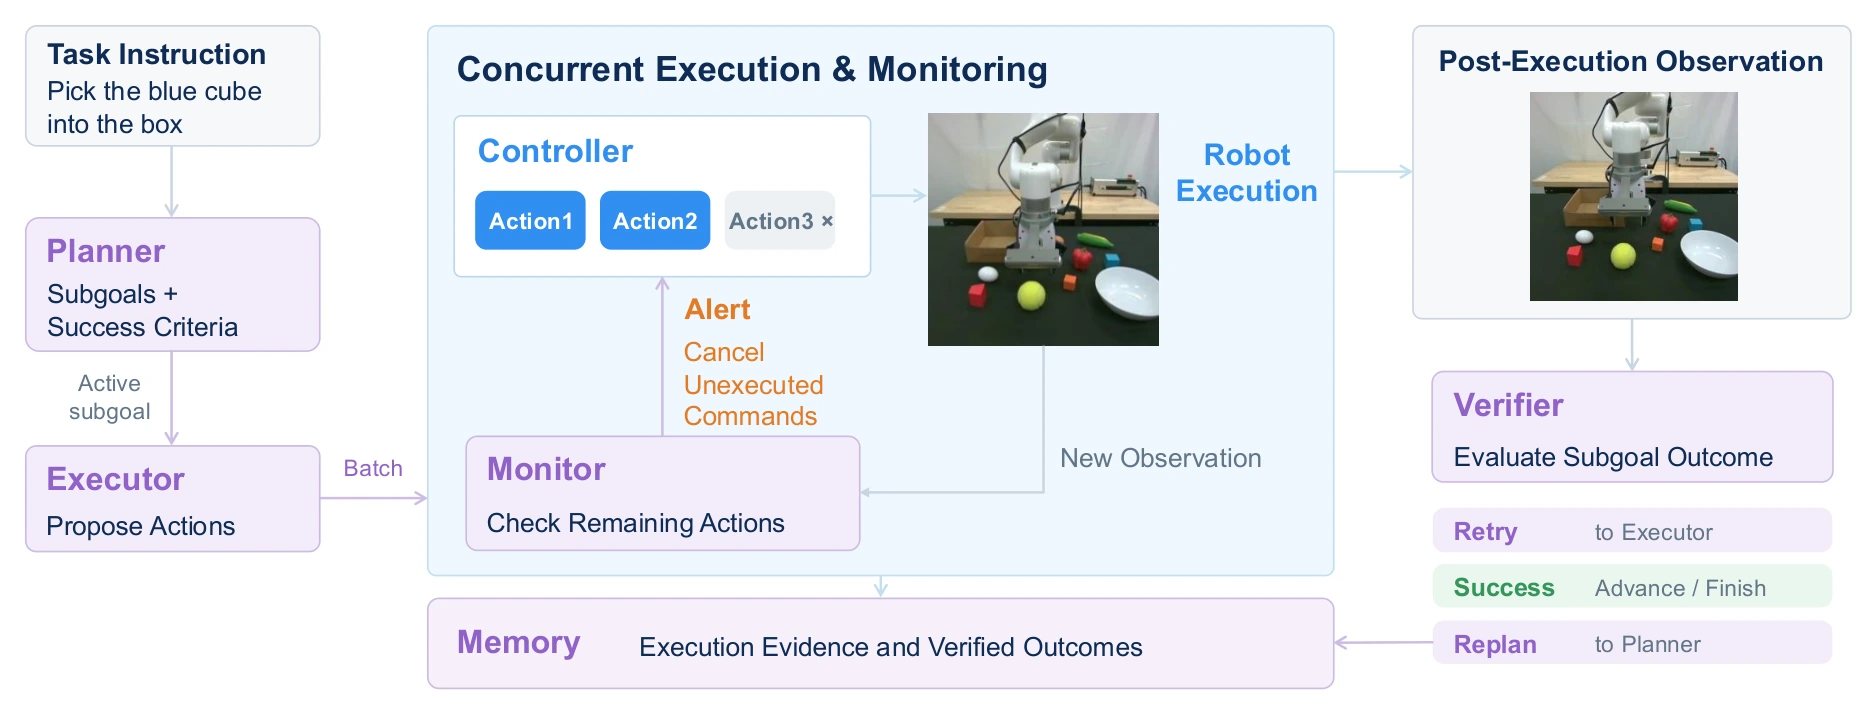
通用视觉语言模型能否不依赖任务专用动作训练来控制机器人?MotorMind 以中层动作接口连接 VLM 决策与确定性控制,并加入异步监控、验证和记忆。本文对照零样本与微调策略、动态任务和真机实验,分析接口带来的收益及定位误差。
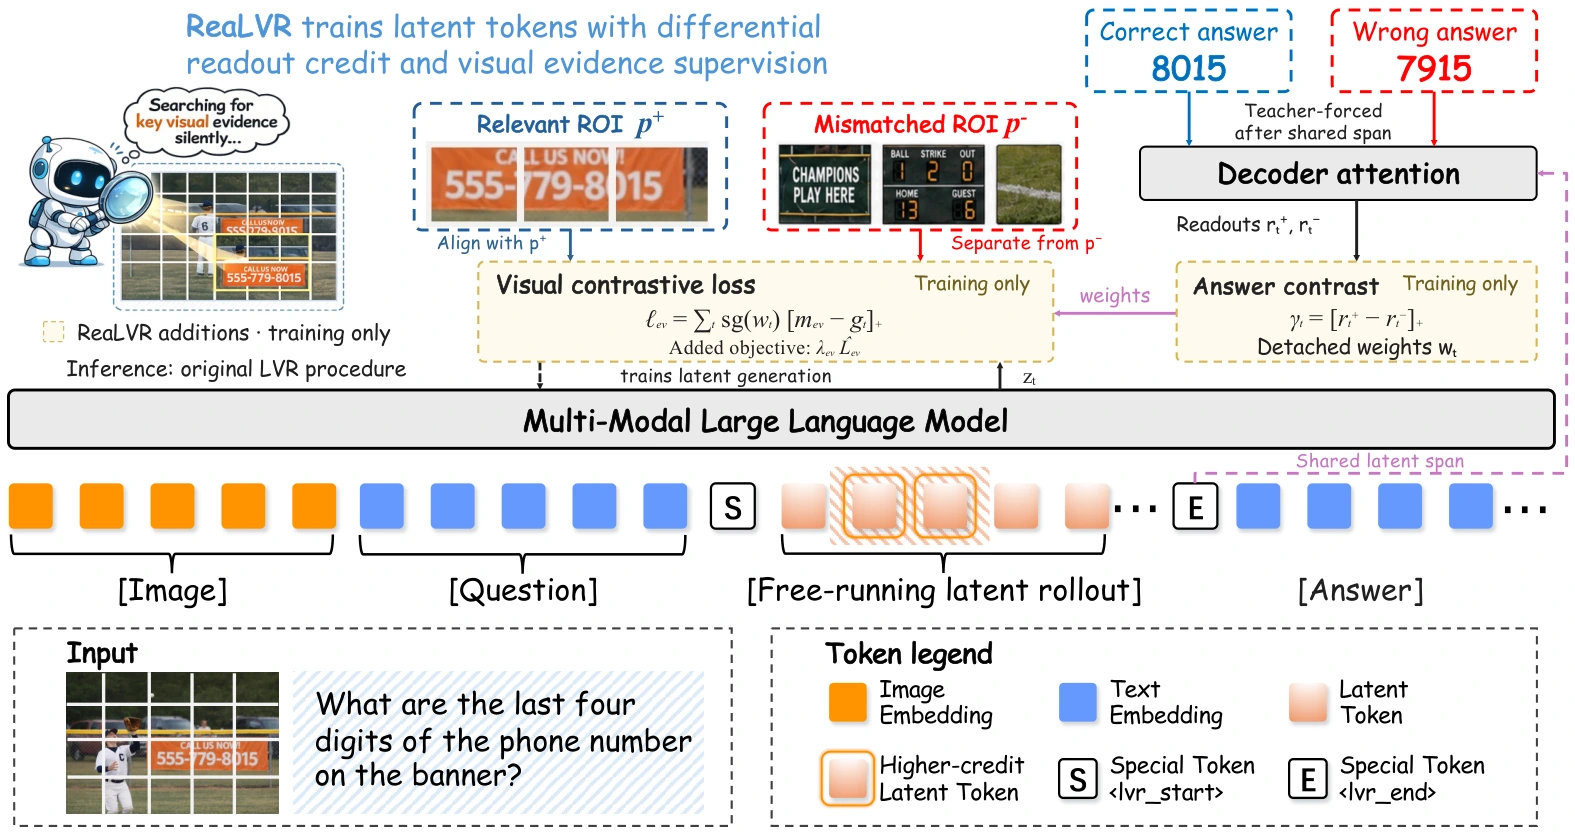
隐藏状态里多做几步计算,不代表模型更依赖图像。ReaLVR 用相关与错配视觉原型约束自由生成的潜在轨迹,再用正确和错误答案的读出差异分配监督。本文分析证据信用缺口、训练梯度、五项基准与干预实验,区分注意力变化和因果解释。
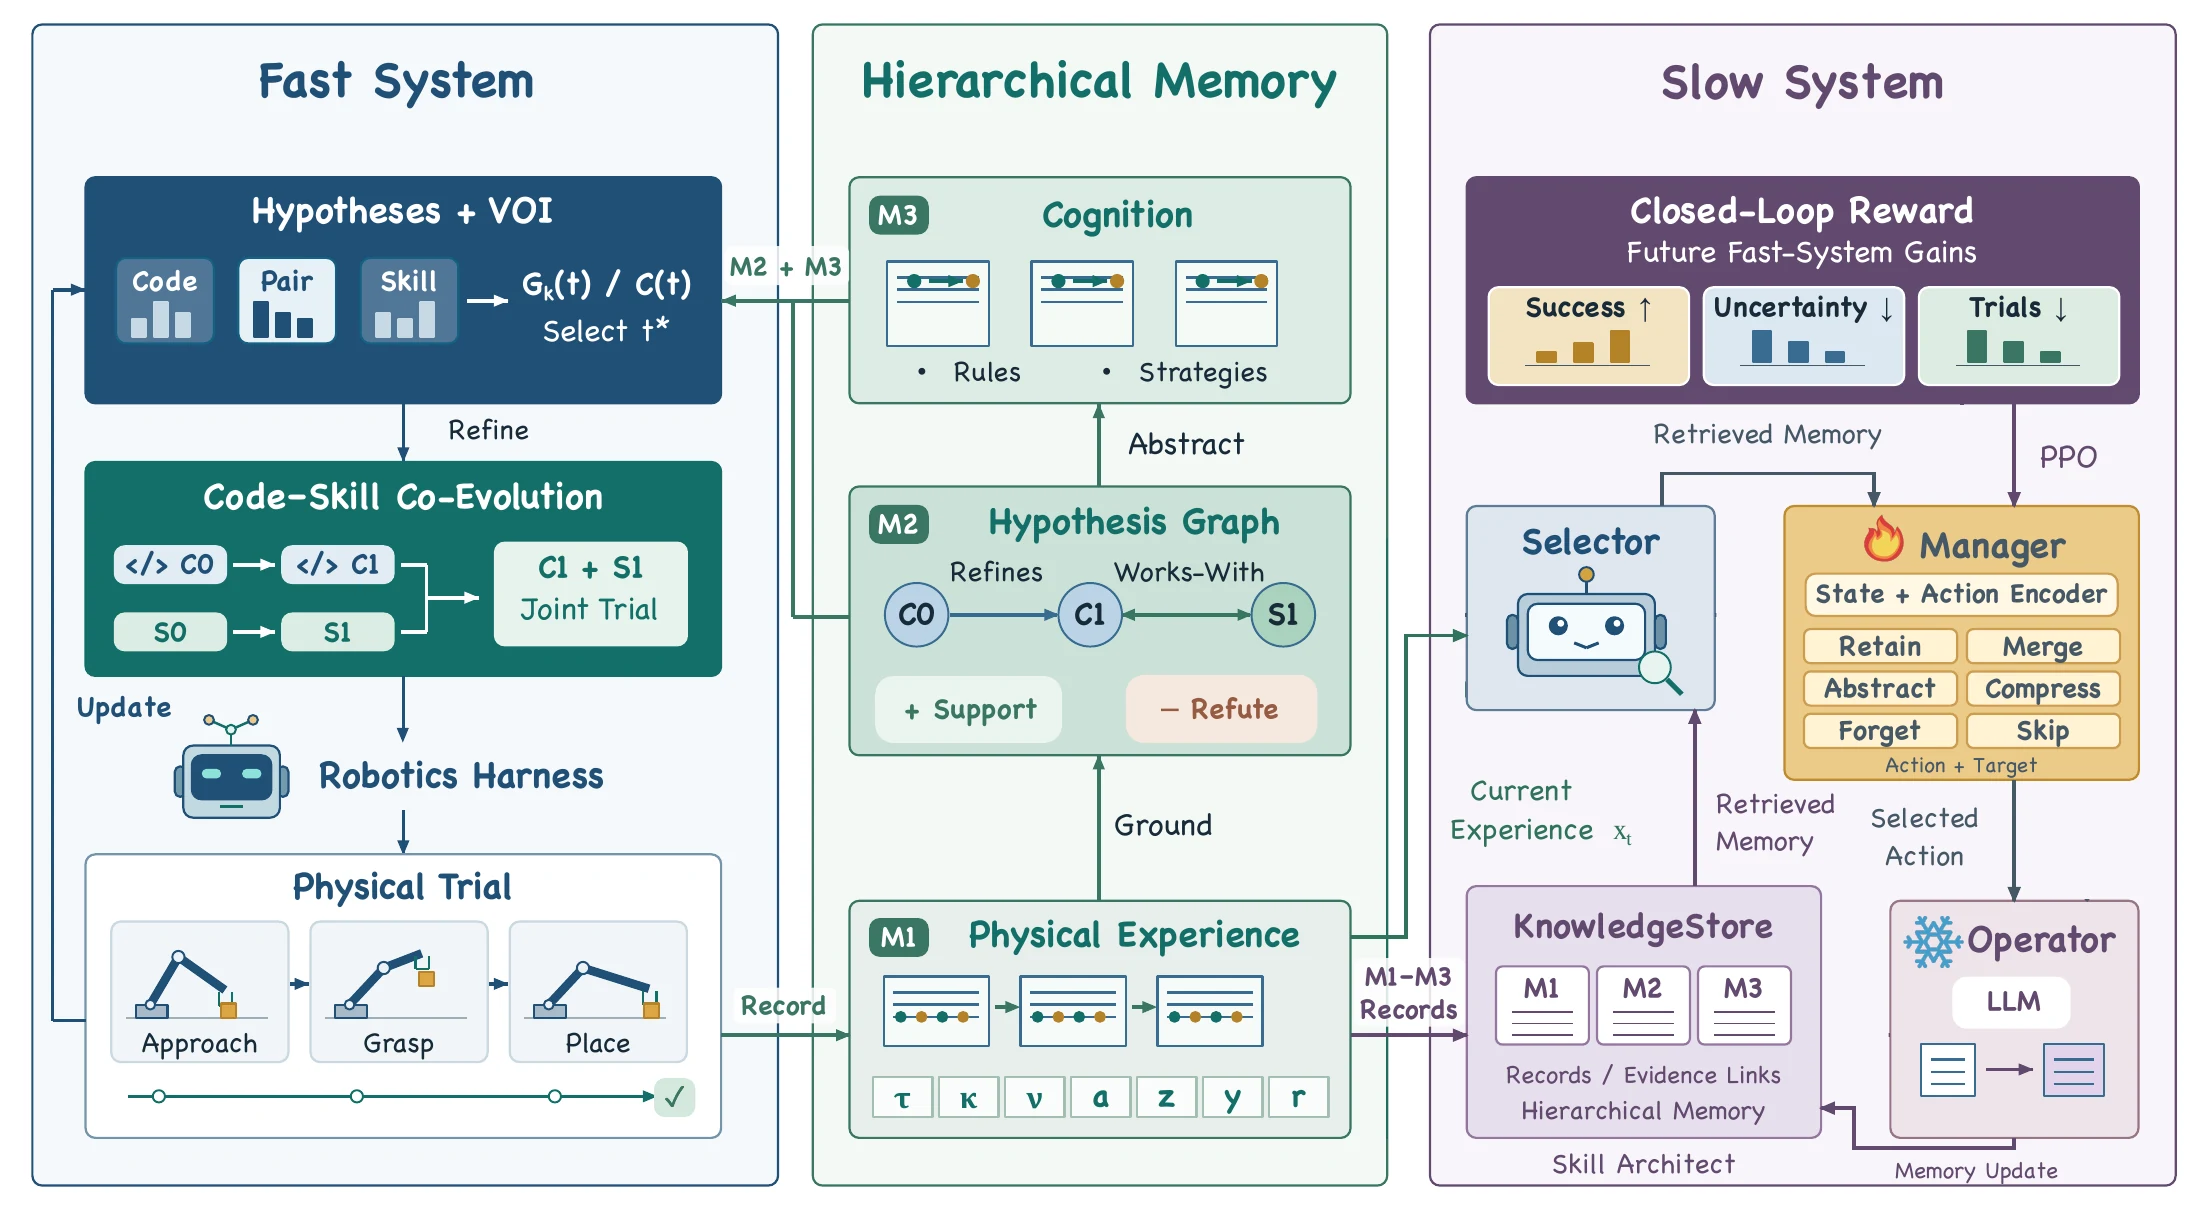
机器人每试一次,都应该让下一次改进更有依据。EmbodiedRSI 在冻结机器人基础模型的条件下,用假设图组织代码与技能的修改方向,按信息增益与成本选择实验,再通过强化学习保留有助于后续改进的记忆。本文拆解这套闭环,并分析仿真泛化、真机迁移和有限交互预算下的实验结果。
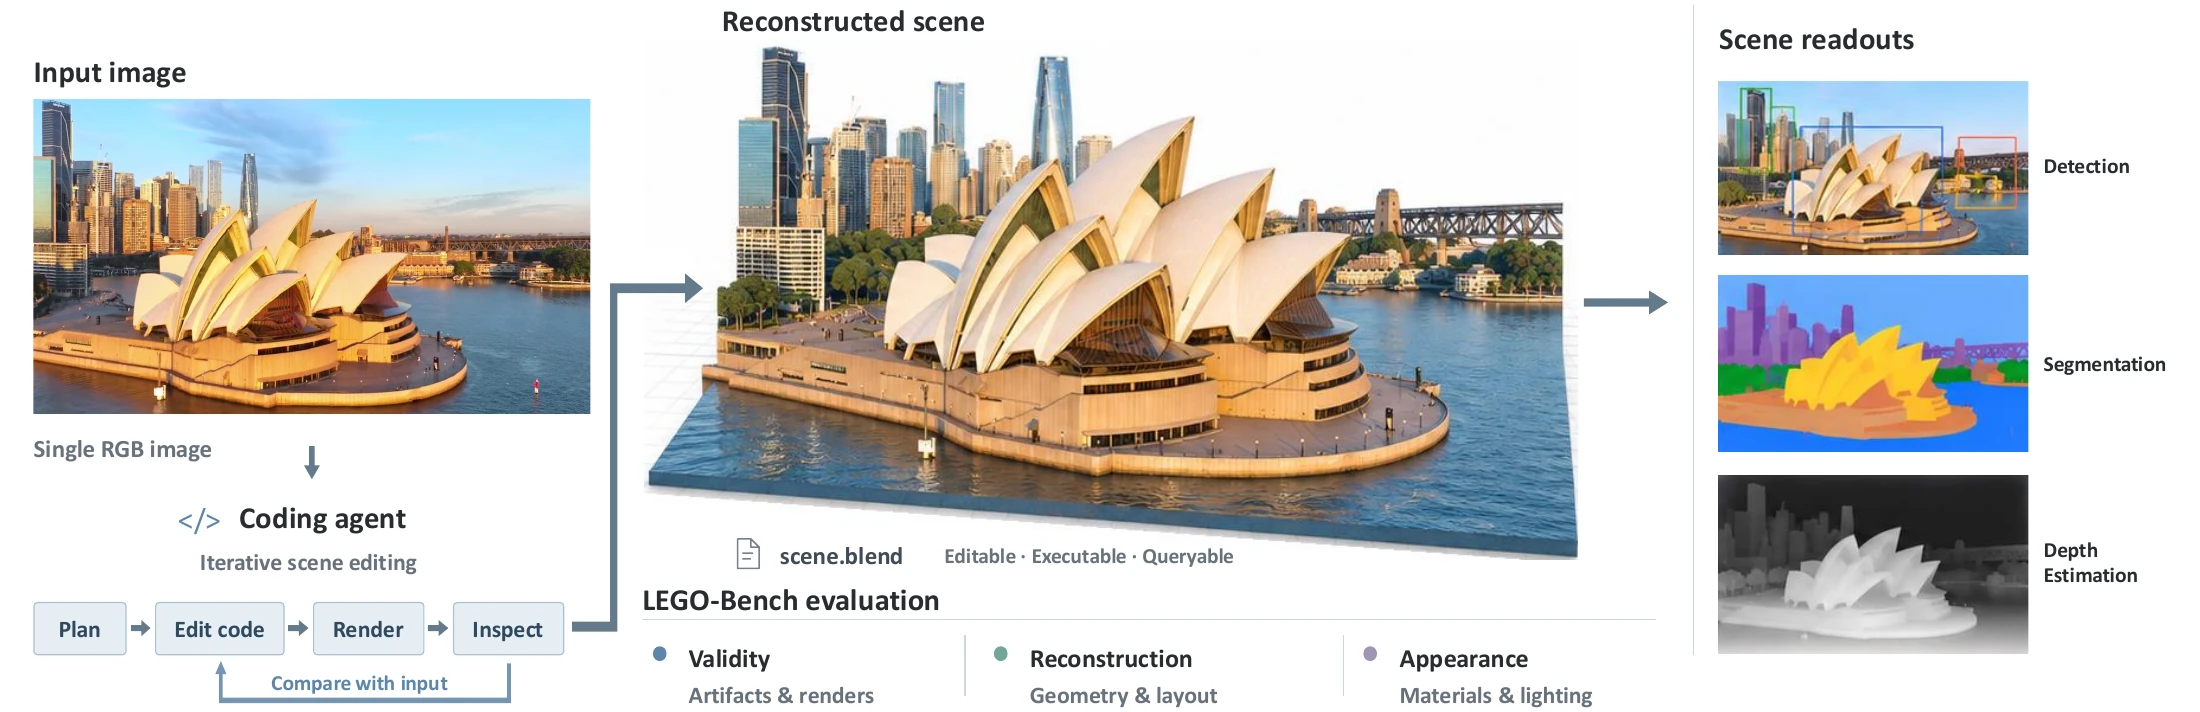
如果编程 Agent 理解了一张图像,能否把它写成可查询的三维场景?LEGO-Anything 将单图重建变成 Blender 程序构建,用几何与外观指标诊断迭代失败,再通过初始化、工具反馈和版本控制改善结果。本文分析这种表示的价值,以及它距离可靠的检测、分割和深度预测还有多远。
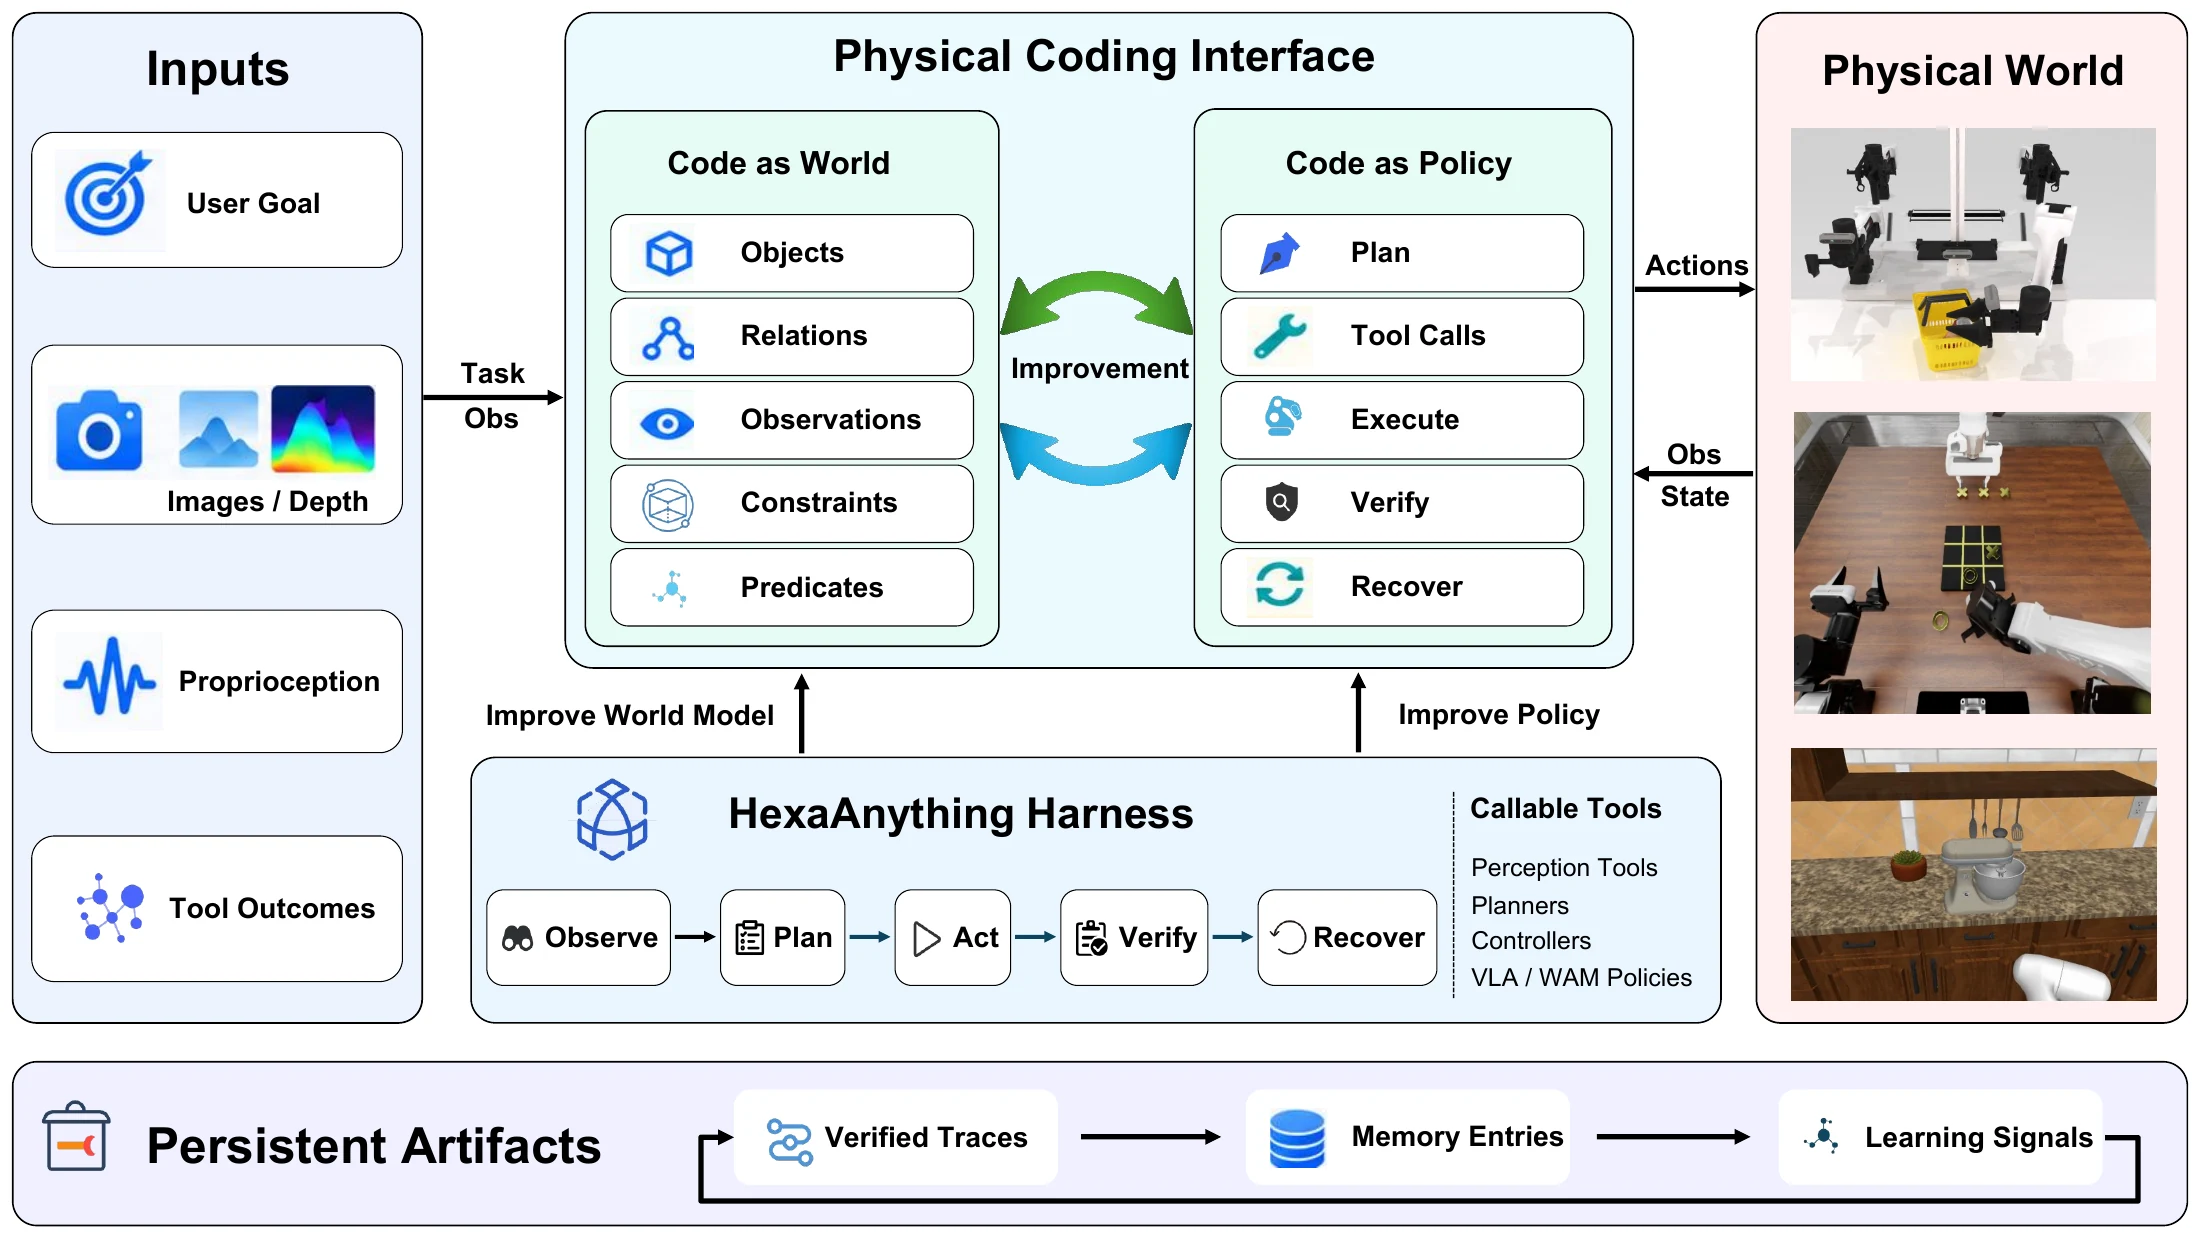
机器人执行结束后,留下的应该不只是动作轨迹。Self-Evolving Coding Agents 提出 Physical Coding,以世界程序维护状态与约束,以策略程序组织执行、验证和恢复,并用 HexaAnything 将通过验证的经验转化为工具修订与模型训练数据。本文分别分析执行框架、模型和工具的实验收益,以及当前自我进化证据的范围。
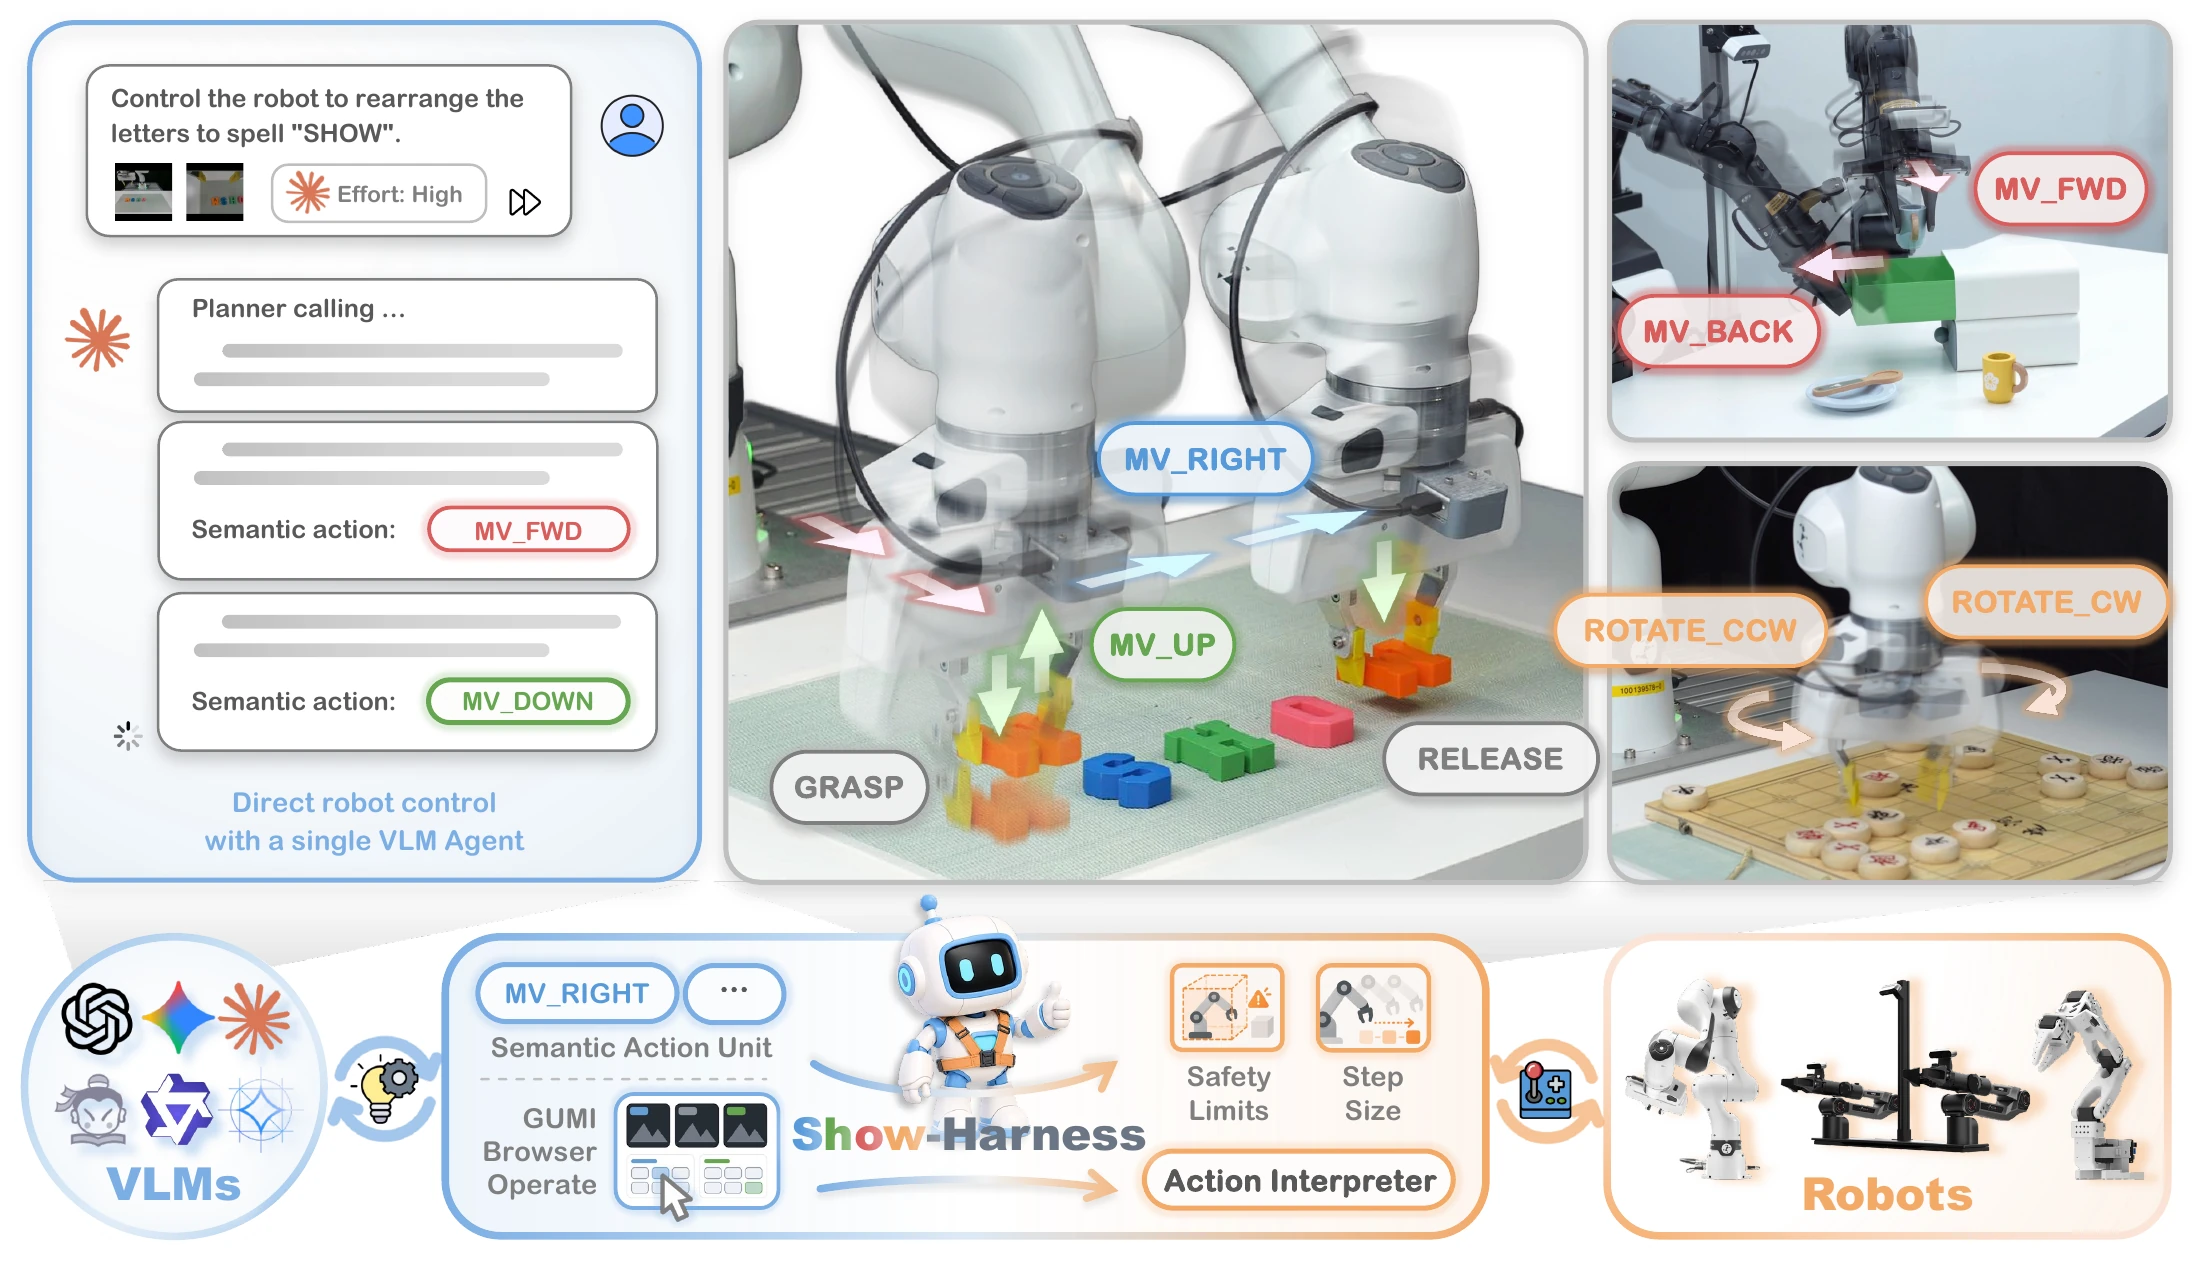
VLM 理解了任务,为什么仍难以稳定控制机器人?Show-Harness 将移动、旋转与抓放组织成可解释的动作单元,再由本体适配的解释器落实为运动。本文拆解这一接口、零样本与小模型微调两种模式,以及真实机器人实验对泛化、精度和响应速度的启示。
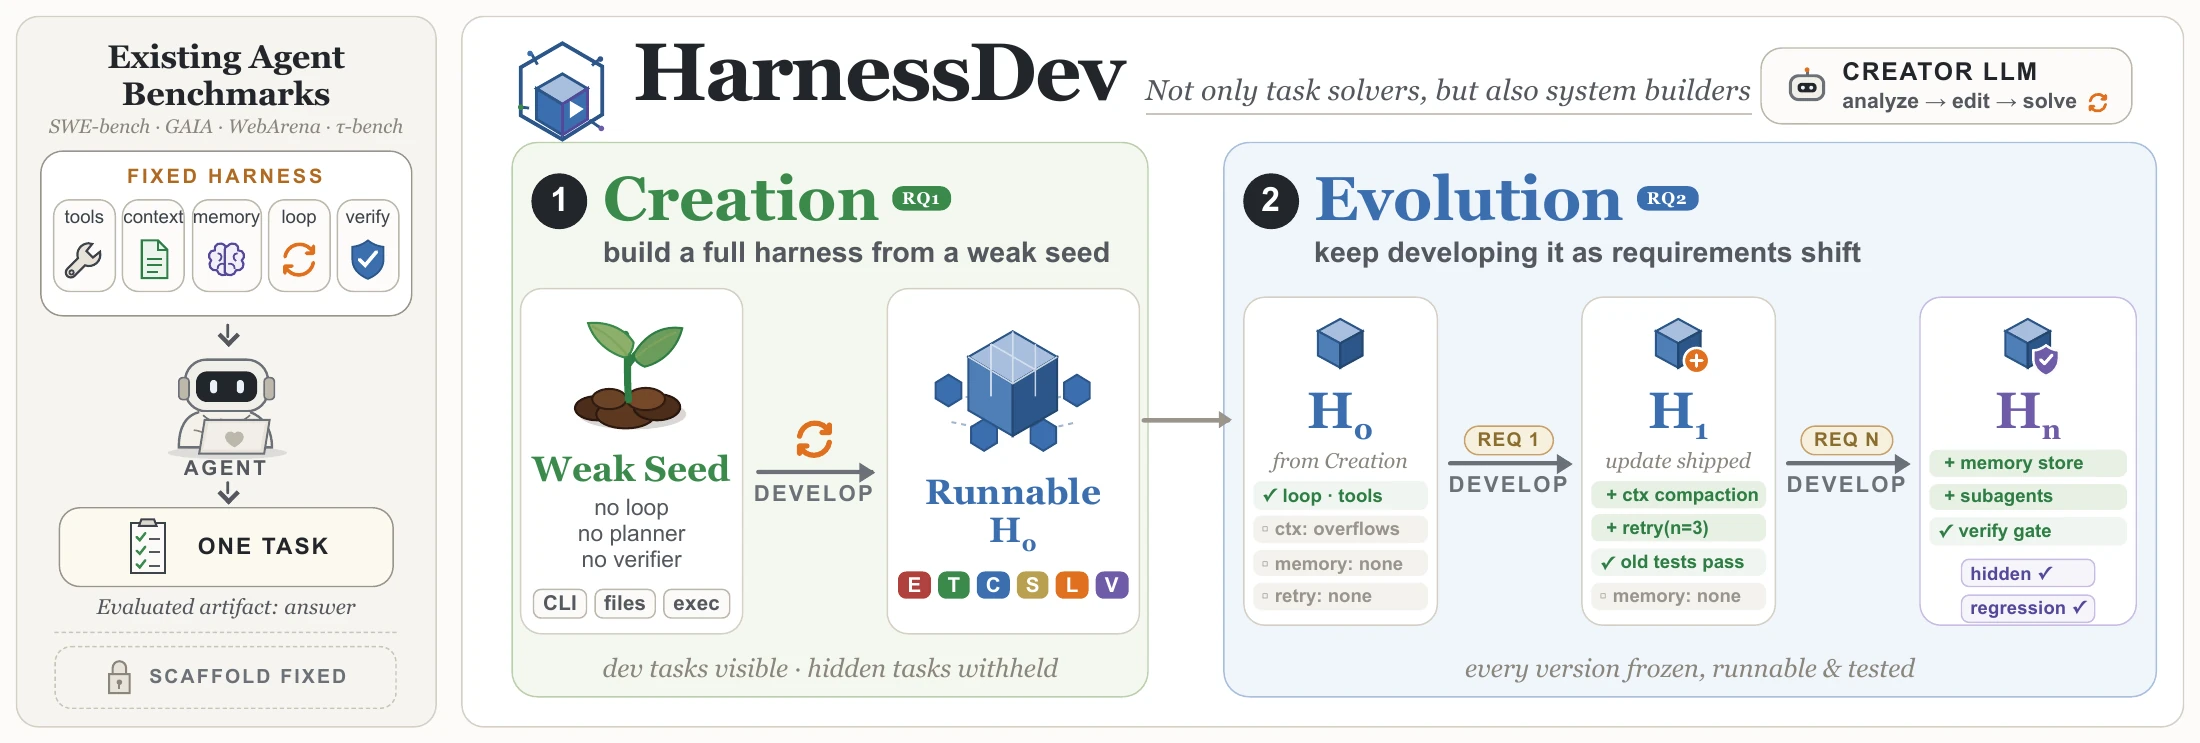
Agent 的能力有多少来自模型,又有多少来自执行框架?HarnessDev 把可运行、可复用的框架本身作为评测对象,分别检验从弱起点创建系统和根据执行反馈持续改进的能力。本文拆解创建者与执行者的分工、跨模型迁移,以及反馈集上的收益为何未必能保留到新任务。
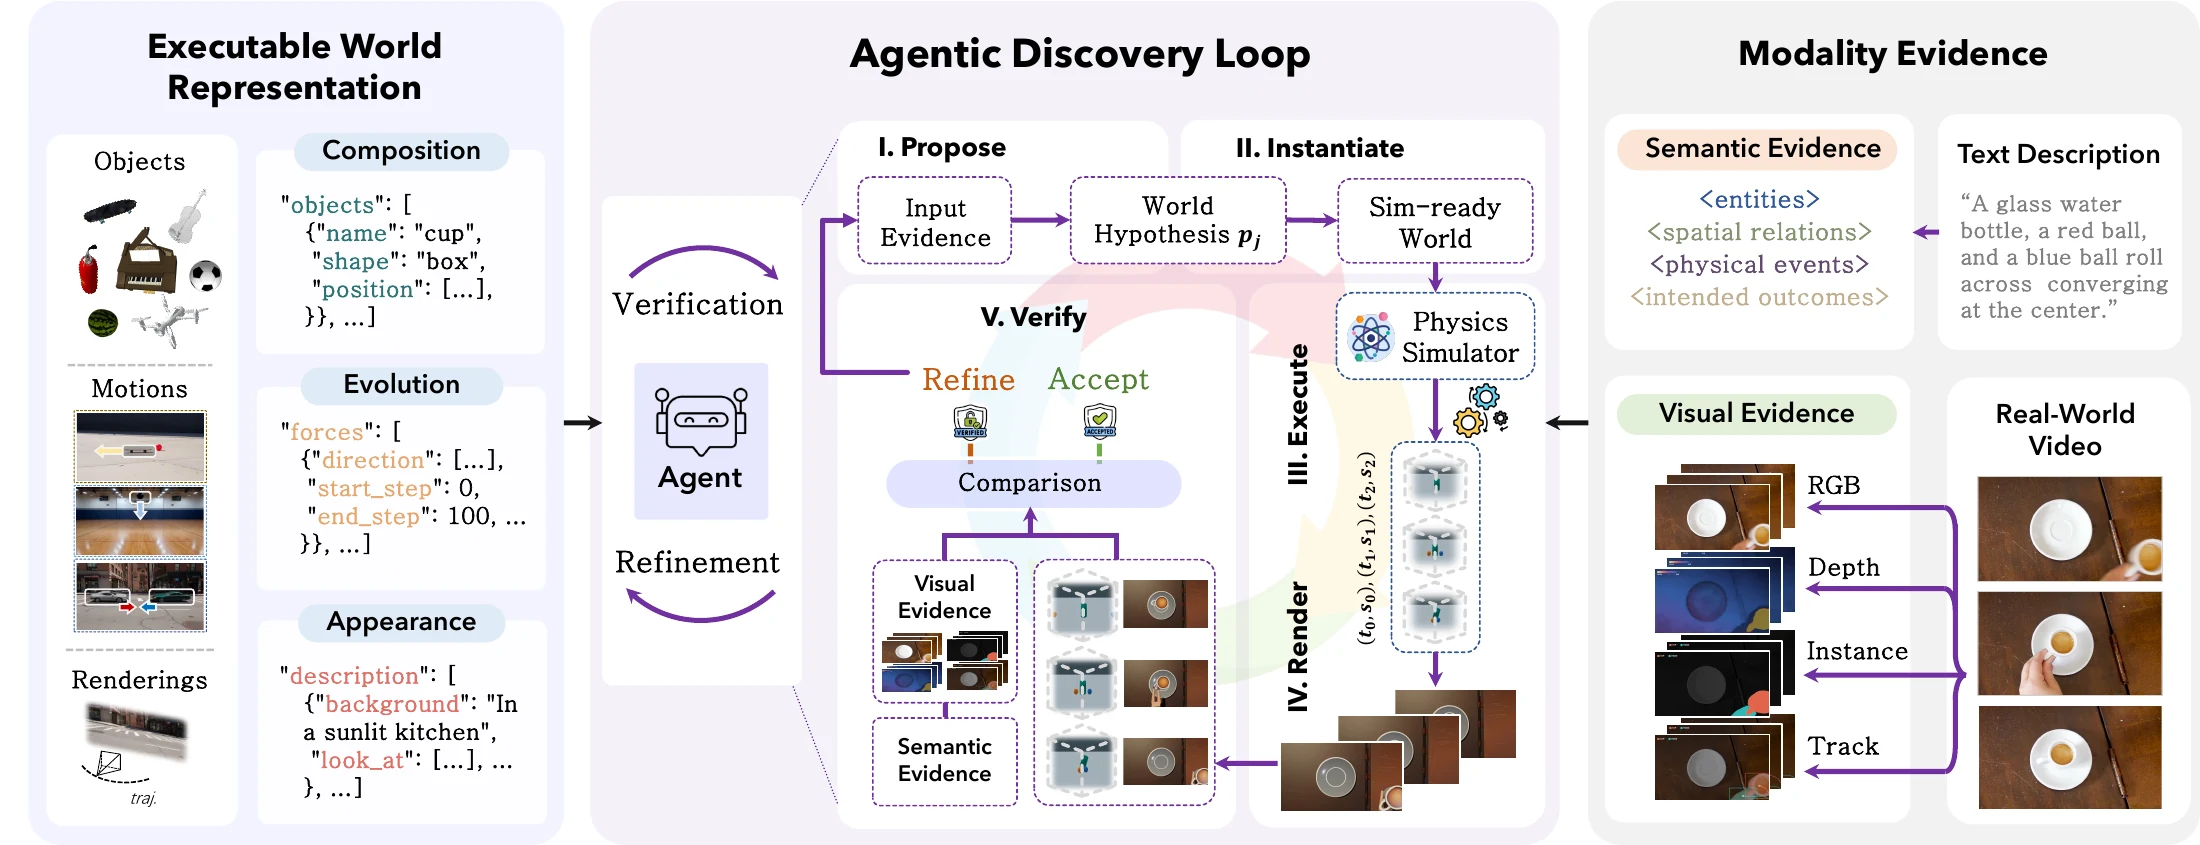
视频里发生了什么,与它为什么这样运动,是不同的问题。Code as Worlds 用代码分开表达世界构成、动态演化和视觉外观,通过执行与证据核对迭代世界假设,再从保留的世界中生成可量化的训练监督。本文分析这套发现流程、QuantiPhy 上的收益,以及轨迹拟合、物理机制和模型能力之间的边界。
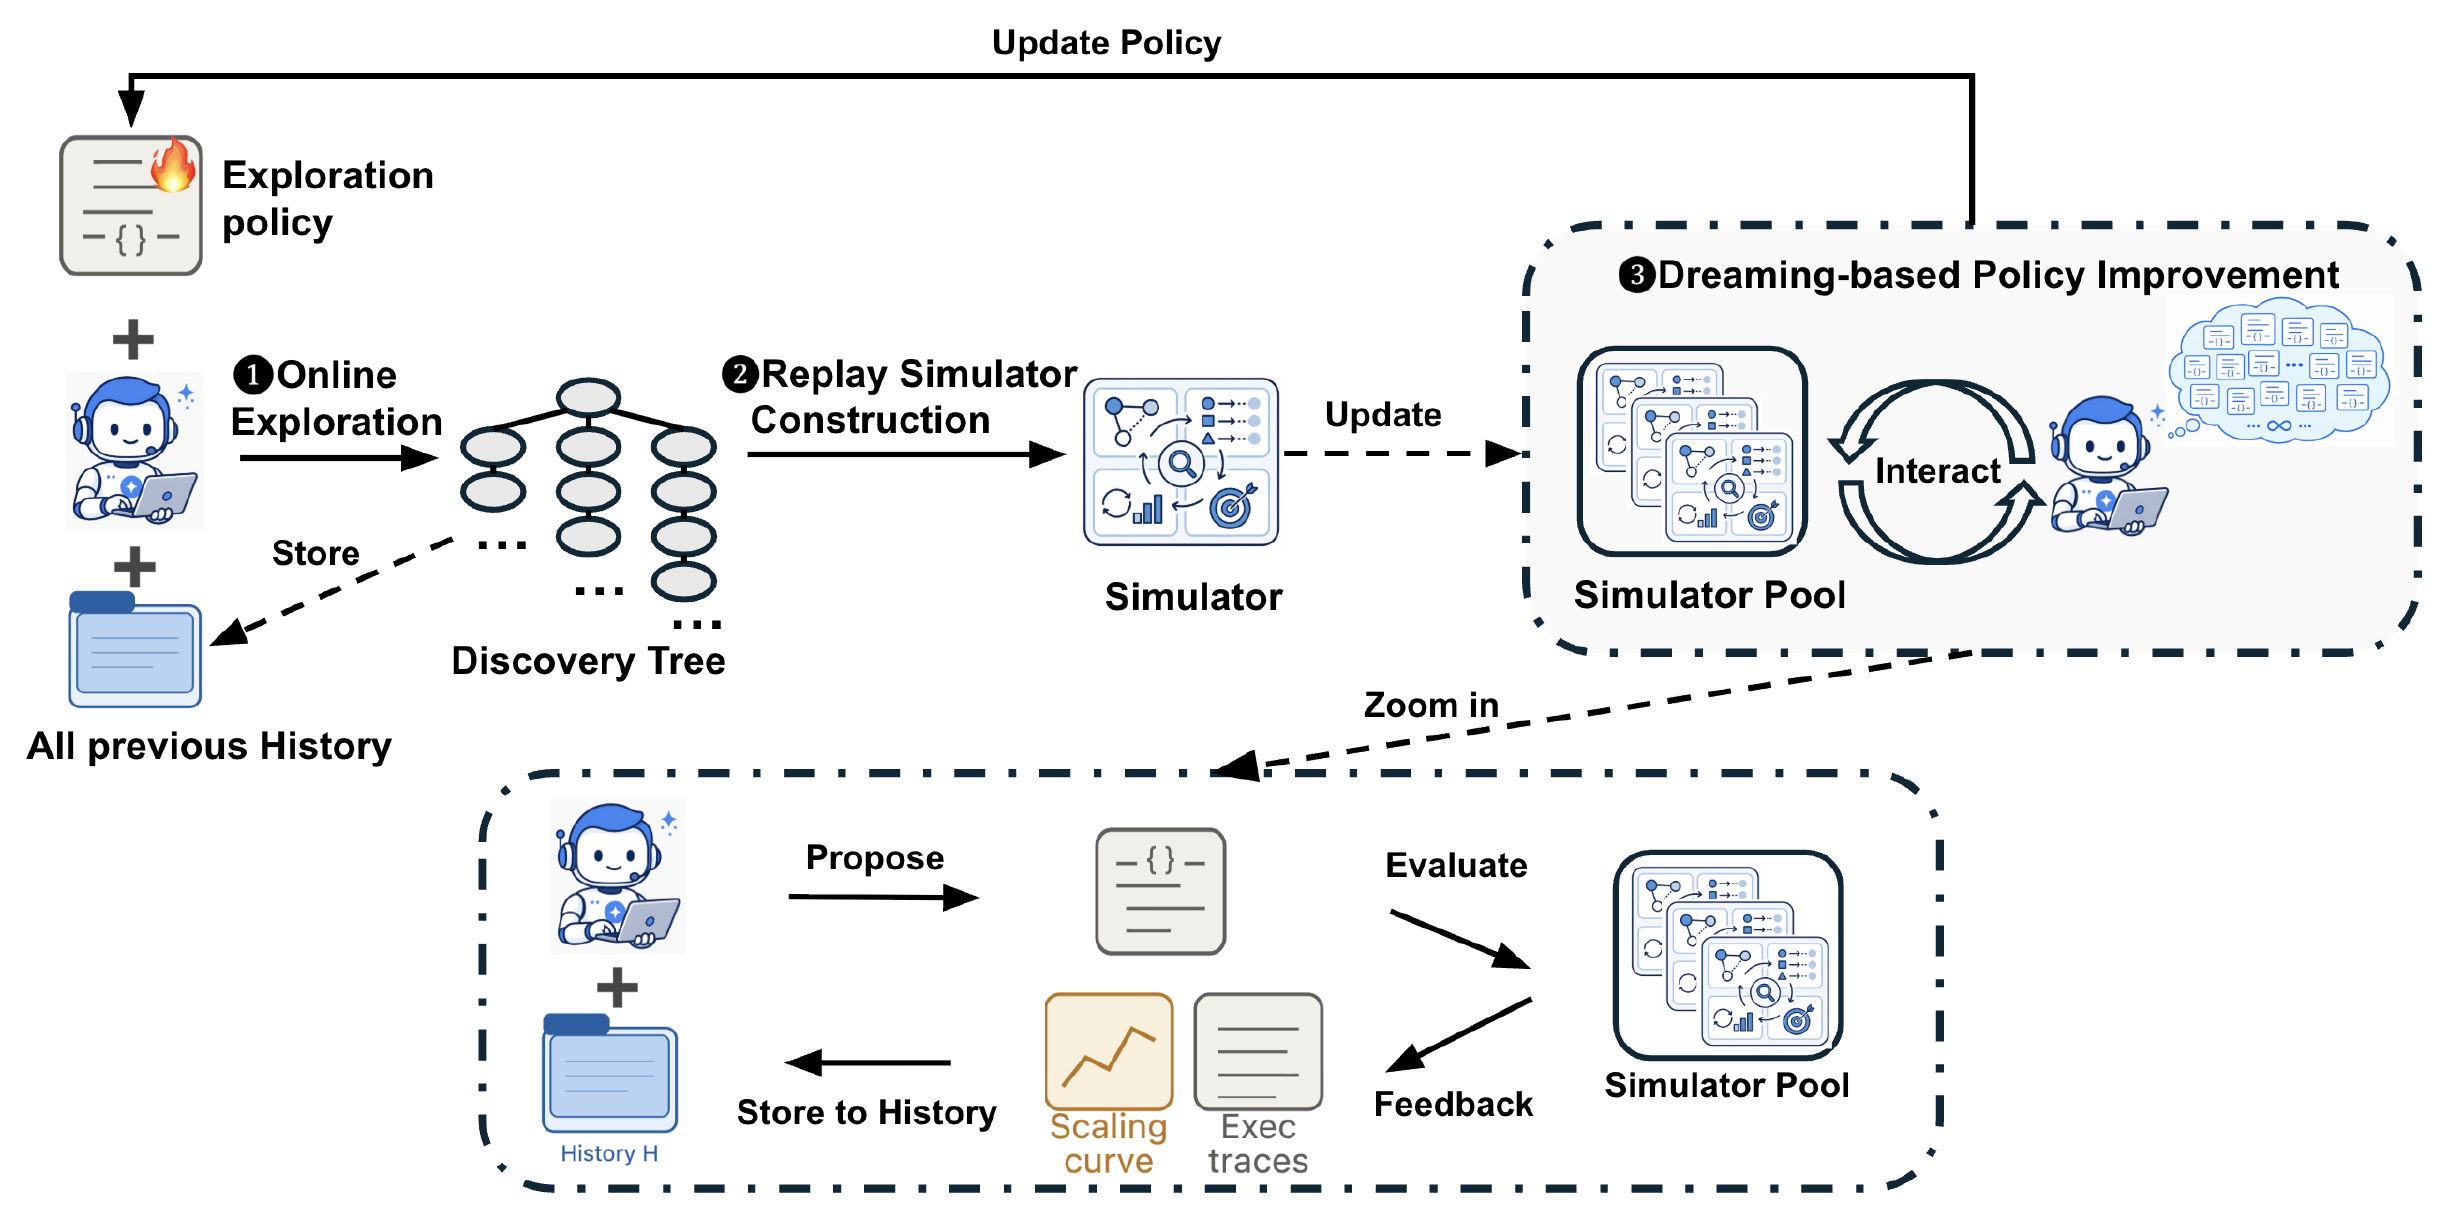
改进探索策略本身,为什么也需要昂贵的探索?Dream-RSI 将历史搜索树变成可回放环境,用低成本反馈改写探索策略,再投入下一轮真实搜索。本文拆解这一闭环的机制、质量与成本目标,以及历史回放的能力边界。