作者:Ziyan Jiang、Jingbo Yang、Jiabao Ji、Yujian Liu、Qiucheng Wu、Tommi Jaakkola、Yang Zhang、Shiyu Chang
单位: UC Santa Barbara、MIT CSAIL、MIT-IBM Watson AI Lab
1. Motivation:三维场景中的异常要怎样被发现?
悬浮椅子可能在一张图里就可见,穿墙却需要尝试移动;物体消失需要记住之前在哪里见过它,纹理随视角改变则要从多个位置对照。三维世界审计因此同时考察搜索、交互、记忆和视觉解释。
WorldAuditBench 将这些要求落实为可交互任务,让 Agent 在有限预算内探索场景、指出异常并交付支持画面。这里关注的是模型能否主动取得足以检验假设的证据。
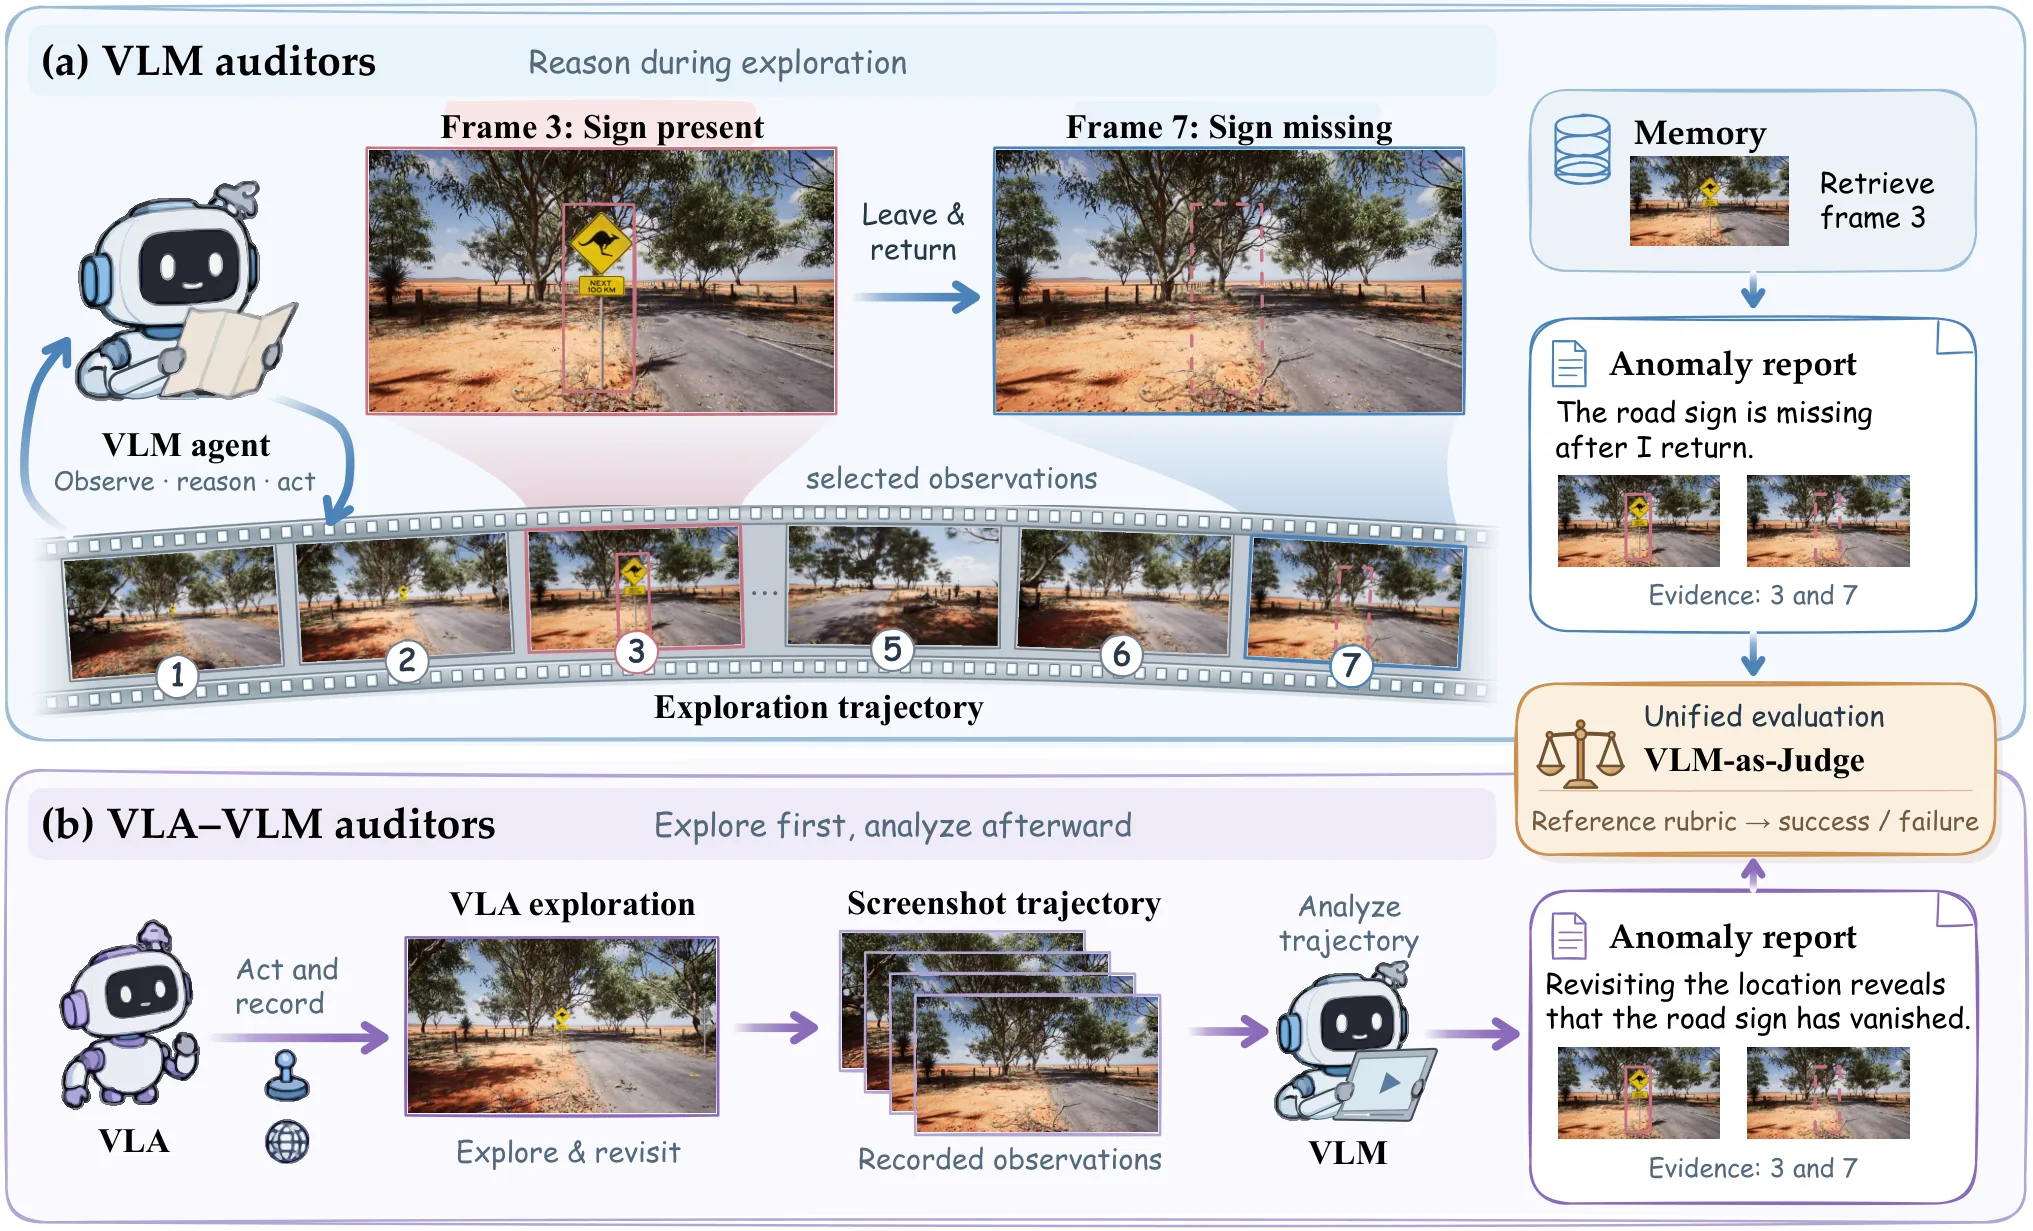
图 1. 两种审计流程及其证据获取方式。图源:原论文 Figure 3。
2. Insight:未发现异常,要区分没看到和没理解
2.1 单帧覆盖不足以证明证据充分
相机朝向过一个位置,不代表已经暴露了时序异常。判断物体是否消失,需要匹配前后画面;验证穿墙,需要接触或移动。论文因此分别用几何覆盖和人工观看探索视频判断异常是否被充分暴露。
2.2 下一步动作应由当前疑点决定
先走完固定路线、再分析视频比较便宜,却无法根据中途疑点补充观察。交互 VLM 可以回到原位置、换视角或打开物体,再把结果与此前记录关联。这是主动感知的实际价值,也意味着成功率同时依赖工具和执行框架。
3. Method:任务、提示与两条审计路线
3.1 213 个任务,五类异常
数据来自 13 个环境、27 个场景,126 个任务用 Unreal Engine 5,87 个用 Three.js。作者手工修改原本正常的场景,覆盖静态物理、交互物理、空间一致性、时间一致性和语义一致性五类、十五个子类。
每个主评测任务只放一个标注异常,独立验证者检查其可见性与类别,至少两人对同一版本判定 Pass 才接受。这个过程提高了任务可验证性,但异常来自人工设计,不是自然运行中发现的任意游戏 bug。
3.2 主评测已提供搜索方向
Agent 初始接收场景描述、异常类型提示和匹配的 in-context 示例,输出异常报告及支持画面。它可以移动、改变视角、交互、取回历史帧、记笔记与修订报告。
因此,主结果测的是“已知存在一处某类异常时能否找到”,不是从任意正常或异常场景中自主审计。缺少无异常任务,也就不能从成功率直接推出误报率或正常世界特异性。
3.3 两条路线的探索预算不同
VLM-only 在探索中直接推理并选择动作,使用 40 次环境动作;VLA–VLM 由 Open-P2P 1.2B 先记录 60 秒仿真探索,每 0.5 秒采样画面,再交给 VLM 分析。不同 VLM 使用同一条 VLA 记录。
两路线并不共享等量环境步骤。五个 VLM 还分别使用各自的 CLI harness,故跨模型结果反映模型与框架的组合。最终报告由 GPT-6 Astra 根据标注 rubric 和证据判断。
4. Experiments:能力上限、提示依赖与证据诊断
4.1 交互探索通常更成功,也更贵
原论文 Table 2 摘录如下:
| 审计者 | VLM-only 成功率 | VLA–VLM 成功率 |
|---|---|---|
| GPT-6 Astra | 42.3% | 16.4% |
| Claude Opus 5 | 28.2% | 15.0% |
| Gemini 3.8 Flash | 32.4% | 17.4% |
| Muse Spark 1.3 | 15.0% | 6.6% |
| Qwen 3.8 Flash | 8.5% | 12.7% |
Qwen 的固定轨迹路线反而更高,所以主动路线不是对每个模型都占优。Astra 的推理费用从固定轨迹的 0.281 美元/任务到交互路线的 2.955 美元/任务;成本下降和成功率下降共同存在。
人工成功率为 83.4%,每任务两名参与者、最多十分钟,并使用相同 judge 评价。人工时间预算与机器动作预算不同,这个差距提供背景,不能视为严格同资源的人机排名。
4.2 异常类型提示明显影响搜索
Gemini 在 126 个 Unreal 任务的交互默认成功率为 33.3%。只去掉示例为 31.0%,再去掉类型提示为 15.9%。将预算减半降至 23.0%,增加到 1.5 倍仅升到 34.9%。
这些结果说明知道搜索什么比简单加步骤更有帮助。不能把默认 33.3% 与全体 213 任务的 32.4% 混成同一基准的矛盾数字,它们的任务子集不同。
4.3 暴露率与识别率共同限制表现
Astra 的几何覆盖在交互与 VLA 探索中为 91.1%/47.4%,人工判断证据暴露为 68.1%/34.7%。几何覆盖只要求一个合格视角,人工暴露对空间和时序问题还要求配对证据,因此两者不是同一指标。
在双方几何覆盖的任务上,交互和固定轨迹识别成功率为 38.5%/26.0%;按人工暴露条件化后为 62.1%/47.3%。交互优势不只来自到达目标,也来自补充和连接证据。但条件化集合与原始全任务分母不同,不能把 62.1% 当成全榜成功率。
4.4 多异常难以完整发现
多异常实验保留 21 个 anchor 任务,每个条件生成 42 次运行。两处异常全部找到仅 3/42,三处仅 2/42;目标召回约 30%,即使 anchor 成功率基本保留,也大量遗漏额外异常。
这使“找到了一个疑点”和“审计完整”明确分开。主评测每场景一个目标,尚不能覆盖真实复杂世界的多异常召回与误报权衡。
5. Conclusion
WorldAuditBench 把三维理解落实到可检验的探索行为:先提出疑点,再用视角、交互和记忆取得证据,最后让报告接受独立规则检查。它提供的暴露与识别拆分,比单一成功率更能定位系统短板。
后续可增加正常场景、隐藏异常数量,固定跨路线探索成本,并对评审器进行人工校准。这样才能进一步评价模型是否既发现真实异常,又避免把陌生但合理的场景误判为错误。
References
- WorldAuditBench: Interactive 3D World Auditing with Multimodal Agents, arXiv:2609.40325v1, 2026-09-30.