作者:Fang Wu、Da Xing、Yanjie Huang、Junxi Wang、Ji Wang、Hejia Geng、Guancheng Wan、Bowen Zuo、Xiaomin Li、Shixiang Tang、Xinyu Xiang、Zehong Wang、Shiyi Du、Peng Xia、Shuangjia Zheng、Yining Hong、Li Erran Li、Jure Leskovec、Yejin Choi
单位: Stanford University、Johns Hopkins University、Independent Researchers、University of Toronto、University of Oxford、UC Riverside、MatrAIx、University of Notre Dame、Carnegie Mellon University、UNC Chapel Hill
1. Motivation:一次反思修好了图,下一次还会犯同样的错吗?
图像生成器可能把“两只红杯子”画成三只。视觉理解模型可以指出数量错误,再改写提示让第二次生成满足约束。但如果这段纠错只留在当前上下文,下一次直接使用原提示时,生成器仍可能重复失败。
UniEvo-VL 希望将纠错经验写入生成器参数:训练时让教师看到包含修正信息的提示,学生只看原始请求,在学生自己的采样轨迹上匹配两者的局部生成预测。最终评估直接生成是否改善,并单独计算部署时再反思一次的收益。
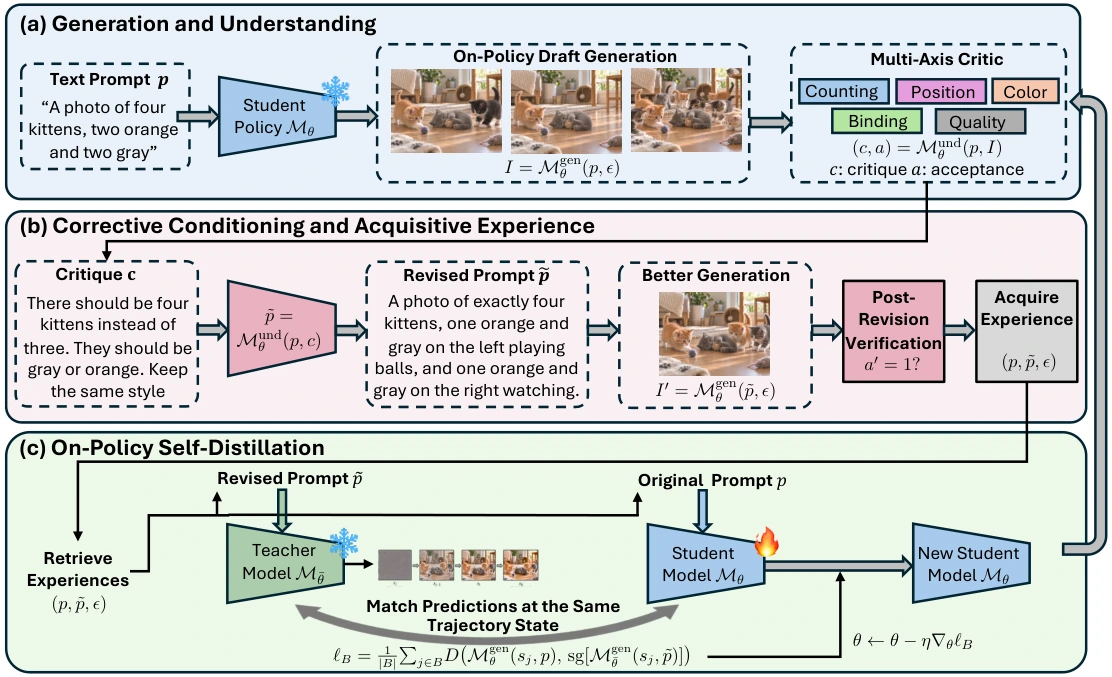
图 1. 固定批评器构造修订提示,EMA 教师提供局部转移目标,学生生成器 LoRA 接受更新。图源:原论文 Figure 2。
2. Insight:把修正信息作为教师的额外条件
2.1 同样的参数家族,也能因上下文不同形成教学信号
教师不一定需要独立训练成更强的生成器。它看到了当前失败产生的修订提示,而学生只得到原请求,这个信息差可能让教师的去噪方向更接近满足约束的输出。
蒸馏目标在学生实际经过的状态上计算,减少学生轨迹与教师监督位置的错位。学生学习的是从普通提示出发的修正能力,而不是部署时必须使用更长提示才能取得收益。
2.2 “统一”需要结合实际更新范围理解
论文实现使用 Qwen-Image-2512 生成器和固定的 Qwen-VL 反馈流水线,只更新生成器 LoRA,且对 GenEval、GenEval2、OCR 分别训练。理解模块与生成模块并没有在这个实验中同步自我更新。
因此,证据支持的是视觉批评如何改进生成器,不能据此推断同一套完全统一的模型已经同时提高生成、理解和评审能力。外部 GPT-5.6-Luna 批评器实验还直接引入了更强反馈来源。
3. Method:获取有效修订,再进行 on-policy 蒸馏
3.1 原图、批评和修订提示组成经验
生成器先用原提示与随机噪声产生草稿。批评流水线沿语义、文字和视觉质量检查输出,给出具体偏差及接受/拒绝判断。已经满意的草稿跳过;空白或不可用反馈也移除。
对需要修正的草稿,模型把原请求和批评合成为可独立执行的修订提示,例如明确“恰好两只红杯子”,同时保留场景与颜色。批评中的“当前多了一只杯子”必须转化为目标画面的正面描述,才能作为教师生成条件。
3.2 验证的是原意是否满足
可选验证分支使用同一初始噪声、修订提示再生成一张图,并继续对照原始请求评价。只有修订有效且新图被接受时,才保留原提示、修订提示和噪声组成的训练样本。
第二张图用于过滤,不作为主方法的图像重建目标。这样可以区分“批评器说这段修订有用”和“修订后确实通过了检查”;同一噪声也控制了随机采样差异。
3.3 学生匹配教师在相同状态上的局部转移
学生从原提示出发生成轨迹;EMA 教师在相同的学生状态上接收修订提示。flow 实现通过局部潜变量转移的平方距离训练学生,可理解为对相应 flow/去噪预测做匹配。
采样状态和教师目标停止梯度,批评、修订和验证过程也不反向传播。教师按 EMA 更新,衰减为 0.999。梯度只流向学生生成器 LoRA,不需要可微图像奖励,也不使用标量奖励进行策略优化。
3.4 经验获取并不免费
验证分支的接受率约为 10%–21%,取得一个有效样本大约需要 5–10 次尝试,每次可能包含额外生成和批评。部署时直接生成可以免去反思,但训练获取经验和教师计算仍有成本,不能只报告最终推理节省。
4. Experiments:直接收益、反思余量与局部退步
4.1 验证能改善结果,批评来源影响不同任务
原论文 Table 1 的 native 指标如下。GenEval 与 OCR 使用 0–1,GenEval2 的 Soft-TIFA GM 使用 0–100:
| 配置 | GenEval | GenEval2 | OCR |
|---|---|---|---|
| Base | 0.747 | 32.58 | 0.771 |
| Qwen 批评,无修订后验证 | 0.808 | 32.37 | 0.761 |
| Qwen 批评,有修订后验证 | 0.818 | 35.07 | 0.790 |
| GPT-5.6-Luna 批评 | 0.882 | 35.53 | 0.775 |
验证版 Qwen 在三个 native 指标上都超过表中 Base,无验证版本却在 GenEval2 与 OCR 退步。更强的外部批评器获得最高 GenEval、GenEval2 分数,OCR 仍低于验证版 Qwen,反馈质量的作用不是跨任务统一的。
摘要引用 GenEval2 的 32.97 → 35.53;正文说明 32.97 来自对应 Luna 配置的基准,而 Table 1 汇总 Base 为 32.58。这里统一摘录 Table 1,避免把不同评测批次的起点拼在一起。
论文另报告 Gemini 原子约束检查和 HumanPref。后者是自动视觉质量代理分数,不是实际招募用户得到的人类偏好实验;它与 native 语义指标也可能有不同排序。
4.2 训练吸收了部分反思收益,反思仍有价值
Table 2 使用配对提示和种子,单独比较原模型与验证版 UniEvo-VL:
| 任务 native 分数 | Base 直接 | Base 加一次反思 | 训练后直接 | 训练后加一次反思 |
|---|---|---|---|---|
| GenEval | 0.748 | 0.826 | 0.818 | 0.848 |
| GenEval2 | 31.92 | 42.52 | 35.07 | 46.23 |
| OCR | 0.769 | 0.783 | 0.790 | 0.803 |
训练后直接生成在 GenEval 接近原模型反思成绩,在 OCR 超过它,却在 GenEval2 仍有较大差距。训练没有吸收所有任务的完整反思收益。
双方都反思一次时,训练后 native 指标仍更高,说明收益不只是部署时提示改写。与此同时,GenEval2 仍明显受益于额外反馈,训练内化和推理反思可以互补。表中基准与 Table 1 使用不同配对评测批次,应在各自表内比较。
4.3 难题改善伴随容易样本的小幅遗忘
作者按原模型得分把历史 500 提示子集分为 Hard 与 Easy,并固定分组。收益集中在原先低分样本,Easy 在归一化 0–100 量表上仍下降约 1–4 分。
训练采集会跳过已满意草稿,更重视失败,因此难题有更多纠正机会;但两组提升空间本来不同,不能把全部差异归因于过滤策略。这个结果说明需要同时报告恢复失败与保留已有能力,而不只挑选改善案例。
4.4 独立评审与统一检查点仍是后续问题
三个任务的成绩来自分别训练的 LoRA,不是一个检查点同时取得全部分数。评估不给训练奖励,但批评器仍决定哪些错误能被发现、哪些样本能进入训练。
如果经验获取和效果评估共享判断弱点,成绩可能遗漏某些错误。合理的后续检查是增加独立人工审计、保留易题与跨任务测试,以及测量多轮更新是否持续有效。
5. Conclusion
UniEvo-VL 的价值在于将“这一次应怎样修正”转化为普通提示下也可获得的参数收益。修订后验证、学生轨迹上的转移匹配和直接/反思配对评测,共同使这个问题可检验。
现有证据支持任务内生成能力提升,也揭示无验证退步、易题遗忘和额外反馈成本。若要进一步成为稳定的持续学习系统,还需要检查统一模型的能力保留、批评偏差和多轮学习的累积效果。
References
- UniEvo-VL: An On-policy Self-Distillation Training Recipe for Multimodal Model Self-improvement, arXiv:2609.38721v1, 2026-09-30.