作者:Yanzhe Chen、Zechen Bai、Zhijun Cao、Wenzheng Zeng、Kevin Qinghong Lin、Yiqi Lin、Guoqiang Liang、Kevin Yuchen Ma、Qiming Huang、Mike Zheng Shou
单位: Show Lab, National University of Singapore
1. Motivation:语义判断与连续控制之间,应该放什么接口?
让 VLM 根据图像判断“应该把哪个物体放进碗里”,与让它决定下一步末端位姿,是两个不同难度的问题。连续控制需要处理坐标、尺度、运动范围和机器人本体;这些变量很难直接从语言预训练中获得。若只让模型调用完整的抓取或放置技能,很多物理细节又被封装到了技能内部,模型难以在中途根据观察做细致调整。
Show-Harness 的切入点是动作接口:让 VLM 输出“向前一步”“向下一步”“闭合夹爪”等离散语义动作,再由机器人专用解释器把这些动作落实为小幅、受约束的运动。模型保留逐步选择与纠错的责任,同时不必直接生成底层关节命令。
这种设计也把两条路线放到了共同接口上:前沿 VLM 可以直接根据观察选择动作;小型开源 VLM 则可以从示范中学习预测相同的动作词。研究问题因此变成:哪些控制困难可以通过接口与反馈解决,哪些仍然需要专门数据和更强的感知能力?
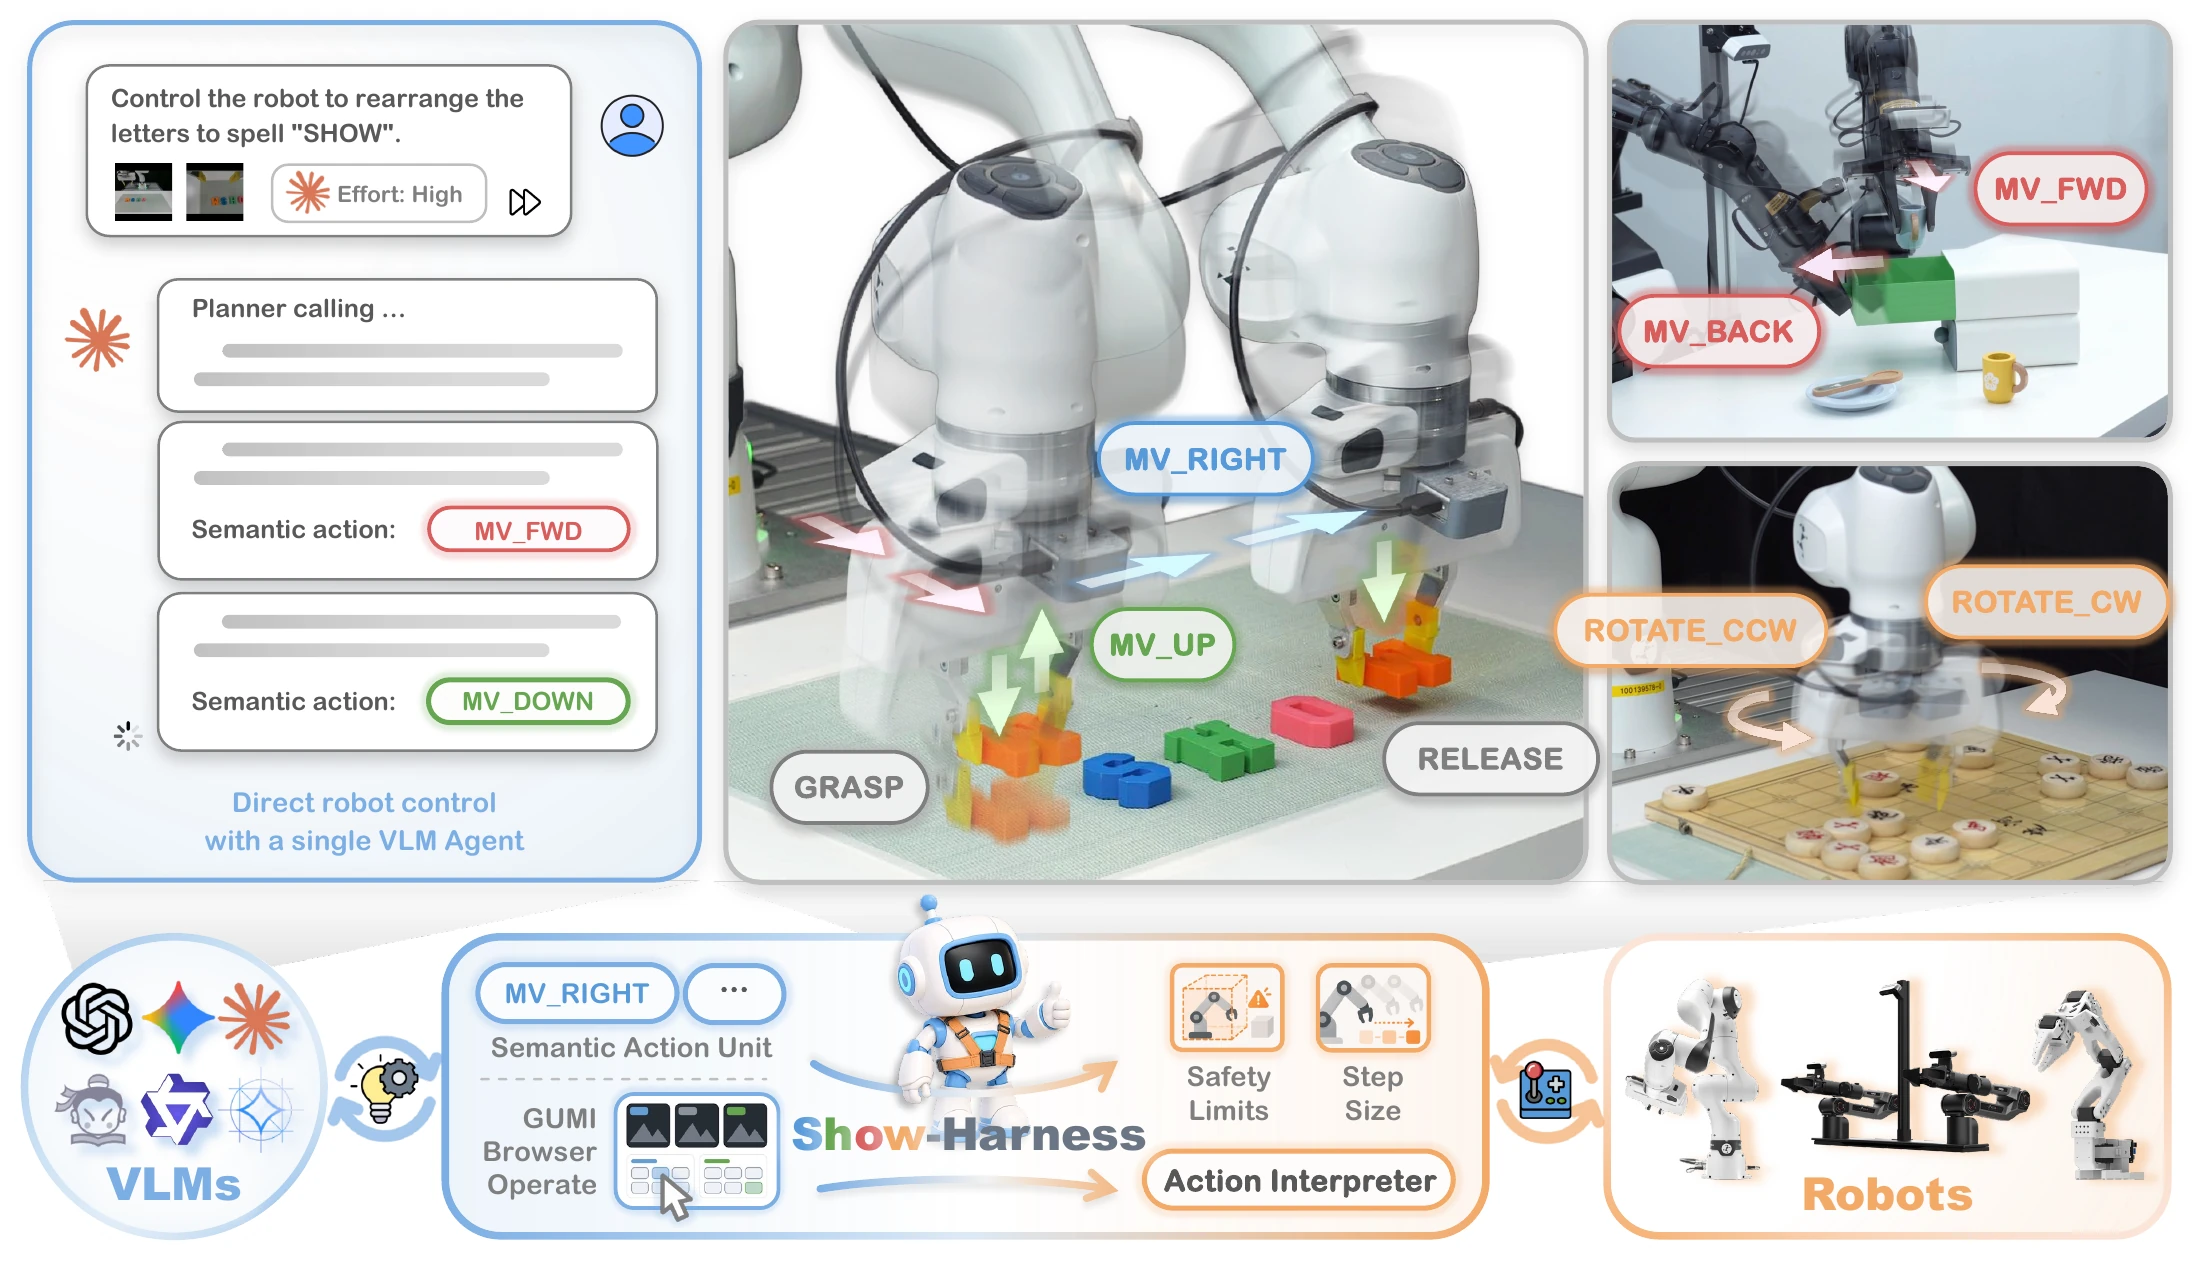
图 1. VLM、语义动作与机器人解释器之间的关系。图源:原论文 Figure 2。
2. Insight:动作含义可以稳定,物理实现可以改变
2.1 把动作选择与动作尺度分开
“向左移动”是可组合的语义决定,而具体移动 1 cm 还是 2 cm、如何转换成关节运动,可以由解释器处理。这样,调整精度或更换本体时,不必同时重定义模型看到的全部动作表示。
但“动作词相同”并不自动解决坐标问题。系统仍需确定参考视角、标定语义方向到机器人运动坐标系的映射,并配置工作空间与步长限制。这些工程条件是语义动作能够可靠落地的前提。
2.2 小动作使错误更容易被观察,反馈频率仍有代价
如果一次只做局部移动,模型可以通过新画面判断距离是否缩短、夹爪是否对齐,再继续修正。相比一次提交很长的轨迹,这提供了更多重新决策的机会,也会带来更多模型调用。
Show-Harness 因此加入动作分块和自适应步长:远离目标时可以一次执行短动作序列或使用较大步长,接近目标后再提高反馈密度。这里存在精度、调用量和延迟之间的实际取舍,不能仅凭“动作步数减少”判断端到端执行更快。
2.3 零样本能力与示范学习需要分别讨论
零样本模式使用前沿 VLM 的既有能力,并由规划、状态反馈和恢复模块组织执行。微调模式则让小模型从机器人示范中学习语义动作预测,保留的上下文也更简单。
两者共享动作接口,但并非使用相同模型、训练数据或全部插件。前者的成绩展示接口能够调用多少现有能力,后者的成绩展示这种表示在有限数据下是否容易学习。不能把小模型结果也描述成无需机器人数据。
3. Method:从观察到动作,再把执行结果交回来
3.1 语义动作与本体解释器
每轮输入包含任务指令、多视角图像、本体状态与近期动作历史。默认动作集合包括:
| 动作类型 | 语义单元 | 解释器执行内容 |
|---|---|---|
| 平移 | MV_FWD/BACK、MV_LEFT/RIGHT、MV_UP/DOWN |
沿参考视角对应方向移动一步 |
| 旋转 | ROTATE_CW/CCW,附带旋转轴 |
绕指定轴改变一定角度 |
| 夹爪 | GRASP、RELEASE |
闭合或打开夹爪 |
| 结束 | DONE |
声明任务完成 |
以平移动作为例,可以把解释器的位姿更新简写为:
其中 是动作方向, 将语义方向映射到本体的运动坐标系, 是步长, 表示工作空间与单步运动约束;完整接口还处理姿态旋转与夹爪。Franka 使用笛卡尔阻抗控制,AgileX 通过逆运动学与关节目标执行,模拟器则使用对应的操作空间控制。
模型直接决定的是细粒度语义动作,底层控制仍由解释器完成。工作空间和桌面高度等限制能阻止部分无效动作,却不等于已经解决全部碰撞、接触稳定性与动态环境风险。
3.2 感知、推理与恢复如何配合?
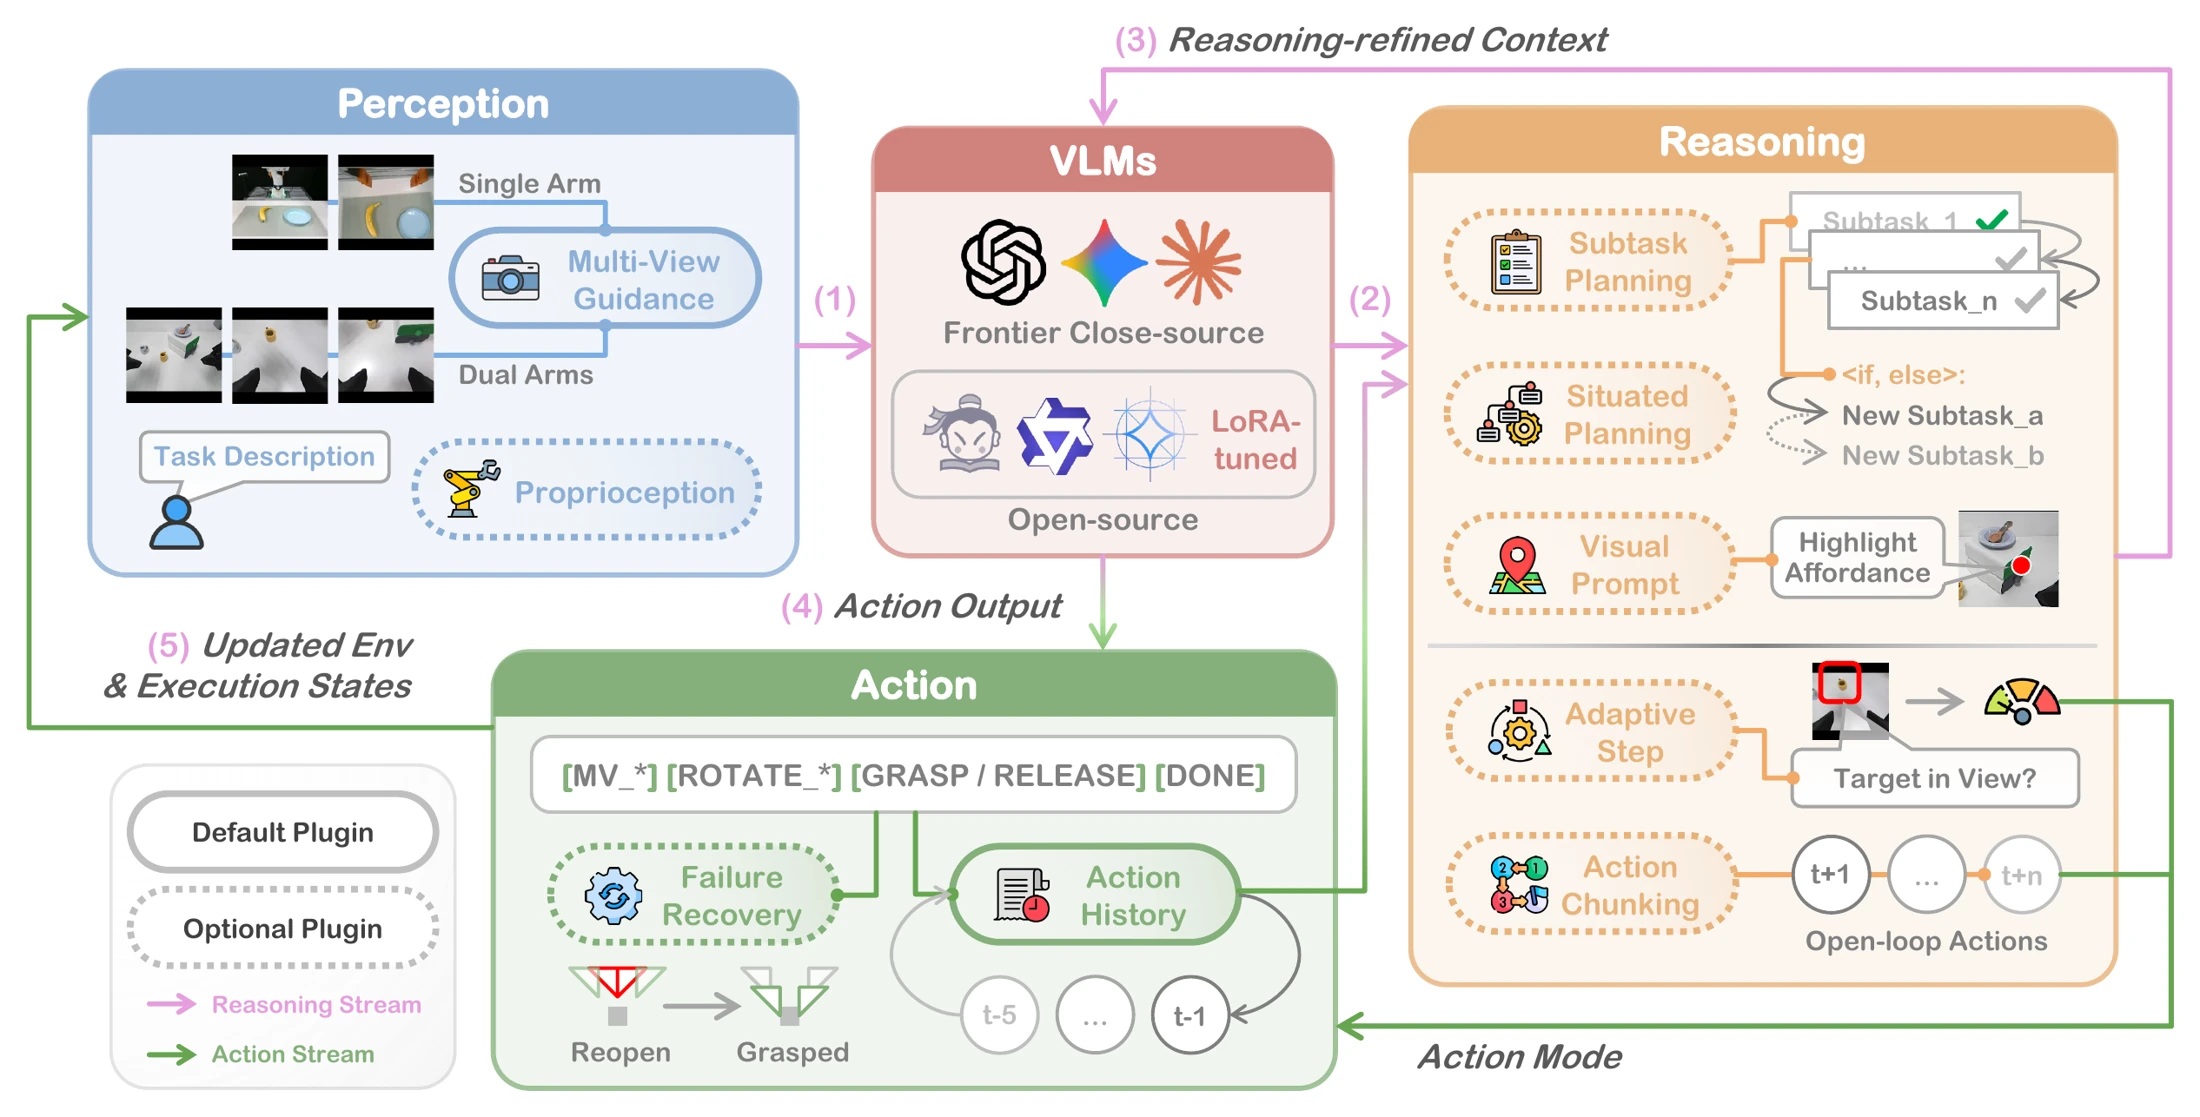
图 2. Show-Harness 的闭环架构。图源:原论文 Figure 3。
感知阶段明确各相机的用途:全局视角帮助确认场景与目标,腕部视角辅助近距离对齐;本体状态被转换成夹爪高度、接触状态与夹持状态等文字反馈,补充二维图像难以确定的信息。
推理阶段先生成带有视觉完成条件的子任务序列,再根据最新画面决定是否进入下一阶段。Situated Planning 用于需要等待新证据的任务,例如先移开遮挡、看到物体后再决定后续动作。Visual Prompt 则在语言难以准确描述操作部位时,额外调用模型生成视觉标记。
默认配置还使用自适应步长、短动作分块与最近五步动作历史。分块期间的动作是开环执行,下一次模型查询发生在分块结束后。失败恢复模块识别抓取失败,重置夹爪并返回相关抓取子任务,因此最终成功率也包含这些明确设计的恢复机制。
3.3 GUMI 与小模型微调
GUMI 将同一动作集合做成图形化按键界面,供人类键盘操作或 Agent 使用。一次示范既记录动作前的图像与语义动作,也能保留相应底层控制轨迹,使语义策略与连续动作基线能够使用来自相同示范的数据。
真实机器人训练数据包含 164 个回合、约 7.8K 个决策步,来自 Franka 与单臂 AgileX。小模型默认使用 Qwen3.5-2B,在语言模型线性层加入 rank-64 LoRA,冻结视觉编码器与多模态投影层,更新约 3% 的参数。它通过原生词表预测动作,不添加专门动作头或特殊动作 token;微调上下文主要保留任务、图像和短动作历史。
仿真到真实的实验另外使用 230 个模拟器示范回合、约 13.5K 步,来自 ManiSkill 与 RoboLab。该设置的训练来源与真实示范实验分开,后续结果也应分别解释。
4. Experiments:接口带来了什么,又没有证明什么?
4.1 十个真实操作任务上的结果
基础任务由五种物体与盘子、碗两种容器组合而成,每项随机摆放运行十次,通常最多允许 50 个交互步,超时记失败。泰迪熊与棋子没有出现在小模型的示范训练中,作为未见物体测试。
零样本模式 ZS 默认使用 Gemini-3.1 Pro 的 medium 推理设置;微调模式 FT 使用 Qwen3.5-2B。下表摘录原论文 Table 2 的十任务平均成功率:
| 方法 | 成功率 |
|---|---|
| π0.5 | 39% |
| GR00T | 35% |
| Harness VLA | 50% |
| Goal-VLA | 13% |
| CaP-X | 44% |
| RATS | 57% |
| Show-Harness ZS | 89% |
| Show-Harness FT | 86% |
π0.5 与 GR00T 使用同一批示范转换的连续末端轨迹进行微调,使数据来源更可比。但各系统的骨干模型、预训练经历和决策结构仍有差异,这组结果不能单独把全部收益归因于动作离散化。它支持的是:在这套数据与任务设置下,完整的 Show-Harness 系统表现较好。
4.2 环境迁移与本体迁移的训练条件不同
背景、光照、视角与干扰物四类变化,每类只测试“积木或香蕉放到盘子上”两个任务,共 20 次。ZS 四类都为 20/20;FT 分别为 18/20、19/20、19/20、19/20。这是有限任务上的鲁棒性证据,不能据此断言任意环境都可零失败操作。
仿真到真实时,FT 仅用仿真示范训练,在真实 Franka 上达到 13/20,同设置下 π0.5 和 GR00T 均为 0/20。这个结果具有研究价值,但样本量和任务范围都较小,距离广泛的 sim-to-real 结论仍需更多测试。
跨本体实验使用五个放盘任务,每个机械臂共 50 次。ZS 在 Franka 与 AgileX 上分别为 48/50 和 45/50,FT 为 45/50 和 42/50。FT 的训练数据已经同时包含两种本体,所以它检验的是共同接口下的联合训练与部署;不能把它当成对全新、未见机器人本体的零样本迁移。ZS 则通过更换解释器适配本体。
4.3 插件消融指出:精细定位与状态反馈仍是关键
默认零样本系统在五个放盘任务上的成功率为 96%。原论文的插件分析报告:仅使用全局视角时为 58%,去掉本体状态时为 68%,去掉子任务规划时为 60%。这些数字来自这一任务子集,不能与前面十任务的 89% 混用。
模型输出合法动作单元的比例超过 98%,说明遵守动作格式通常不是主要瓶颈。进一步的棋子操作分析显示,错误更多集中在精确抓取和放置,提供目标框能够改善表现。对视觉 Grounding 研究而言,这比“模型能理解指令”更具体:需要定位可操作区域、估计当前误差,并让这些证据进入下一步动作选择。
细粒度任务还展示了调节解释器步长的价值:把 2 cm 改为 1 cm,可以在不重训策略的情况下改善堆叠和插入。它说明动作语义与物理尺度解耦具有适应性,但更小步长通常也意味着更多决策或执行次数,需要同时测量时间成本。
4.4 控制步数、微调成本与实时响应需要分开看
附录报告 Qwen3.5-2B 的微调在单张 H200 上不到两小时,这是特定数据、模型和训练配置下的结果,并不是整个系统的数据采集与部署成本。零样本模式仍要通过 API 调用前沿模型。
增加推理强度主要减少冗余交互步,对成功率的改善较小,还可能增加墙钟耗时;论文给出的一个 GPT-5.6-sol 例子达到 3.4 倍。因此,少走几步与更快完成任务并不等价。对于会滚动、滑落或发生接触变化的物体,下一次观察和动作到达得是否及时,同样影响控制质量。
5. Conclusion
Show-Harness 的贡献在于提供了一套可解释、可组合的中间动作接口,使前沿 VLM 与小型微调策略都能进入机器人闭环。真实实验展示了这条路线在所选抓取放置任务上的有效性,也表明多视角、本体反馈、规划与恢复共同构成了结果。
Show-Harness 让模型直接选择小幅语义动作,因此动作粒度与观察频率会共同影响闭环表现。一个值得研究的方向,是在统一时间预算下比较不同步长与反馈频率,检验精细 Grounding 误差如何累积、何时需要重新观察,以及局部修正能否带来稳定的成功率提升。
目前实验主要围绕平行夹爪的单臂和双臂操作。走向灵巧手、更复杂接触和动态环境,还需要更丰富的动作表示、触觉或力反馈,以及对完整延迟的测量。接口可以降低适配难度,但其泛化边界仍由感知、控制器、训练覆盖和反馈时机共同决定。
References
- Show-Harness: Just a VLM Agent Can Play Robots, arXiv:2609.10522v1, September 9, 2026.