作者:Haoxiang Zhang、Qinglin Chen、Hiroaki Hayashi、Zhuofeng Li、Siming Zhang、Jiaxin Zhang、Jixuan Chen、Fang Wu、Pan Lu、Silvio Savarese、Julian McAuley、Chien-Sheng Wu
单位: Salesforce AI Research、UC San Diego、Texas A&M University、Stanford University
1. Motivation:全部失败的轨迹,仍然包含可学的信息
同一道编程题的多个尝试若都未通过测试,GRPO 一类组内相对奖励目标就失去了成功与失败的对比。可是执行轨迹可能已经揭示边界条件、错误假设和工具使用问题。标量奖励相同,不代表尝试没有信息。
Self-Retrospection Distillation(SRD)进一步问:任务完成后的经验,能否教会 Agent 在行动前预见这些要求与陷阱?它把监督目标从下一步动作转向行动前的知识或风险预测,再通过共享模型参数影响实际解题能力。
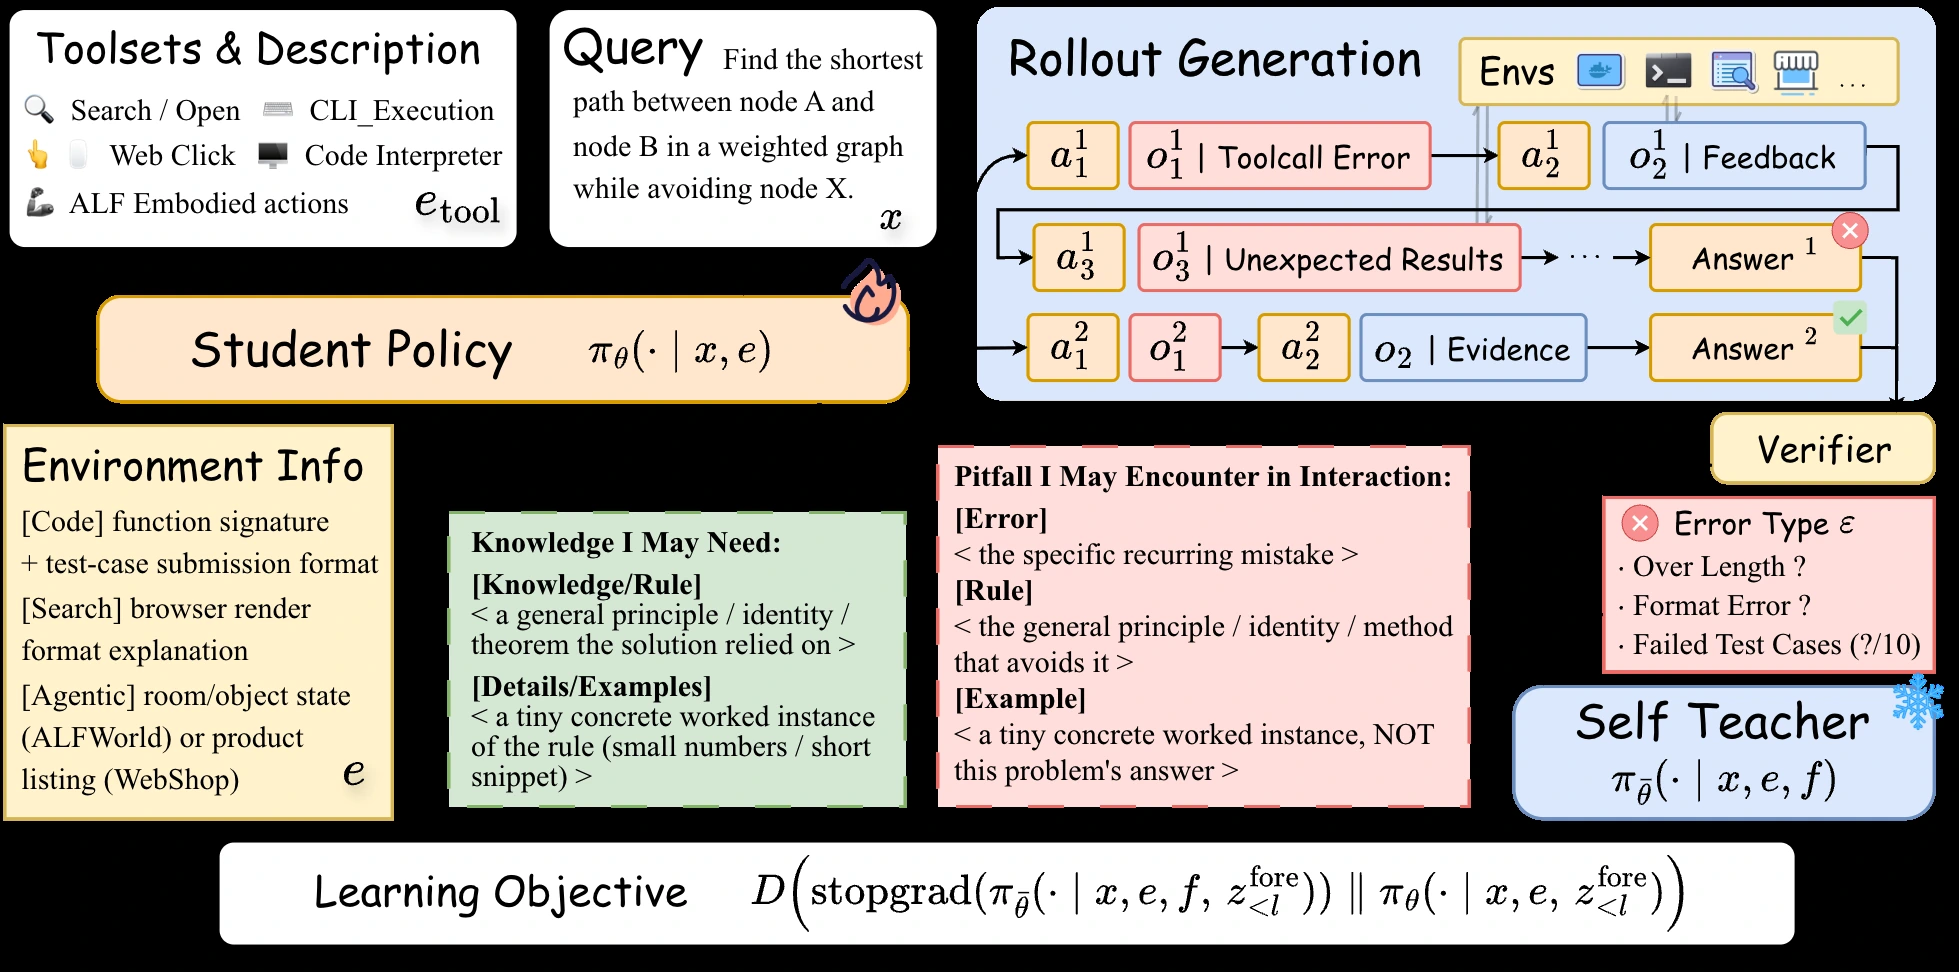
图 1. 同一策略分别产生交互轨迹和预见文本,停止梯度的教师利用事后信息监督预见序列。图源:原论文 Figure 2。
2. Insight:经验既可纠正行为,也可训练预期
2.1 监督预测对象,与丰富教师输入是两件事
普通 hindsight 蒸馏让教师看正确答案或执行反馈,再指导学生应该采取什么动作。SRD 则让教师指导“事前可以预见什么”:例如解题会用到哪条知识,哪种假设容易导致失败。
两者可以共用事后证据,但训练输出不同。SRD 作为辅助目标接在 RLVR、自蒸馏或混合目标上,试图补充组内奖励对比没有提供的信号。
2.2 信息优势来自事后上下文
教师是当前策略的停止梯度副本,能看到完成轨迹、gold answer/solution,以及适用时的错误标注;学生仅看到任务和行动前可用的环境上下文。教师并非凭空从自身输出生成可靠真相,监督包含答案与环境反馈的额外信息。
上下文信息差构造了自蒸馏信号,但仍需要检查教师信息是否正确、是否能够转化为学生可学习的规律。
3. Method:在学生预见序列上进行事后对齐
3.1 Knowledge 与 Pitfall 两个通道
一般形式将成功轨迹用于提炼可能需要的 Knowledge,失败轨迹用于提炼应避免的 Pitfall。学生按相应指令,从任务和环境上下文采样预见序列;教师面对同一预测对象,再获得对应的事后证据。
原论文主结果实际只使用 Pitfall 通道。双通道是可选扩展,不应把主表收益解释为知识与陷阱共同训练的结果。
3.2 教师评价学生已经生成的前缀
在每个学生预见 token 前缀上,教师和学生分别形成下一个 token 的分布。SRD 用广义 Jensen–Shannon divergence 对齐二者,教师分布停止梯度,学生通过共享策略参数接受更新。
整体目标可以写为:
其中 base 可以是 GRPO、on-policy 自蒸馏 OPSD,或两者结合的 RLSD。预见序列是训练对象,部署时不必额外生成它;主实验直接用更新后的策略完成任务。
3.3 同奖轨迹有监督,但不等于同计算成本
组内奖励都相同时,基于奖励对比的策略梯度为零,教师与学生的预见分布仍可能不同。SRD 因而可以从这类轨迹获取辅助信号。
这种信号来自额外的预见采样与教师计算。使用相同 rollout 预算,意味着交互样本数可比较,并不意味着总训练 FLOPs 或耗时相同。是否值得保留全部轨迹,还要看有效监督的质量与成本。
4. Experiments:主任务收益与稀疏奖励诊断
4.1 十项评测的多数汇总指标改善
主实验使用 Qwen3.5-4B/9B-Thinking,涵盖数学、代码、搜索,以及 ALFWorld 和 WebShop。Table 1 报告 avg@8,即八次采样的平均成功/得分,不是“八次中至少成功一次”的 pass@8。
4B GRPO 与加入 SRD 的结果如下,均使用原表的百分制汇总:
| 评测汇总 | GRPO | GRPO + SRD |
|---|---|---|
| 数学平均 | 46.22 | 56.25 |
| 代码平均 | 36.85 | 45.18 |
| 搜索平均 | 48.29 | 56.34 |
| ALFWorld | 67.75 | 71.00 |
| WebShop | 77.21 | 83.13 |
9B OPSD 的数学平均从 39.70 到 56.92,ALFWorld 从 73.88 到 77.13,WebShop 却从 91.76 降到 88.15。摘要中的最高约 24.2 个百分点来自 9B OPSD 的 AIME26 单项增益,不能当成所有任务的平均提升。
代码评估从训练的 stdin 格式转向 functional 格式,ALFWorld 使用 unseen 环境,部分搜索任务需要更多工具调用,这些变化提供了训练条件之外的测试。个别单项仍下降,类别平均改善不代表每种任务都改善。
4.2 主比较还涉及教师上下文的结构化
含自蒸馏的主表配置加入 SRD 时,还把原始 privileged trace 改为结构化 hindsight。主表因此包含教师前缀与辅助目标两个变化,不能将全部增益都归为一个新增损失的纯效应。
论文 Table 2 另做前缀与通道消融。在相同 raw-trace 前缀下,Pitfall 使 4B AIME26 从 53.75 到 57.08;使用 hindsight 前缀时,从 63.75 到 67.08。这个对照支持 SRD 本身有额外作用,也显示教师信息组织方式有独立影响。
再加 Knowledge 并不稳定更好:4B hindsight 配置的 AMO 从仅 Pitfall 的 16.75 降到 11.50,且双通道耗时更高。选择预测对象需要实测,更多监督通道不自动产生更多能力。
4.3 60.6% 是专门诊断中的训练成功率
为研究同奖问题,作者单独在代码域训练、关闭 dynamic sampling,并比较四个模型规模。奖励一致组占比为 98.0%、39.1%、37.0%、41.3%;弱模型以全部失败为主,强模型则出现更多全部成功组。
2B 配置中,98% 的组全部失败。基准训练成功率峰值仅 1.6%,结束为 0.0%;相同 rollout 预算加入 SRD 后达到 60.6%。这是该诊断实验的训练曲线,不能作为保留测试集上的 60.6% 泛化成绩,也不能直接替代主表 4B/9B 结果。
这个实验仍有明确意义:增加模型规模不能完全消除奖励对比盲区,辅助目标可以使用原本被丢弃的执行证据。但教师答案信息与额外计算也是恢复学习的重要条件。
4.4 部署时显式说出预见,并非普遍有益
Table 3 对同一检查点比较是否先输出预见文本。4B RLSD + Pitfall 的 ALFWorld 从 68.50 到 73.50,GRPO + Pitfall 则从 71.00 到 69.63。结果取决于目标和通道,不能把“训练预见”顺推为“推理一定要先预见”。
各配置也没有同时改善 ALFWorld 全部六类任务。错误预见可能把不成立的容量约束写进整段行动上下文,使后续步骤受它影响;作为训练目标,它还有后续反馈纠正机会,作为部署前缀则会直接左右当前任务。
5. Conclusion
SRD 提供了一条利用失败经验的训练路线:让事后证据教会策略,在行动前更好地表达任务要求与潜在陷阱。同奖轨迹诊断和固定前缀消融支持这一辅助信号的价值,主评测也显示它能与多种目标结合。
收益的边界同样清楚:事后答案提供监督,通道选择会改变表现,训练曲线不等于测试泛化,相同交互预算不等于相同计算。现有实验支持一次后训练中的经验利用,持续多轮自我改进与开放环境可靠性仍需另行验证。
References
- Self-Retrospection Distillation: Turning Post-hoc Experiences into Prior Foresight, arXiv:2610.08077v2, 2026-10-08.