作者:Hongcheng Gao、Jingjing Zhou、Zelin Zheng、Shijia Ge、Jay Zhu、Yazhe Wang、Jianshu Zeng、Xuan Shangguan、Di Wu、Lingyu He、Zhiqi Jia、Sihang Wu、Xiao He
团队: HexaFuture
1. Motivation:动作完成之后,任务真的完成了吗?
机器人将一份食材放进烤箱,随后关门。从局部动作看,这可能是一段流畅执行;但如果任务要求放入两份食材,提前关门反而会使剩下的目标更难完成。动作模型输出“结束”,也无法直接说明长任务的每个条件都已经满足。
Self-Evolving Coding Agents 将问题定位到执行表示:目标、前提、进度和恢复规则如果都隐含在动作序列中,就很难被检查、单独修改或复用。论文提出 Physical Coding,把任务相关状态与执行流程写成代码,让 Agent 能够调用工具、检查结果,并把失败定位到具体条件和程序节点。
这并不要求放弃 VLA 或 WAM。它们仍可以作为动作工具提供运动能力,外围执行框架则负责决定何时调用、何时中断、缺少什么证据,以及失败之后如何恢复。由此产生的完整执行记录,还可以成为下一版工具、框架与模型的改进材料。
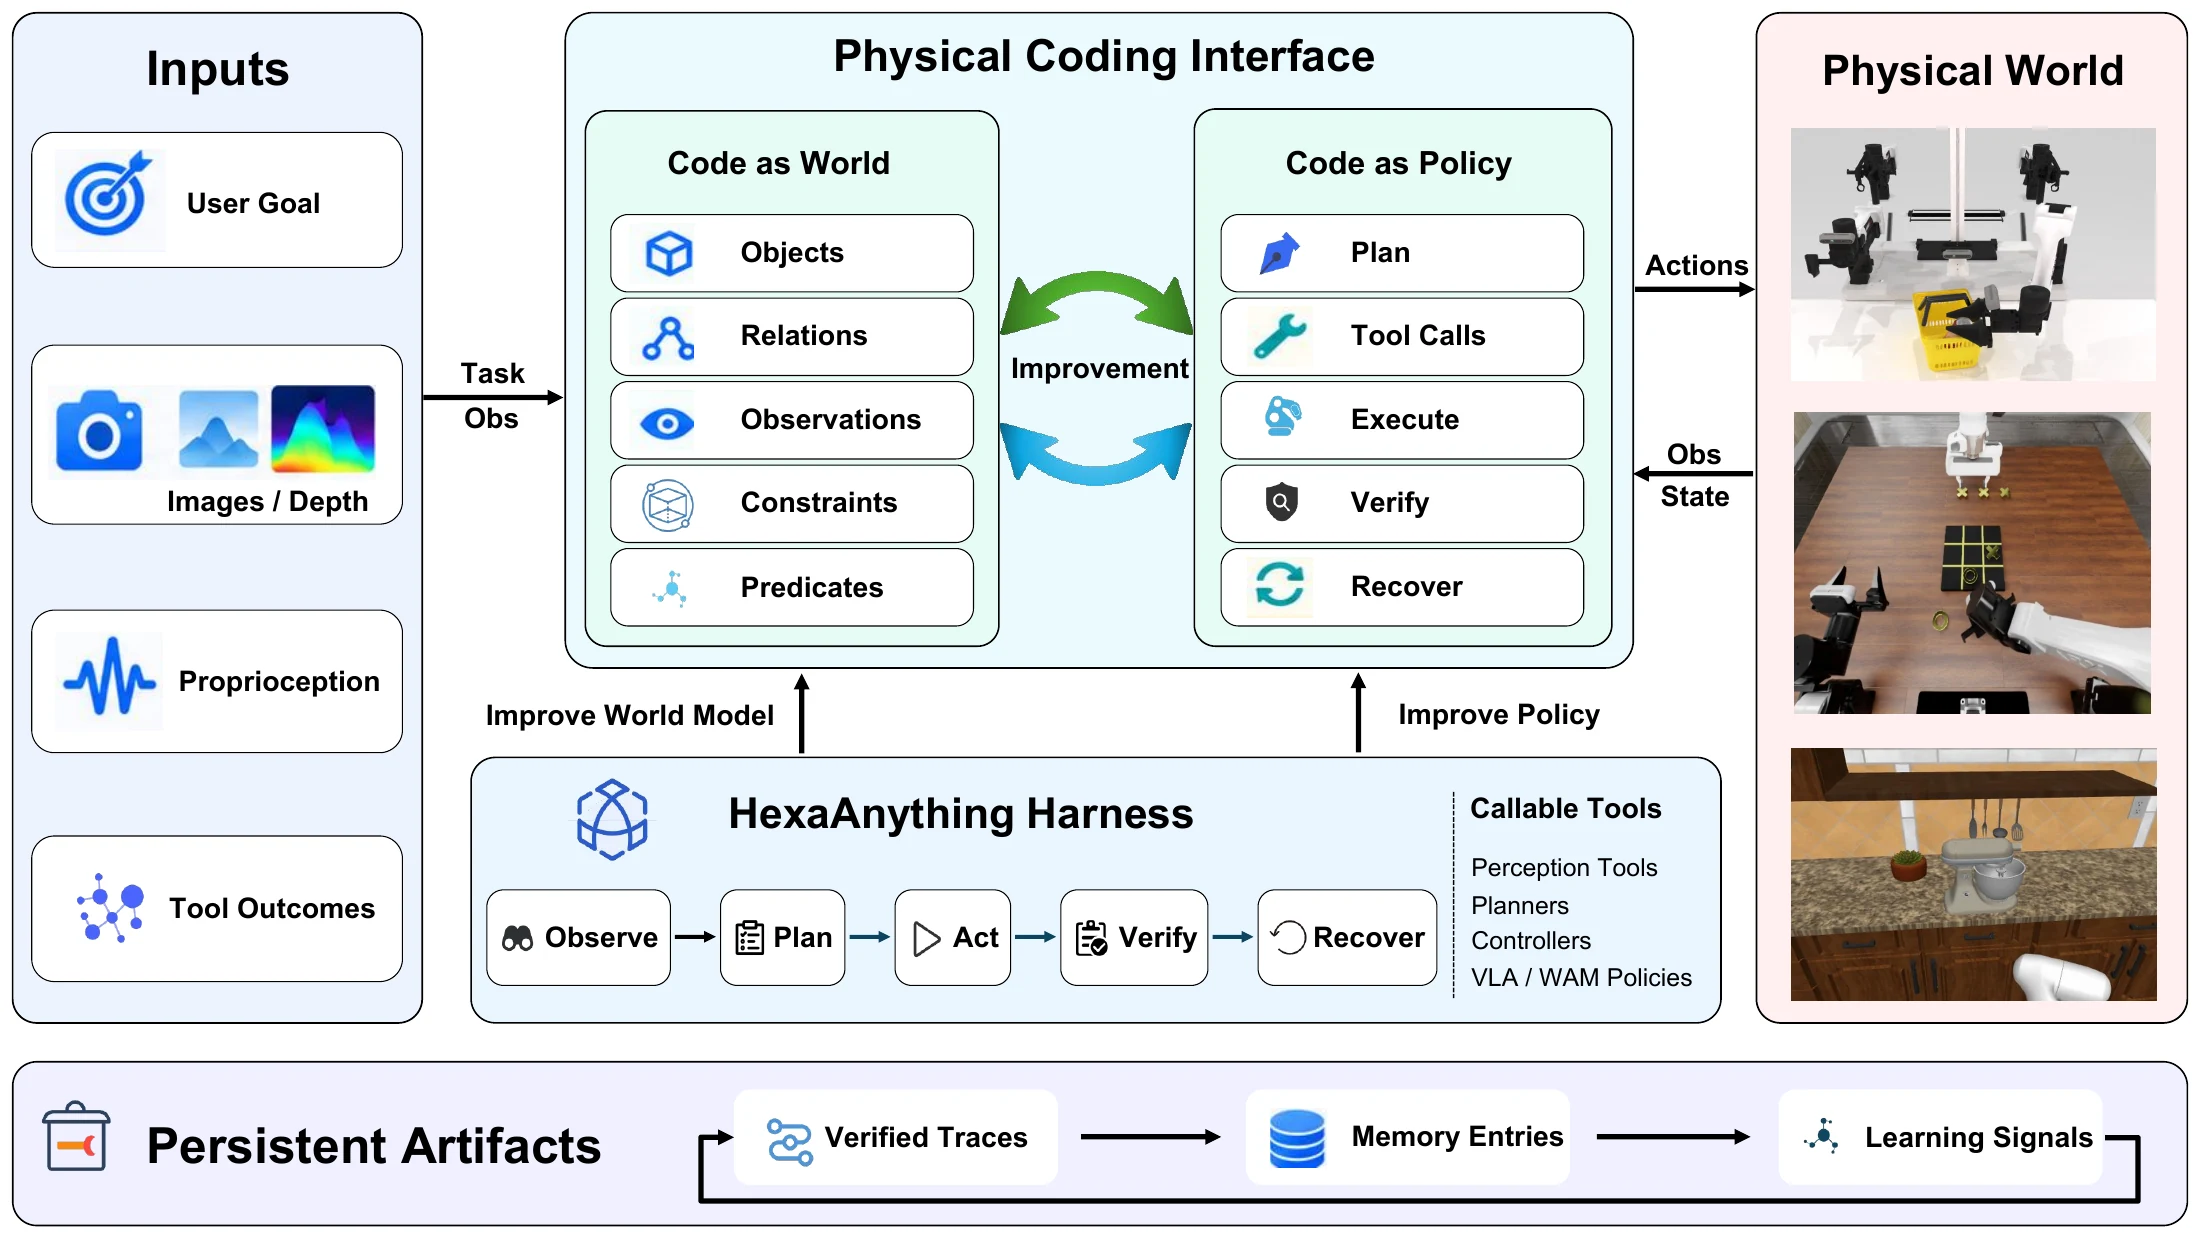
图 1. Physical Coding 的世界程序与策略程序。图源:原论文 Figure 1。
2. Insight:可复用经验需要状态、执行与证据共同存在
2.1 世界程序记录条件,策略程序决定行动
这里的 Code as World 主要描述任务相关对象、关系、观测、约束与进度条件。例如,世界状态需要区分“面包已在烤箱内”和“两种食材都已在烤箱内”。它是一份可更新、可查询的任务状态程序,不必等同于完整的高保真物理模拟器。
Code as Policy 则表达步骤、分支、循环、工具调用、验证和恢复。策略可以要求“只有两种食材都在内部,才允许关门”,也可以在抓取失败后重新观察和选择下一步。状态与策略分开后,失败才有机会被定位到错误判断、缺失前提或不合适的工具。
2.2 在线恢复与跨轮进化是两种不同改进
一次任务中重新规划,说明系统能根据反馈继续执行;把有效修改保留为工具,或将验证后的轨迹用于训练下一版模型,才形成跨任务、跨版本的持久改进。
论文同时研究这两层过程,但给出的实验证据仍是分项的:固定动作模型比较不同执行框架,在相同框架中比较训练前后的规划模型,以及固定任务与评价器修订工具。它没有证明从模型架构到硬件的整个系统已经可以完全自主、持续地共同进化。
2.3 验证必须独立于模型的完成声明
如果未来模型要学习这些执行记录,一次错误的“成功”判断就可能变成训练标签。HexaAnything 因此区分执行状态、任务完成和外部证据:动作工具返回 finished 只表示工具停止,最终任务标签仍由独立的检查决定。
运行中的验证器根据可获得的图像、深度、本体状态和工具结果检查条件;仿真实验最终由基准官方评价器判定成功。两者不一致时,应当保留为反例,而不是把模型自己的结论覆盖到外部标签上。
3. Method:HexaAnything 如何把执行变成可检查的程序?
3.1 从观察到验证的运行闭环
记世界程序为 ,策略程序为 。模型根据任务、当前世界、观测历史与记忆生成一个有类型的策略节点,再由框架分派对应工具。工具执行后,系统更新世界并取得验证结果:
是新观测, 是工具返回, 是任务。验证结果 决定继续流程、中断工具、重新观察、调用恢复程序或结束任务。VLA/WAM 在这个结构中是可调用的动作模块,任务状态维护和完成判断属于框架职责。
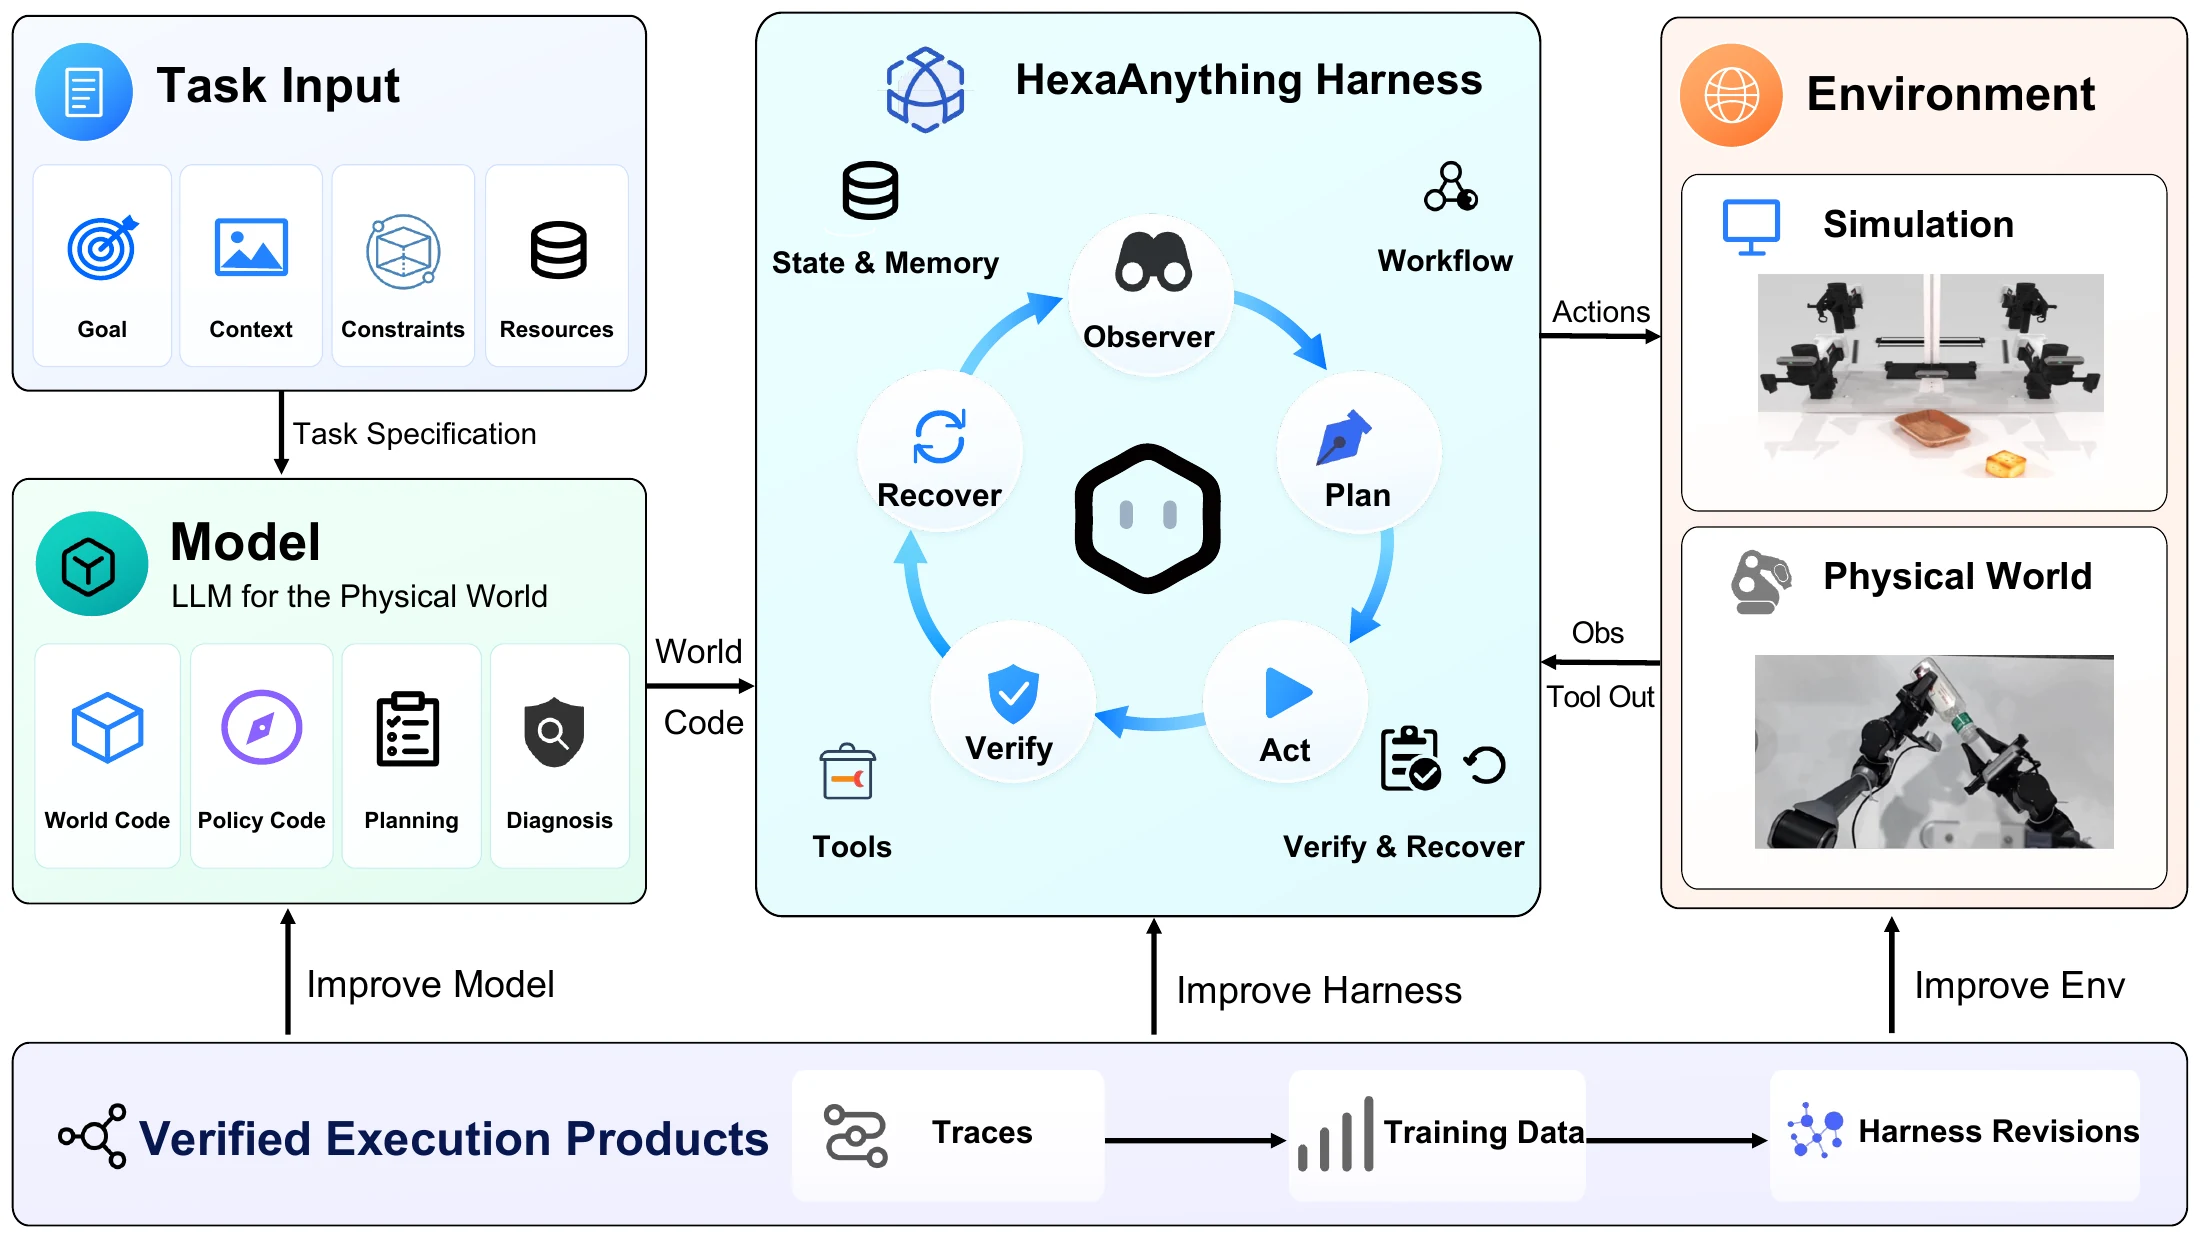
图 2. HexaAnything 执行框架及验证记录的回流。图源:原论文 Figure 5。
3.2 执行契约让不同结果不会混为一谈
论文不只给出一段高层提示词,还定义了用于约束执行与记录证据的接口。
| 契约或记录 | 固定或保存的内容 | 作用 |
|---|---|---|
| GoalContract | 用户原始任务、运行时目标和验收依据 | 防止过程中悄悄改写目标 |
| 有类型的策略节点 | 观察、动作、VLA 调用、判断、恢复、分支和循环 | 让工作流在执行前接受结构检查 |
| ObservationEnvelope | 观测来自模型、工具、框架还是官方评价器 | 保留证据来源 |
| TrialOutcome | 完成情况、停止原因、步数、奖励与评价器身份 | 区分成功、失败和预算停止 |
| ExperimentSpec | 任务、种子、执行模式、预算与可用知识 | 固定一次对比实验的条件 |
验证器的输出包括 Pass、Fail、InsufficientEvidence、Blocked 和 SafetyStop。证据不足不会被自动解释成成功;达到步数限制也是单独的停止原因,不应与任务语义或全部失败类型混成一个标记。
每条轨迹记录世界状态、策略节点、工具调用、结果、验证判定及记忆。这样,后续改进可以回查某次动作依据了什么,而不必仅从最终成败猜测原因。
3.3 修改作为候选版本接受检查
失败可以触发新工具、工作流修改、世界条件修订或恢复规则调整。候选版本需要经过静态检查、回归测试和外部评价,再决定是否接受;修改验证器本身,则还需要单独测试,避免提议者与裁判共同适应同一批错误。
论文的进化范围包括框架、数据和环境、模型与算法、硬件及计算平台,但这些层次并没有同等充分的实验。当前实现主要展示执行框架、工具修订和一次数据到模型的更新。更高层的架构、表示语言与硬件自主重设计属于研究路线。
3.4 HexaModel:将验证轨迹用于规划模型训练
HexaModel v0.1 在 Qwen3.8-27B 上微调一个 epoch,总训练数据为 44,340 条记录、178.6M tokens。框架返回的数据包括约 9.3K 个 RoboCasa365 状态与完成判断问答,以及 1,010 条包含子目标、工具调用、验证结果和恢复决策的 Agent 轨迹。
这 1,010 条轨迹来自三个规划者:基础 Qwen3.8-27B 的 703 条成功执行、GPT-5.6-Sol 的 204 条恢复执行,以及更早微调检查点的 103 条恢复执行。后一部分提供了“前一轮模型参与产生下一轮数据”的证据,但训练数据并非全部由同一个模型自主生成。
框架返回数据占总训练 tokens 的 38.8%,其余包含通用具身问答、场景描述、数学、代码和指令数据。训练后模型回到同一个 HexaAnything 框架中担任规划者;这次更新针对高层模型,不是对 XR-1 动作模型重新训练。
4. Experiments:分别看框架、模型与工具的收益
4.1 固定 XR-1,执行框架带来多大变化?
RoboCasa365 实验覆盖 18 个 Atomic-Seen、16 个 Composite-Seen 和 16 个 Composite-Unseen 任务,每个任务评估 50 个种子,每种条件共 2,500 次试验。原生 VLA 与编程 Agent 使用相同的最大环境步数;两个编程 Agent 都由 GPT-5.6-Sol 驱动,并调用同一个 XR-1 动作模型。
下表为原论文 Table 1,Overall 汇总全部试验,而非三个子集简单等权平均。
| 子集 | 原生 XR-1 | HexaAnything | Codex |
|---|---|---|---|
| Atomic-Seen | 78.0% | 80.9% | 81.7% |
| Composite-Seen | 54.8% | 61.5% | 59.8% |
| Composite-Unseen | 34.3% | 38.3% | 34.1% |
| Overall | 56.6% | 61.1% | 59.5% |
HexaAnything 相比原生 XR-1 总体提高 4.5 个百分点,未见组合提高 4.0 个百分点。相比同模型驱动的 Codex,总体优势为 1.6 个百分点;Codex 在 Atomic-Seen 上反而高 0.8 个百分点。因此,这个实验支持特定框架对组合任务的帮助,不能概括为专用框架在所有任务上都优于通用编程 Agent。
三个额外案例各评估 100 个种子:LoadKebabSandwich 从 17% 升至 48%,PortionHotDogs 从 22% 升至 37%,WaffleReheat 从 53% 升至 70%。在第一个案例中,框架把“两份食材都在烤箱内”作为关门前提,避免过早结束;在热狗分装中,则检查每个盘子缺什么并恢复掉落或停滞。
这些任务子集的较大提升不能替代主表平均。论文还将 PortionHotDogs 的原生动作预算翻倍,成功数为 21/100,标准预算为 22/100,框架版本为 37/100。这说明该案例的收益不能简单解释为给动作模型更多步数;相同环境步数仍不代表相同模型调用成本或墙钟时间。
4.2 训练规划模型之后,收益是否保留?
原论文 Table 4 将训练前后的开放模型放在相同 HexaAnything 框架中比较。
| 规划模型 | Atomic-Seen | Composite-Seen | Composite-Unseen | Overall |
|---|---|---|---|---|
| Qwen3.8-27B | 80.8% | 61.0% | 37.3% | 60.5% |
| HexaModel v0.1 | 81.0% | 62.3% | 39.5% | 61.7% |
各子集都有提升,其中未见组合增加 2.2 个百分点,总体增加 1.2 个百分点。它表明框架产生的数据可以用于一次有效的规划模型更新;但由于训练还混合了其他数据,且没有在这里逐项消融数据成分,不能将全部增益单独归因于恢复轨迹或某一种代码表示。
这也不是任意轮次都能持续提高的证明。当前实验展示了有限的数据回流与模型改进,还需要更多轮迭代、独立任务和防遗忘评价,才能判断长期进化是否稳定。
4.3 工具修订有效,但开发记录与自主评测要分开
RoboDojo 的三项仿真任务固定任务定义和评价器,只修订工具及调用流程。原论文 Table 5 如下。
| 修订轮次 | Fold cloth | Pour vase | Press by number |
|---|---|---|---|
| Round 0 | 0.0% | 40.0% | 0.0% |
| Round 1 | 60.0% | 0.0% | 0.0% |
| Round 2 | 80.0% | 100.0% | 100.0% |
倒花瓶第一次修订反而从 40% 降到 0%,说明有效的进化需要发现回归和继续修订,不能把每次代码修改都视为进步。
折衣案例演化的是一个可复用的双点抓放工具,加入薄层捏取、双臂同步、腕部避让、释放姿态和折叠层高度处理等机制。工具接口保持一致,但这部分评测由操作者为每次调用选择像素点,测量的是工具和接口的能力,不能写成端到端自主折衣成功率。
其开发曲线使用五个种子,其中三个种子的选点曾参考与官方检查同源的服装关键点。最终工具又在去掉这些特权信息后重评:开发种子成功 3/5,未参与开发的种子成功 4/5,每个种子只运行一次且不重试;选点仍由人根据公开 RGB-D、标定与工具返回完成。这个重评比开发曲线更能说明接口的可迁移性,但样本量仍很小。
4.4 PhyBench:实验成功要有数值和证据
作者在 Isaac Sim 中构建 PhyBench,要求机器人自行设计并执行胡克定律、单摆和耦合振子实验,分别估计弹簧刚度 、重力加速度 和两个固有频率。任务提供器材与目标,参考参数对 Agent 隐藏,提交之后才用于评价。
执行者获得公共任务及一般实验指导,在 7,200 秒墙钟和 18,000 帧仿真预算内选择实验步骤。仪器提供合法测量接口,例如耦合振子可导出双通道位移 CSV,因此该任务并不要求所有时序量都从图像估计。
下表摘录原论文 Table 6:数值是有效运行上的平均相对误差,括号为有效运行数/全部运行数。
| HexaAnything 的规划模型 | 胡克定律 | 单摆 | 耦合振子 |
|---|---|---|---|
| GPT-6-Astra | 2.3%(10/10) | 1.2%(10/10) | 0.8%(10/10) |
| Opus 5.5 | 1.3%(10/10) | 1.0%(10/10) | 1.7%(10/10) |
| GPT-5.6-Sol | 4.8%(9/10) | 1.9%(8/10) | 1.2%(10/10) |
| Qwen3.8-Max | 12.4%(5/10) | 2.4%(3/10) | 3.7%(3/10) |
有效运行意味着完成物理和证据协议并产生有限误差,即使超过成功阈值也仍可计入。三项任务的成功阈值分别为刚度相对误差不超过 15%、重力不超过 3%、每个频率不超过 10%。因此,括号里的 10/10 不是十次全部通过精度要求,均值也不能替代逐次成功率;失败或中断保留在分母中,不被赋一个数值误差。
一个胡克定律案例将不同负载下的读数与来源图像绑定,再拟合 ,得到 N/m,提交后参考值为 25.16 N/m。其价值是从机器人操作到测量、拟合和结论有一条可回查的链条。它仍然是模拟实验,尚不能据此宣称已完成真实实验室中的自主科学发现。
4.5 真机:执行工具组合,复杂任务仍有缺口
真机平台为 AgileX PiPER-X 双臂系统,配四台 RealSense D435 RGB-D 相机。GPT-6-Astra 通过 URAI 工具调用执行任务;编程 Agent 在回合之间编写、验证并冻结工具,执行 Agent 在运行时组合这些工具。模型仅在工具调用之间决策,工具按机器人控制频率运行。
原论文 Table 7 每个任务仅评估三次。
| 任务 | 完整成功次数 | 平均完成进度 |
|---|---|---|
| 拧开瓶盖 | 3/3 | 100% |
| 井字棋 | 3/3 | 100% |
| 将积木放入碗 | 3/3 | 100% |
| 热狗上餐 | 3/3 | 100% |
| 倾倒积木 | 3/3 | 100% |
| 将积木抛入碗 | 1/3 | 77.8% |
| 折衣 | 1/3 | 83.3% |
抛掷任务的进度按六块积木中进入碗的数量计算,折衣进度来自操作者的完成度评分。77.8% 和 83.3% 都不应误写成任务成功率。
论文还将执行时间与其他系统的已发表结果比较,但对照使用不同机器人、速度限制和调用预算;第一次拧瓶盖试验还排除了初始诊断修复阶段。这些数字可以提供背景,无法构成同硬件、同条件的速度优势证明。
真机工具修订也使用了人的判断与示范,例如抛掷工具参考了一段人工投掷视频,并根据实测关节延迟、落点和操作者反馈调整。它展示了编程 Agent 利用物理证据改进工具的过程,而非完全无人参与的持续自我修改。
5. Conclusion
这篇工作的核心,是把物理执行变成能够留下程序与证据的过程。世界程序维护任务条件,策略程序组织动作与恢复,独立验证决定哪些记录能进入后续数据和版本更新。HexaAnything 的实验分别展示了固定动作模型下的框架收益、规划模型的一次训练改进,以及工具修订带来的局部能力提升。
这些证据值得关注,但强度并不相同:主框架比较集中在一个动作模型与一个操作基准,工具实验种子较少且部分依赖人工选点,科学实验仍在仿真中,真机每项只有三次。论文另设计了最长 10,000 环境步的更复杂家庭任务,但尚未评价任何系统,不能把它们算作已完成的长程能力。
后续最有价值的检验,是在固定预算、独立任务与稳定评价器下连续运行多轮更新,同时记录收益、回归和人的介入。只有当改进能跨版本保留、失败证据不被选择性丢弃、评价规则不随模型一起偏移,Physical Coding 才能从可检查的执行框架进一步成为可靠的长期学习机制。
References
- Self-Evolving Coding Agents: From Digital Programs to Physical-World Intelligence, arXiv:2609.35432v1, September 28, 2026.