作者:Xi Xiao、Tianchen Zhao、Youngeun Kim、Zhuowei Li、Linghan Xu、Jiaye Wu、Zheng Zhang、Xiang Xu、Xuanbai Chen、Farhan Tejani、Jakub Zablocki、Julia Xu、Yifan Xing
单位: University of Alabama at Birmingham、Amazon AGI
1. Motivation:多做潜在推理,是否真的更多看图?
隐空间视觉推理(LVR)将若干连续隐状态放在图像问题与文字答案之间,避免把每个中间步骤翻译为词。但过程不可直接阅读,最终答对也难以说明这些状态保留了什么视觉证据。
ReaLVR 从一个具体缺口出发:改变图像中决定答案的内容后,普通 LVR 的潜在轨迹可能变化很小。模型可以依靠问题先验输出答案,却没有充分利用新增计算去区分细节。
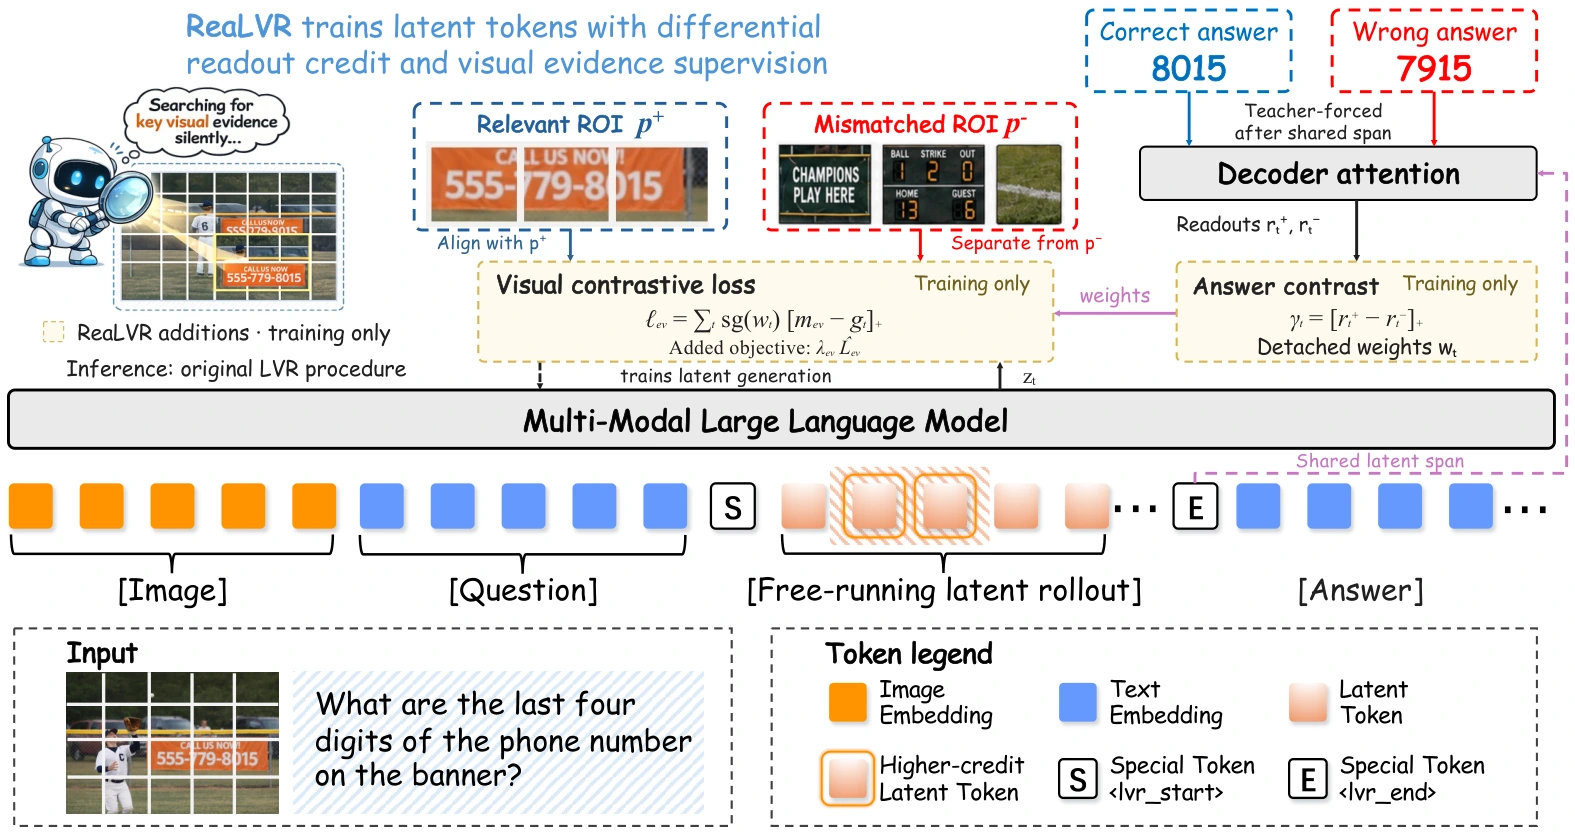
图 1. 视觉内容决定监督目标,答案对照决定监督位置。图源:原论文 Figure 2。
2. Insight:答案奖励与视觉证据信用并不相同
2.1 训练时给定的视觉前缀,不等于推理时自己生成的状态
常规 LVR 首先在 teacher forcing 下重建视觉目标,随后进行答案奖励优化。后一个阶段重放保存的 latent 时,将其当作固定上下文,策略损失主要作用于离散文字位置。
模型因此可以改善答案读出,却未直接训练自由生成潜在状态的过程去保存关键图像内容。论文称这一差距为 latent evidence-credit gap,并把额外监督放到模型当前自己生成、保留梯度的潜在轨迹上。
2.2 “保留什么”和“在哪里保留”分别提供信号
相关区域和错配图像定义需要保留的内容;正确与模型错误答案的注意力差异定义哪些潜在位置应获得更强监督。两种对照结合,避免只让全部 latent 接近一个图像均值,也避免仅凭注意力决定内容。
3. Method:在自由轨迹上分配视觉监督
3.1 先生成潜在状态,再读出答案
模型从图像问题生成 个连续 latent,前一个隐状态直接作为下一步输入。该段生成完成后,分别 teacher-force 正确和错误答案以计算读出权重。答案没有被提前放进 latent 的输入,推理时仍按原 LVR 流程生成。
普通 GRPO 的采样与重放保留;额外证据分支重新生成一条当前模型轨迹并对递归过程保留梯度。正、负视觉原型来自冻结视觉编码器与 connector,不随语言模型同时漂移。
3.2 视觉对比决定目标
有 ROI 时,正原型 是区域视觉 token 的加权均值;没有标注或区域为空时使用全图。负原型来自错配样本。潜在位置 的证据间隔为:
全图回退使方法能使用无区域标注数据,但不能据此将每个训练样本都称为精确区域监督。
3.3 答案读出决定强度
记正确答案读出注意力为 ,模型有效错误答案的平均读出为 ,只保留正差异,并加入均匀底座:
最终证据损失为:
权重分离梯度,防止模型通过减小监督权重降低损失。不存在有效错误答案时,选择信号为零,仍可保留均匀监督。权重总和并不固定为一,答案对照更强的样本会获得更大的总监督质量;分析消融时需要控制这一因素。
4. Experiments:准确率、区域联系和干预分别看
4.1 Qwen2.5-VL-7B 的五项结果
Table 1 报告三种子均值与标准差。下面保留均值,五项平均是等权平均,并非所有问题混合后的准确率。
| 方法 | MMVP | BLINK | HR-4K | HR-8K | MME-RealWorld | 平均 |
|---|---|---|---|---|---|---|
| LVR-RL | 64.2 | 53.6 | 69.6 | 64.4 | 50.1 | 60.4 |
| ILVR-Stage2 | 69.4 | 56.8 | 71.0 | 66.9 | 50.3 | 62.9 |
| Monet-RL | 69.9 | 52.4 | 71.3 | 66.0 | 51.5 | 62.2 |
| ReaLVR | 72.0 | 55.8 | 71.8 | 66.6 | 52.2 | 63.7 |
ReaLVR 平均比 LVR-RL 高 3.3 点,比最强对照平均高 0.8 点,但 BLINK 和 HR-8K 仍略低于 ILVR。其平均标准差为 0.2,不能把平均领先解释成每项或每种子都领先。
4.2 大模型验证覆盖不完全
Qwen3-VL-8B 和 30B 的五项平均为 61.2、65.2;InternVL3-8B 和 Gemma-3-12B 为 58.1、41.6。235B 总参数的 Qwen3-VL MoE 只评价 MMVP、BLINK 和 MME-RealWorld,结果为 81.9、75.4、71.0,没有 HRBench 或五项平均。
因此,可以说方法在不同骨干及较大模型上可用,却不能把 235B 的三项结果放入完整五项排名,或称其等价于 235B 稠密计算。
4.3 注意力联系仍需要干预支持
论文观察到问题相关 latent 位置变化更明显、区域注意力更强,并在固定其他 latent 的条件下替换被答案高注意力读取的位置,检查正确答案概率下降。固定上下文干预比单纯热图更接近“模型是否使用了这些状态”的问题。
但注意力位置选择不是自然世界中的因果真值。人工区域、教师答案、错配样本质量和冻结编码器都可能影响结果。附录还提供监督质量匹配的二维消融,将位置分配与正负内容对照分开,避免把增益全部归因于增加损失规模。
5. Conclusion
ReaLVR 的关键是让潜在计算接受与图像有关的监督:自由生成的状态要区分支持答案的视觉内容,并在更有用的位置获得更强信号。新增计算的价值因此可以通过输入扰动、区域联系和固定上下文替换共同检查。
对于细粒度感知,后续可将 ROI 质量、遮挡和相似干扰物作为受控变量,并比较同 latent 长度和训练计算下的收益。只有模型在关键证据改变时相应更新答案,隐空间推理才有充分理由被视为更有效的视觉计算。
References
- Rethinking Latent Visual Reasoning: Grounding Latent Reasoning in Visual Evidence, arXiv:2609.34563v1, 2026-09-28.