作者:Xiangyu Zeng、Yuandong Yang、Zhiqiu Zhang、Yuhan Zhu、Xinhao Li、Qingyi Si、Dingyu Yao、Changlian Ma、Haoran Chen、Xinyu Chen、Yansong Shi、Junhao Zhou、Yifei Li、Jun Zhang、Chuanyu Qin、Chenxu Yang、Xinlei Yu、Kun Ouyang、Yuchen Shao、Qianshan Wei、Changhai Zhou、Jun Gao、Jiaqi Wang、Limin Wang
单位: Nanjing University、Shanghai AI Laboratory、JD、Shanghai Jiao Tong University、USTC、Chinese Academy of Sciences、CUHK、Peking University、Tsinghua University、Fudan University、Zhejiang University
1. Motivation:先保留事实,再决定何时回答
摄像头持续移动时,视频助手不知道下一分钟会被问什么。一面墙上的开关可能只出现两秒,之后用户才问它的颜色;一个正在发生的动作,可能需要等待下一帧才能区分“打开”还是“关闭”。
保存所有视觉 token 会增加计算和上下文负担,只保留近期窗口又会丢掉历史。OneStreamer 将在线感知、与问题无关的事实记录、主动回答统一到一个因果生成过程,研究如何在不反复回看原始历史的条件下保留有用证据。
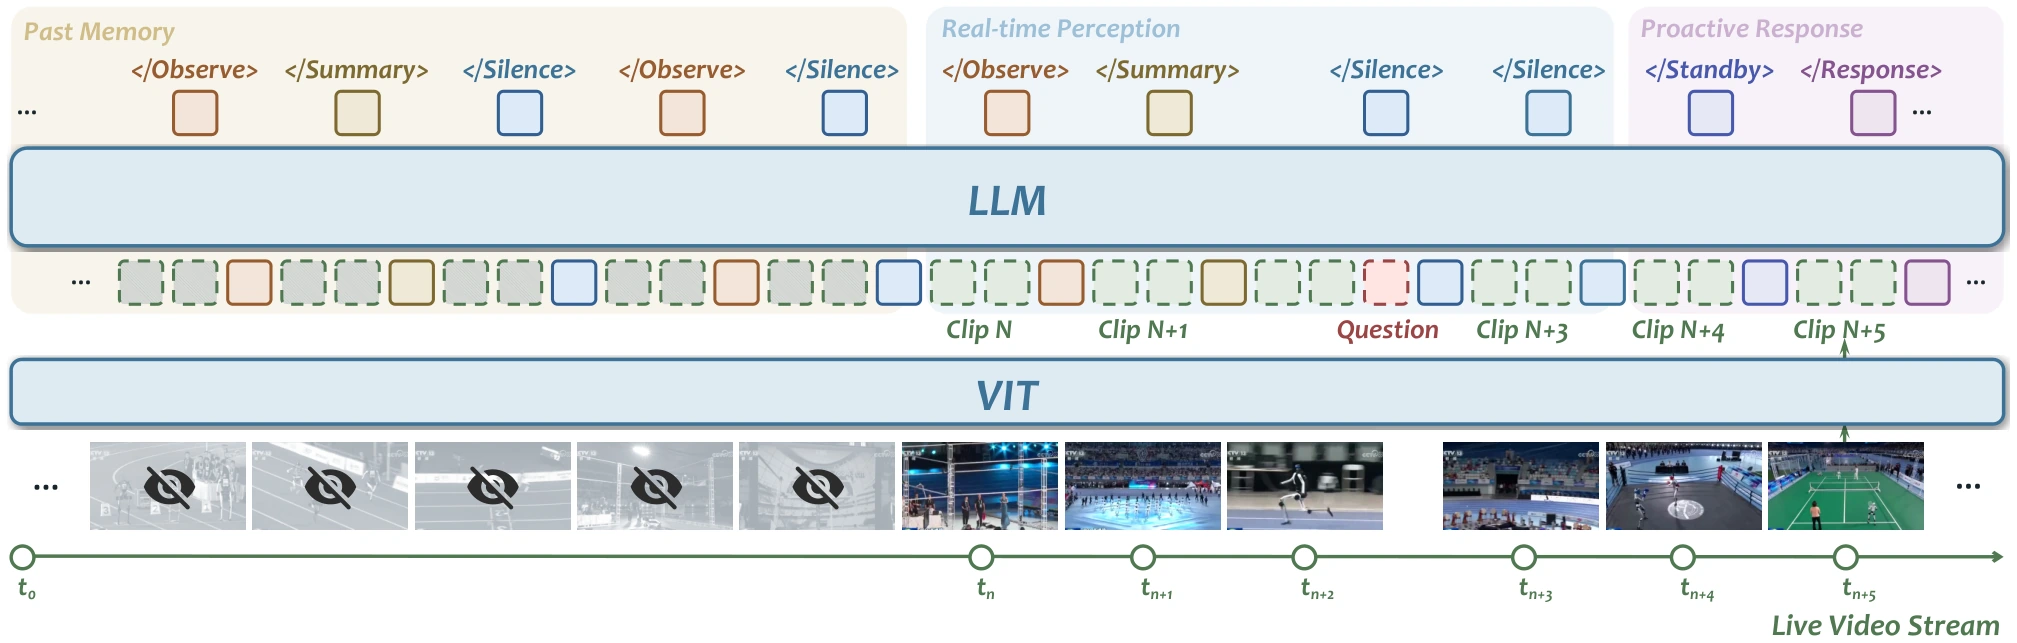
图 1. 近期视觉窗口、历史文本与主动响应的统一结构。图源:原论文 Figure 3。
2. Insight:描述既是感知监督,也可以成为未来证据
2.1 记录必须早于问题,但晚于证据
有用的记忆不能只围绕已知问题生成,否则未来没有问到的事实可能永远不被保存;它也不能提前引用尚未出现的事件。论文要求局部描述在支持它的片段被观察后发布,事件摘要在对应事件完成后发布。
这使记忆成为带来源时间的事实记录。它仍是有损压缩:没有写进文本的颜色、数量或细微状态,之后无法通过“检索记忆”重新获得,文本写错也可能污染后续回答。
2.2 等待状态不能淹没输出状态
视频的大多数时刻无需讲话。若对每个时间点的等待标记等权训练,模型容易学会一直沉默;只训练状态变化,又可能缺少何时应继续等待的信号。OneStreamer 同时保留所有输出锚点,并选择代表性的状态变化与持续样本。
3. Method:PHCM 与 PSTL 如何协作?
3.1 分层描述记忆
Proactive Hierarchical Caption Memory(PHCM)保留两种文本:</Observe> 引出物体、动作和局部状态的描述,</Summary> 引出已完成事件或片段的摘要。记录带来源区间,并在原始帧离开近期 FIFO 窗口后继续留在文本历史中。
当前预测接收近期视觉 token、全部已累积的记录和允许使用的对话。历史视觉特征不被重新检索。视觉窗口的开销受到限制,文本历史本身仍会增长,不能把它理解成无限长视频的固定内存保证。
任务响应另外使用 </Standby> 表示相关证据正在出现、尚不足以回答,</Response> 生成用户可见输出,</Silence> 继续观察。内部记录和用户回答因此有不同的输出语义。
3.2 状态转移监督
PSTL 按相邻控制状态的转移 分组。记任务输出锚点集合为 ,一次训练序列的监督配额为:
较小组全部保留,较大组随机采样到配额。输出锚点都受到监督,高频沉默则受到限制。未选状态 token 仍存在于因果输入中,只是排除其状态损失;描述与答案文本保留完整监督。推理时直接预测状态,不另运行这个采样规则。
3.3 数据还要校准“什么时候可以答”
OneStreamer-1M 将合成的流式描述与问答、清洗的开放数据结合。问答先定位证据区间,再在候选时间点用已观察前缀检验答案支持,选择接近可靠峰值的较早时刻。构造器还过滤在对应前缀中答不对的样本。
训练从 Qwen3-VL-4B-Instruct 开始,冻结视觉编码器,更新 projector 和语言模型一个 epoch,最长序列 131,072 tokens,使用 32 张 H200。标注器参与事实与时机校准,最终性能不能只归因于记忆接口。
4. Experiments:感知、记忆和时机有不同指标
4.1 八项基准的整体结果
下面摘录原论文 Table 1。各列采用各自官方指标,ViSpeak 的量表与其他列不同,不能直接求一个未经定义的百分制平均。
| 基准 | Qwen3-VL-4B | OneStreamer-4B |
|---|---|---|
| OVOBench Overall | 58.8 | 72.1 |
| StreamingBench Real-Time | 81.8 | 86.9 |
| OVBench | 55.4 | 66.8 |
| ODVBench | 57.6 | 71.3 |
| ProactiveVQA | 34.3 | 48.7 |
| OmniMMI | 29.4 | 36.6 |
| OVO-Timing F1 | 29.4 | 41.6 |
| ViSpeak | 2.41 | 2.87 |
论文对部分对照直接引用公开结果,其他模型使用官方设置和 OneStreamer 设置分别重评,按整个基准选择更好的完整结果。这个设计尽量避免配置不利,但仍不是全部系统在同一训练数据和总计算下的比较;OmniMMI 的部分任务还包含 ASR 输入。
4.2 相同窗口下,记忆究竟增加了什么?
Table 2 固定 checkpoint 和 Recent-16 原始帧窗口,只改变是否保留记录。OVOBench 的 ASI 从 63.5 升至 71.6,Overall 从 70.1 升至 72.1;StreamingBench Real-Time 从 86.3 升至 86.9。
相比全视觉历史,PHCM 的 ASI 更高,但 EPM 是 62.6,对照 Full 为 63.0。应当保留这个小幅不足,而不是概括为每种记忆任务都胜出。附录进一步表明,局部描述贡献了多数单独增益,事件摘要提供互补信息。
4.3 少量监督有效,关键在选择规则
Table 3 中,密集 CE 状态监督的 OVO-Timing F1 只有 1.5;频率平衡的 Focal 为 26.5。PSTL 仅监督 27.5% 的状态 token,达到 41.6;同样比例的随机稀疏监督只有 1.4。由此可见,降低监督数量本身不是原因,输出锚点与转移分组才是主要设计。
4.4 在线成本与纠错仍需检查
附录 E.3 在单张 H200 上重放一段 360 秒视频,每秒更新一次,使用 32 秒、4 fps 的近期窗口。PHCM 平均每次更新 0.636 秒,FIFO 控制为 0.472 秒,全视觉历史为 4.013 秒;PHCM 峰值显存为 10.327 GiB。
这次压力测试包含解码、预处理、视觉编码和语言推理,支持该设置能够跟上输入。但只测了一段视频,不能保证不同场景、并发和更长历史下的所有更新都满足截止时间。
失败案例中,模型把打开打印机盖描述成关闭,后续帧已经显示打开状态,却持续输出沉默而未修正。主动回答不仅要决定“何时说”,还需要决定“何时撤回或更新已经说过的事实”。
5. Conclusion
OneStreamer 将记忆构建本身纳入训练,而不是在模型外临时加一个摘要提示。它用近期视觉保留当前细节,用有时间依据的文本记录保存过去,并学习何时等待与响应。
对第一视角助手,下一步可以固定视觉和文本预算,评测漏记、错记、跨事件实体关联和错误修正,并要求回答能回指记录的来源时间。这样的检查能区分模型只是记住了一句描述,还是保留了足以支持后续决策的证据。
References
- OneStreamer: Unifying Perception, Memory, and Proactive Response in Streaming Video Interaction, arXiv:2610.01762v1, 2026-10-01.