作者:Bingxuan Li、Siqi Song、Yizhuo Wu、Jiarui Yao、Tong Zhang、Huan Zhang
单位: University of Illinois Urbana-Champaign
1. Motivation:通用视觉推理怎样进入机器人闭环?
通用 VLM 能识别目标、解释指令,却未必知道该移动哪个关节、如何保持抓取或何时停止。一种常见方案是让它调用机器人动作模型,另一种是让编程 Agent 生成控制代码。MotorMind 研究更直接的接口:VLM 提出可解释的中层动作,确定性控制器负责执行。
论文不进行任务专用策略训练,重点是接口、观察反馈、监控和恢复能释放多少现有模型能力。
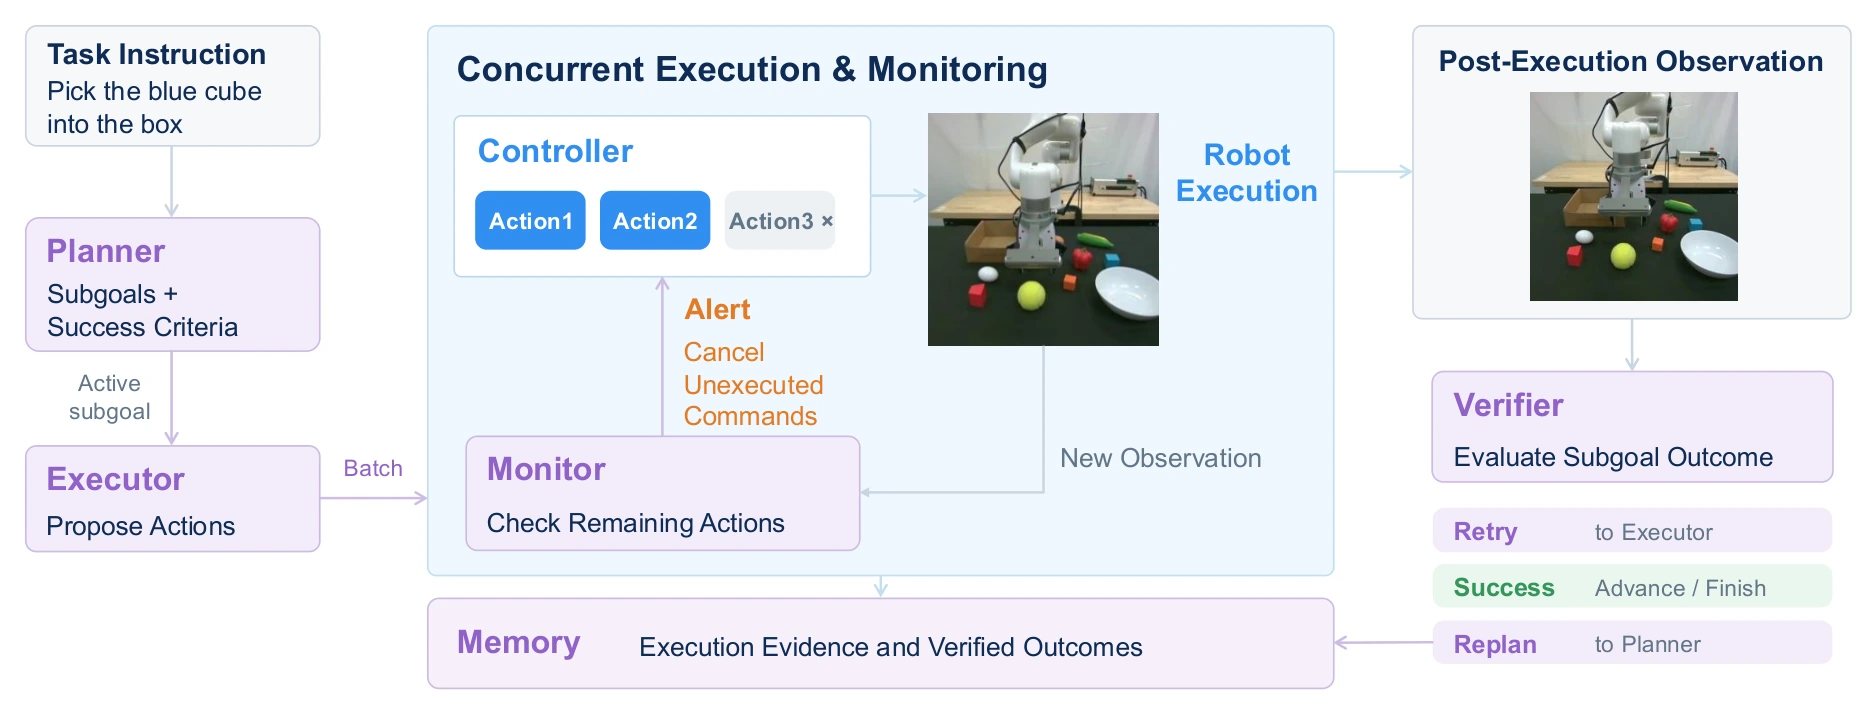
图 1. 顺序动作决策与并发监控、记忆更新。图源:原论文 Figure 3。
2. Insight:中层动作与完成证据都需要明确接口
2.1 中层表达降低动作构造难度
“沿左方向移动若干距离”“旋转一个角度”“关闭夹爪”比关节动作 token 更接近 VLM 熟悉的空间概念。控制器将这些参数转换到具体本体,而 VLM 根据新观察决定下一段动作。
这个接口没有消除视觉定位。模型仍需要从图像确定目标和方向,错误的框或坐标会使语义上正确的动作落在错误对象上。
2.2 执行停止、子目标完成和任务成功不同
执行者发出完成信号,只触发结果检查。验证者还要确认对象确实被拿住、移动后仍保持抓取、最终状态满足指令;仿真任务最终由环境谓词判断成功。
异步监控同样不直接宣告成功或失败。它发现异常后请求停止,控制器在下一个动作边界取消待执行命令,再用新证据决定恢复。
3. Method:五种职责围绕同一冻结 VLM 协作
3.1 参数化动作和测得的反馈
Planner 将任务拆成有目标描述和成功条件的子目标。Executor 根据图像、工具姿态、夹爪状态、测得的位移、历史与记忆,输出动作批次及预期结果。核心动作是 move、rotate 和 gripper,包含方向、距离、角度等参数。
需要定位时,VLM 给出带标签的图像框;兼容固定相机进行三角化,腕部近景还能修订估计。目标偏移、视角分歧和不确定性返回给执行者。因此,系统没有额外 SAM3 等学习式 grounding 工具,但包含相机几何和机器人测量,并非仅凭一句高层提示控制。
3.2 监控与记忆在主回路旁并发
主回路的观察、决策和动作批次仍顺序执行。Monitor 在后台读取更新画面,异常时发出 STOP;Verifier 在尝试结束后判断子目标和任务状态,必要时重试或重新规划。
Memory 在结果检查后后台摘要,下一阶段读取最新已完成记忆,不等待当前摘要请求。迟到的旧监控结果被丢弃,防止已经结束的子目标影响新执行。
这是一套围绕顺序动作决策的并发调度,不等于 VLM 在低层机器人控制频率上持续推理。
4. Experiments:零样本、动态变化与真机分开比较
4.1 LIBERO-PRO 主结果
主表使用 Qwen3.8-Flash-Next。下面摘录原始表中的成功率和平均墙钟时间;微调组表示其底层策略曾接受任务专用训练,Agent 的测试时迭代不等于微调。
| 方法 | 策略设置 | 基础成功率 | 扰动成功率 | 基础墙钟时间 |
|---|---|---|---|---|
| CaP-X,10 loops | 零样本 | 13.3% | 19.2% | 346.4 s |
| MotorMind | 零样本 | 66.7% | 53.8% | 223.4 s |
| OpenVLA-OFT | 已微调 | 98.3% | 51.2% | 5.7 s |
| MolmoAct2 | 已微调 | 100.0% | 62.9% | 6.6 s |
MotorMind 超过所测零样本对照,扰动下接近部分微调策略;基础任务的成功率与速度仍明显低于强微调策略。不同模型、输入和接口同时变化,不能只把跨系统差距归因于异步调度。
论文的 TimeScore 定义为 , 使用 0–100 的百分数,单位是百分点/分钟,不是账单效率或计算成本。短失败也会减少平均时间,所以必须和成功率一起读。
4.2 动态任务在模型等待时继续变化
四组适应任务包括动态推理、目标或目的地移动、传送带操作和执行中改指令。MotorMind 成功率分别为 70%、90%、80%、60%,最后一组与最佳对照持平;前三组分别含 10、10、5 个任务,改指令含 5 个。
附录说明环境在规划和模型等待期间按墙钟推进,20 Hz 下每累计 0.05 秒执行一仿真步。这个条件使响应延迟有实际后果。部分评分谓词没有完整覆盖所有中间指令条件,例如炉灶任务未独立验证每个中间放置要求,应限制对完整语义完成的解释。
4.3 真机 95% 对应特定任务集合
xArm6 配合 RealSense D455 测试三种物体到碗或盒子的搬运,每个物体—目的地组合在直接任务与人工扰动下各测十次,共 120 次。合并成功率为 95%,不是全部语义任务的共同平均。
另外四个语义理解任务各测五次,成功率为 80%、100%、100%、60%。这组样本小,不能把 95% 套用于任意语义关系或复杂操作。
4.4 恢复重要,但定位仍是主要失败源
移除重新规划使平均成功率从 66.7% 降到 36.7%,移除验证为 60.0%,移除规划者为 0.0%。这些消融说明特定系统中的职责有用,尚未单独隔离每项职责的调用成本。
换用 GPT-6 Sol 的小规模骨干比较,平均成功率升到 83.3%,墙钟时间也增加。错误分析中,grounding 与过早完成是主要类别。原文部分图表、正文和附录的套件计数存在不一致,本文保留主结果表的聚合率,不据其推算未经一致核对的仿真总试验数。
5. Conclusion
MotorMind 表明中层动作、测得的反馈与可取消执行,可以把通用 VLM 能力落实到一定范围的零样本机器人操作。最有说服力的收益来自任务完成证据和恢复,而不是把模型的完成声明直接当成成功。
后续可以固定 VLM、动作接口和场景,分别比较同步与异步、定位方法和观察频率,并测量异常出现到停止的延迟。对更复杂任务,还需补齐中间条件的独立验收,才能判断机器人是否完成了原始指令的每一项要求。
References
- MotorMind: Scaffolding General Vision Language Models for Zero-Shot Robot Manipulation, arXiv:2609.38078v1, 2026-09-29.