作者:Zhe Qian、Ziyang Gong、Zhongxing Xu、Hehan Li、Zhonghua Wang、Fei Luo、Mingxuan Wang、Xue Yang、Shiwei liu、Yanbiao Ma、Junchi Yan、Jungong Han
单位: Renmin University of China、Baidu、Shanghai Jiao Tong University、Monash University、ELLIS Institute Tübingen、Max Planck Institute for Intelligent Systems、TierFlow Team、Tsinghua University
1. Motivation:视觉推理的深度一定要靠更多参数吗?
看一张复杂图像,可能先定位目标,再根据问题重新检查文字、数量和空间关系。常规 Transformer 为不同深度存储不同参数,扩大有效计算通常也扩大模型。LoopVL 研究另一种选择:反复应用相同模块,让视觉语言状态继续变化。
它并不是让模型多写几段文字思考,而是在骨干内部循环。论文同时训练循环架构并检查中间状态,尝试说明共享层在不同轮次怎样改变读取视觉证据的方式。
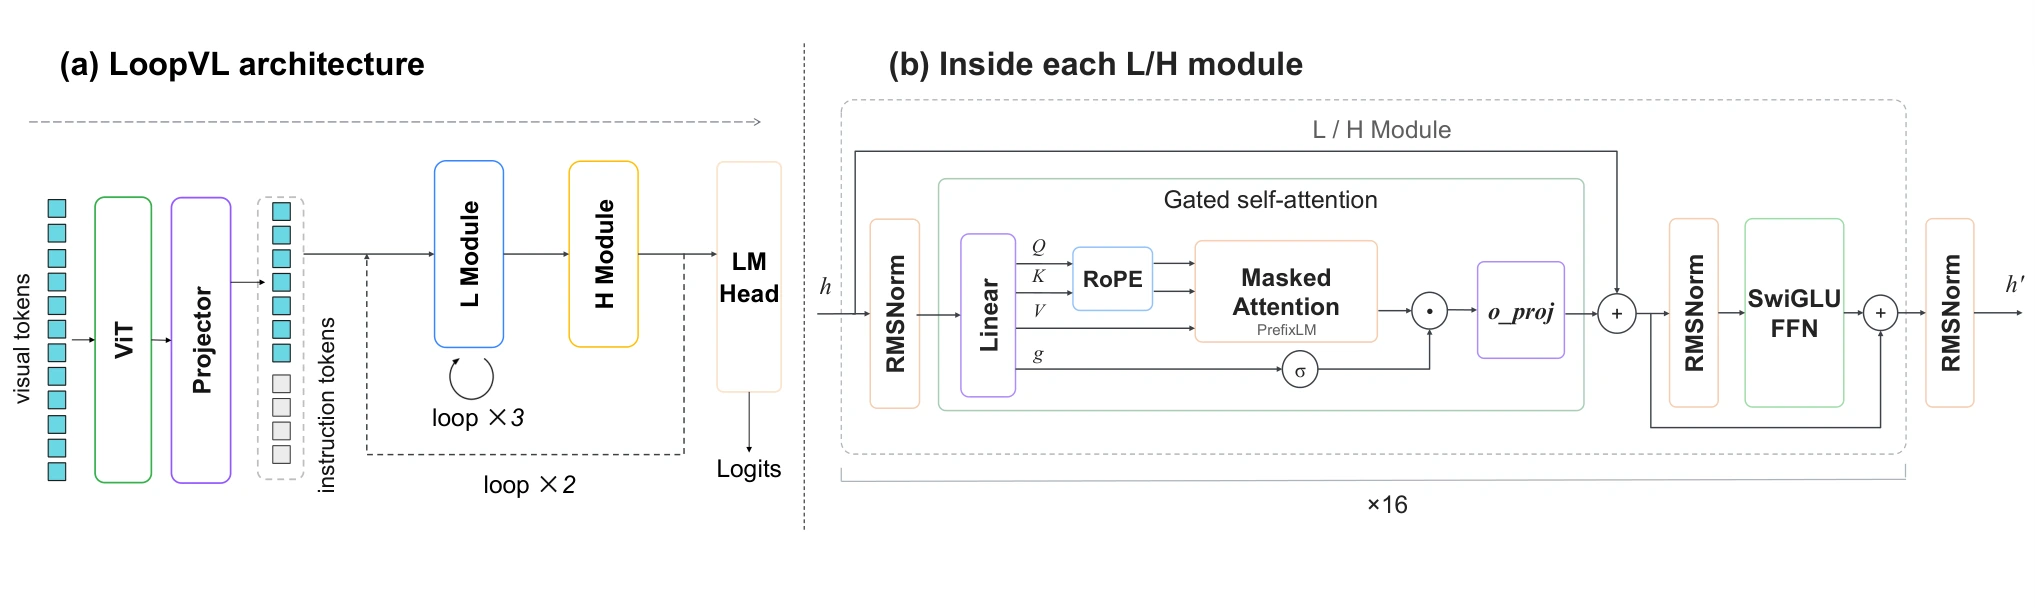
图 1. 模块循环与模型循环,以及 L/H 模块内部结构。图源:原论文 Figure 2。
2. Insight:共享参数节省存储,计算仍有成本
2.1 状态变化让同一层承担不同读取行为
相同变换作用在不同隐状态上,可以读取不同区域。第一轮没有关注的文字,第二轮可能因为问题状态已被整理而获得更高权重。论文用对齐的层和位置观察这种跨轮变化,称明显的视觉注意力重分配为 Visual Aha Moment。
这是注意力行为的命名,不能直接解释为人类式顿悟。注意力集中、位置排序改变和答案正确,是相关但不同的观察;一张热图也不足以确定某层永久承担某种语义功能。
2.2 推理循环应当与训练匹配
反复调用共享层可以增加有效深度,但模型没有自动学会任意轮数的状态更新。过早读出可能尚未形成合法答案,额外循环也可能使状态偏离训练分布。LoopVL 的消融恰好表明,多算几轮并不一定提高成绩。
3. Method:L/H 如何更新统一多模态状态?
3.1 两个模块,八次调用
冻结的 Penguin Vision Encoder 生成视觉特征,两层 GELU projector 将其映射到语言空间。L 和 H 分别包含 16 层 Transformer,两个模块各自共享参数,但 L 与 H 彼此不共享。
默认 H2L3 的顺序是:
一轮前向执行 128 次 Transformer 层调用,只存储两套共 32 层的参数。L 状态在较稳定的 H 条件下反复更新,H 再整合 L 的结果,成为下一轮的条件;最终从 H 状态生成答案。
图像、指令和头部 token 使用双向可见的 PrefixLM 前缀,回答只能读取前缀和已生成回答。视觉位置采用二维空间 RoPE;每轮开始还通过问题相关的门控重新注入初始视觉 anchor,帮助状态更新保留输入依据。
3.2 语言骨干从头训练,视觉编码器不是
语言预训练使用 75B tokens,随后进行视觉语言对齐、49B tokens 多模态中训练、16.81B tokens SFT 和视觉强化学习。对齐阶段只更新视觉接口,后续更新语言模型与接口,视觉编码器保持冻结。
默认训练使用选择性的反向传播,逐步把梯度图扩展到后面五次模块调用;更早调用仍做前向计算,但不参与该反向图。这个安排影响训练成本,所以不能从 128 次前向调用直接推算完整训练 FLOPs。
3.3 保留初始视觉和持续更新视觉是两件事
Anchor 提供固定输入参照,循环隐状态则持续处理它。论文还训练去掉 anchor 与 gate 的模型,以及全循环传播梯度的模型,跨轮注意力集中变化仍存在。这说明所观察现象不完全依赖某个门控或默认梯度路径。
4. Experiments:收益来自怎样的计算配置?
4.1 相同 token 预算下的架构对照
原论文 Table 1 将所有模型放在 0.14T 训练 token 预算下,使用相同 Transformer 块设计:
| 模型 | 训练 FLOPs() | MMStar | RealWorldQA | ChartQA |
|---|---|---|---|---|
| Transformer-VL 1B | 0.92 | 55.33 | 55.29 | 51.12 |
| Transformer-VL 4B Deep | 2.89 | 61.33 | 66.54 | 75.24 |
| Transformer-VL 4B Wide | 2.99 | 60.47 | 66.01 | 75.56 |
| LoopVL | 2.47 | 63.47 | 70.98 | 74.52 |
LoopVL 全面超过单次执行的 1B 对照,但训练计算约为其 2.7 倍。相对 4B 模型,它在 MMStar 和 RealWorldQA 更高,ChartQA 略低,VMCBench 与 AI2D 也没有全面胜出。证据支持参数复用的竞争力,不能概括为在相同计算下无条件优于扩大模型。
4.2 训练时组织顺序有影响
Table 3 的各变体从初始化独立训练。H1L3 和 H2L1 都执行 64 次层调用,但 MMStar 分别为 58.13 和 60.80,ChartQA 为 60.40 和 65.12。相同展开深度不等于相同更新顺序,循环如何分配给 L/H 本身影响能力。
4.3 推理时增加循环可能退化
Table 4 固定 H2L3 checkpoint,改变推理顺序:
| 推理配置 | 层调用数 | MMStar | RealWorldQA |
|---|---|---|---|
| H2L1 | 64 | 29.40 | 12.81 |
| H2L2 | 96 | 51.33 | 58.95 |
| H2L3 | 128 | 63.47 | 70.98 |
| H3L3 | 192 | 58.20 | 60.13 |
| H4L3 | 256 | 24.00 | 14.51 |
提前从单轮读出还会大量产生不可解析响应。因此,这组结果描述的是固定 checkpoint 对推理调度的敏感性,不能用来否定独立训练的单轮模型,更不能宣称推理深度已经能够任意扩展。
4.4 注意力诊断提供机制线索
第二轮的视觉注意力熵下降、Gini 集中度上升,部分初轮低排序位置进入第二轮高排序集合。与此同时,视觉隐状态仍持续更新,最终回答分布在最后 H 调用中快速接近终态。
这些诊断区分总视觉注意力质量与图内分布:总质量减少,也可能同时更集中。热图中的参考框是人工标注,不是模型预测框;选定案例不能估计现象出现频率,也不能单独证明集中位置提供了答案所需的因果证据。
5. Conclusion
LoopVL 展示了共享参数可以支撑更深的多模态计算,并通过不断更新的状态改变同一层的视觉读取行为。最有价值的对照,是把参数、训练 token、FLOPs 和执行顺序共同列出来,才能判断模型究竟节省了什么。
后续可以用同计算训练的架构对照,结合区域替换和反事实图像检查循环中的证据变化,再学习可停止的更新机制。如果要动态分配循环,训练阶段也需要覆盖这些调度,不能只在推理时简单重复已经训练好的模块。
References
- LoopVL: Recurrent Visual Intelligence, arXiv:2609.38426v1, 2026-09-29.