作者:Wei Huang、Bohan Zhang、Chenzhi Liu、Isabella Liu、Shuai Yang、Weian Mao、Luozhou Wang、Yicheng Xiao、Weifeng Lin、Qixin Hu、Bryan Chu、Sifei Liu、Linxi Fan、Xiaojuan Qi、Song Han、Yukang Chen
单位: NVIDIA、MIT、University of Hong Kong、UC San Diego
1. Motivation:机器人需要历史,也必须及时行动
单张图能显示杯子在哪里,却未必能说明它朝哪里移动;当前画面可能与十秒前几乎相同,任务进度却已经不同。世界动作模型(WAM)希望利用历史预测未来,再根据这个预测生成动作。
长历史也增加编码、注意力和缓存成本。如果新的动作还没算完,物体已经离开抓取位置,预测能力就无法转化为控制收益。Long-WAM 因此同时研究两件事:怎样训练模型使用历史,以及怎样让历史和未来预测在实时执行中保留下来。
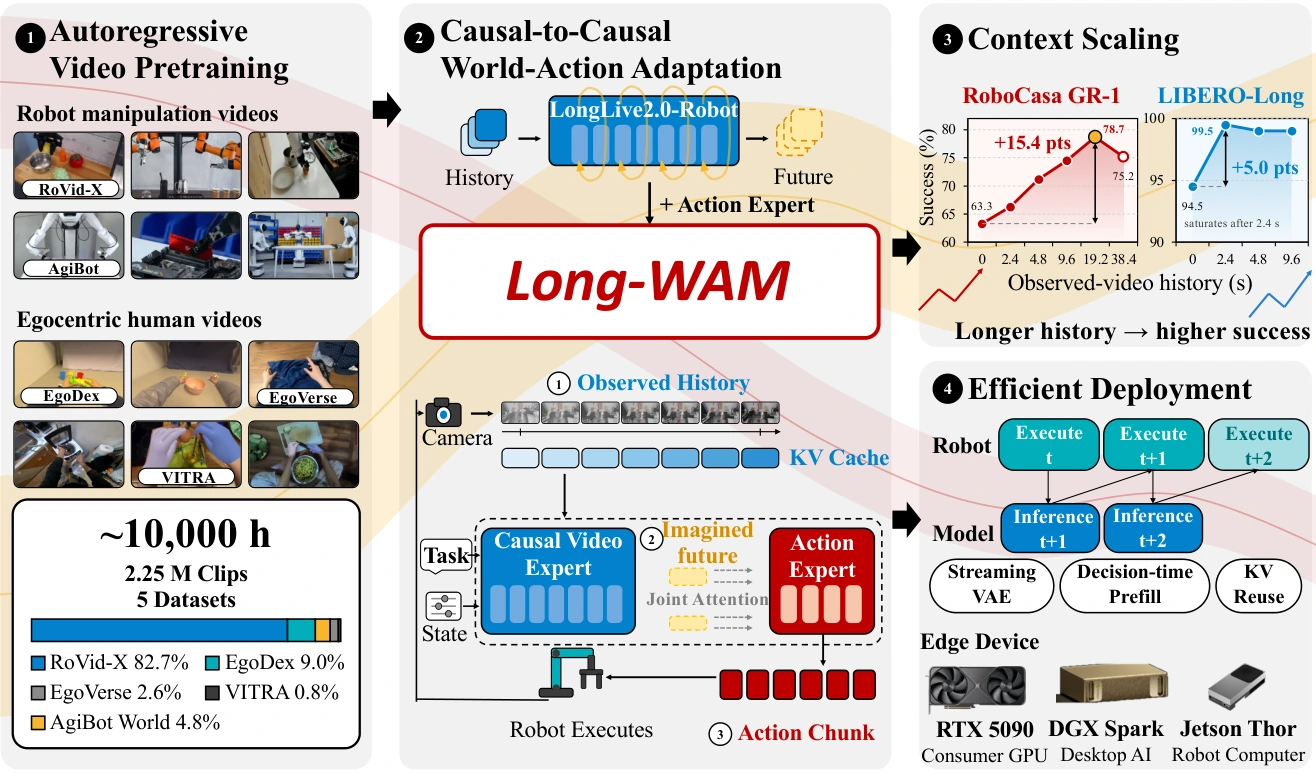
图 1. 视频预训练、动作适配、上下文扩展与执行优化。图源:原论文 Figure 1。
2. Insight:有历史输入,不代表学会历史依赖
2.1 因果关系需要在动作适配前学到
将双向视频模型改成因果 mask,能够限制它看什么,却不会自动赋予“从过去预测后续”的能力。论文比较双向、通用自回归和机器人领域自回归初始化,发现长上下文的收益明显依赖视频预训练方式。
这使历史长度成为一个有条件的资源:任务要需要历史,数据要覆盖相关时间跨度,模型也要学会使用它,才能把更大的窗口变成更高成功率。
2.2 未来表征不必完整解码成视频
控制需要的是支持动作的未来特征,不一定是人能观看的完整未来影片。Long-WAM 在较高噪声水平停止视频去噪,利用层级 KV 作为动作条件,省去像素解码。它仍然进行了未来 latent 预测,并非删除世界模型分支。
3. Method:预测、动作与异步执行怎样连接?
3.1 视频预训练没有要求统一动作空间
LongLive2.0-Robot 从 LongLive-2.0 的自回归 checkpoint 继续训练,数据涵盖机器人与第一视角视频,约 10,000 个窗口等价小时,序列最长 30 秒。这个口径包含窗口统计,不能直接等同于完全去重的原始录像时长。
视频训练不需要动作标签,因此可以混合不同本体。分块因果训练从历史预测目标,缓冲误差扰动则模拟 rollout 偏差,使模型学习恢复到原始目标。该阶段使用约 30,720 H100 GPU-hours,后续 WAM 在 GB200 上训练。
3.2 视频和动作采用非对称可见性
视频 query 只读取自身和更早视觉块,不读取动作 token;动作 query 可以读取已观察历史、部分去噪未来和整段动作。记历史为 ,部分未来为 ,接口可以概括为:
是历史与预测的视觉 cache, 是指令, 是机器人状态。训练的动作分支读取加噪的真实未来作为代理条件,视觉 cache 分离梯度;推理改为模型预测未来,四步视频去噪在 停止,随后用该 cache 生成动作。
3.3 流式编码与动作重叠
系统提前编码到达的历史帧,使触发新动作推理时不用重新处理整个窗口;推理与已有动作段执行重叠。新动作到达时,丢弃其中已经过时的前缀,再执行与当前时刻对齐的后缀。
如果可执行前缀长为 ,推理间隔为 ,控制周期为 ,剩余准备时间满足:
缩小重叠可减少动作不一致,但给推理的时间也更少。NVFP4 视频计算、CUDA Graph、缓存复用与不同硬件的算子调优用于满足这一截止时间;动作计算和 KV 存储仍保持 BF16。
4. Experiments:历史、未来与系统收益分开看
4.1 长上下文收益依赖初始化和任务
在 RoboCasa GR-1 上,机器人领域 AR 初始化从零历史的 63.3% 升至 19.2 秒历史的 78.7%;从 2.4 秒扩到 19.2 秒是 66.3% 到 78.7%。相同因果 WAM 适配下,双向初始化从 2.4 秒的 61.7% 到 19.2 秒的 61.6%,没有相应增益。
LIBERO-Long 在 2.4 秒历史已获得大部分收益,机器人领域 AR 从 94.5% 升至 99.5%。因此,19.2 秒不是全部任务的统一最优窗口。每个窗口分别训练模型,并在对应窗口上评价,也不是对一个 checkpoint 直接增加推理历史。
38.4 秒窗口的 GR-1 成功率下降至 75.2%,80.4% 抽样历史帧属于填充。论文提出数据覆盖不足的解释,这仍是假设;不能把下降全部视为模型已触及内在记忆上限。
4.2 未来预测与高层规划各有贡献
LIBERO 主结果中,IDM 的 Long 成功率为 99.5%,不预测未来的版本为 94.5%,共同去噪版本为 95.8%。其他主基准中,RoboTwin 2.0 平均达到 94.4%;动态数据微调后的 DOMINO 成功率为 34.9%,Fast-WAM 为 19.9%。这些数字来自不同任务与训练条件,不能合成一个机器人总体成功率。
RoboCasa365 的组合任务另加入 GPT-6 Astra 高层规划:
| 系统 | Atomic-Seen | Composite-Seen | Composite-Unseen | Overall |
|---|---|---|---|---|
| Long-WAM | 67.9 | 15.8 | 6.1 | 31.4 |
| Long-WAM + 高层规划 | 85.6 | 38.8 | 35.0 | 54.4 |
同 checkpoint、同 2.4 秒视觉窗口下,固定每 15 步重查动作的对照在原子任务达到 84.4%,却不能复现组合任务收益。高层规划因此不只是缩短动作执行段,也帮助拆解和检查任务。这部分是系统能力,不能归于 Long-WAM 单模型。
4.3 真机为每条件 20 次
Unitree G1 传送带抓取中,速度从 3.0 到 7.5 cm/s,Long-WAM 成功率为 100%、100%、95%、90%;在 3 cm/s 的动态叠杯中成功 19/20,两个对照均为 0/20。YAM 三项长任务成功率为 80%、80%、85%,每项 20 次。
这支持特定平台、物体和训练条件下的动态与长程操作,还需要更多扰动、场景和失败分析才能推断广泛部署可靠性。
4.4 107.4 ms 对应特定上下文与优化配置
RTX 5090 的 V4/A4 推理从 BF16 eager 的 356.0 ms 降到 107.4 ms,对应成功率从 94.4% 到 93.5%;V2/A2 为 81.8 ms、92.5%。速度改进伴随小幅精度变化。
107.4 ms 对应 2.4 秒历史;扩到 19.2 秒后为 341.0 ms。它是动作块推理延迟,并非全部机器人任务用时。对照模型采用各自原生部署和去噪预算,跨模型速度比也包含配置差异。
5. Conclusion
Long-WAM 把长历史的价值落到预测训练和执行截止时间上。因果 mask、较大窗口和未来分支都需要与训练及系统协作,单独增加输入长度不会自动改善机器人。
后续可以在固定动作与未来 horizon 下,按任务阶段动态选择历史长度,并同时记录成功率、填充比例、推理延迟和动作切换误差。加入高层规划与恢复机制时,还应分别评价高层决策与底层记忆执行,避免用系统整体收益替代模块证据。
References
- Long-WAM: Scaling the Context of World-Action Models, arXiv:2610.10528v1, 2026-10-07.