作者:Xirui Li、Peng Shi、Mingwen Dong、Sheng Zhang、Zhuoyan Xu、Dongkyu Lee、Shuaichen Chang、Yi Xiang、Lin Pan、Jiarong Jiang
单位: University of Maryland, College Park、Amazon Web Services(AWS)
1. Motivation:理解图像之后,能否留下一个可操作的场景?
一张图像中的物体、布局和遮挡关系,可以通过文字描述、检测框或深度图表达。但这些结果通常彼此独立:描述里有一张桌子,不保证分割结果包含它;预测出了深度,也不直接得到可以移动和编辑的对象。若把图像重建为一个显式场景,这些信息就有机会在同一套对象、几何与相机参数中接受检查。
LEGO-Anything 选择的表示是可执行的场景程序。编程 Agent 观察单张 RGB 图像,编写并执行 Blender 代码,查看渲染结果,再修改场景。程序既记录如何构建场景,也允许后续查询物体位置、投影边界和相对深度,或对某个对象进行编辑。
LEGO-Anything 利用模拟器真值直接评估可见表面的几何,让重建结果接受独立于模型自我判断的检查。它不能消除单视图的歧义,却把“模型认为画面里有什么”变成了可以执行和量化的对象。
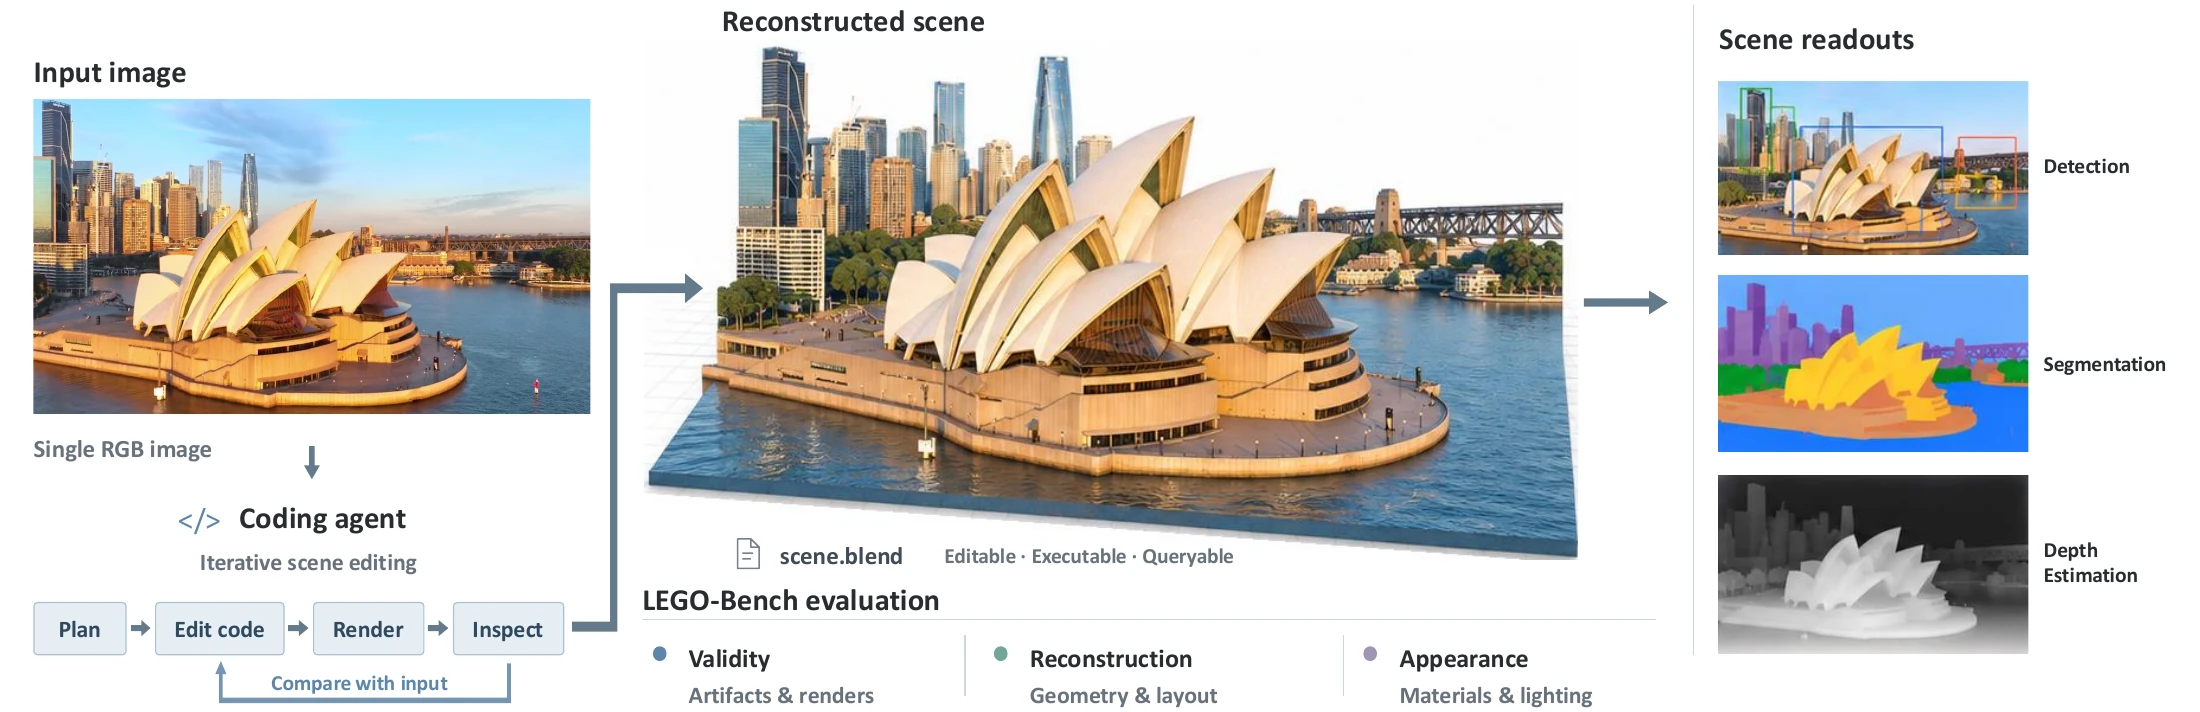
图 1. 从图像到可执行场景,再到视觉任务查询。图源:原论文 Figure 1。
2. Insight:场景能运行、看起来像、几何正确,是三件不同的事
2.1 可执行性是起点,不能替代重建质量
Blender 文件能打开、相机能渲染,只说明交付流程成功。模型仍可能用错误尺度摆放物体,遗漏被遮挡的结构,或用大致相似的颜色掩盖几何偏差。论文因此把评估拆成 Validity、Reconstruction 和 Appearance,分别检查文件是否可用、可见表面是否正确、渲染图像是否接近输入。
这一拆分很重要:实验中六种通用编程 Agent 的文件有效率接近饱和,几何和外观质量却仍有很大差距。继续优化文件生成成功率,未必会触及主要的感知瓶颈。
2.2 迭代需要可靠反馈,也需要保护已经做对的部分
“生成—渲染—自我检查”看似天然形成改进闭环,但后续编辑可能破坏此前正确的相机、尺寸或布局。更困难的是,Agent 未必能从渲染图中可靠判断几何是否变好。如果修改者与裁判共享相似的感知盲点,多轮自我检查也可能反复强化错误。
论文从轨迹中定位三个问题:初始场景建立过慢或不准确、后续编辑导致退步、自由形式的自我评价不可靠。LEGO-Plugin 的设计就对应这三点,将初始化、可测量的参考证据和版本回退接入现有执行框架。
2.3 共享场景可以连接任务,也会共享错误
从同一个场景读出检测框、实例掩码和深度,能够让多个任务的输出对应到同一批物体。但一致性本身不是正确性:如果场景一开始漏掉一个实例,三个任务都会继承这个遗漏;如果轮廓粗糙,检测框可能尚可,像素级分割则会明显受损。
因此,论文既评估合成场景上的重建,也把冻结场景放到自然图像任务中检验。后一个实验回答的是:这种统一表示目前保留了多少可供下游使用的视觉信息。
3. Method:怎样构建场景,又怎样检查它?
3.1 Image-to-Code 与 LEGO-Bench
Agent 在 Blender 环境里交替进行代码编辑、执行和渲染检查,最终提交 scene.blend、scene.glb 与 final.png。基准包含由 104 个模拟器场景渲染的 208 张 RGB 图像,覆盖 8 类环境、17 个主题与 443 个注册资产。部分主题采用嵌套的 Easy、Medium、Hard 对象集合,在固定建筑、材质、光照和相机的情况下增加可见物体。
每次试验向 Agent 提供单张图像及公开元数据,包括分辨率、水平视场角、类别体系和输出要求。参考几何、深度、实例掩码与场景变换由评估器保留。输入具有自然图像风格,但主基准来自模拟器,不能直接等同于真实照片上的重建表现。
3.2 三条评估轴各自测量什么?
Validity 检查 Blender 场景是否包含可渲染几何与活动相机、GLB 导出是否有效,以及预览图是否可解析且非退化。无效交付或无法完成主要评估的尝试记零;几何质量差本身不会被判为文件无效。
Reconstruction 只比较参考视角下可见的对象表面。评估器从提交场景与私有参考深度获得点集,利用参考实例掩码划分对象,并在相机坐标系直接比较,不额外对齐或缩放。匹配容差随参考点深度变化,为 ;逐对象计算精确率、召回率与 F1,再对对象取平均。遗漏表面会降低召回率,落在被评分对象区域内的多余几何会降低精确率。
Appearance 使用评估器重新渲染的图像,而非直接接受 Agent 提交的预览。它统计 RGB 三个通道的绝对误差都不超过 30 的像素比例,通道取值范围为 0–255。因此它同时受到几何、相机、材质与光照影响,也会对像素位置偏差敏感;它不是语言模型给出的审美评分。
记一次尝试的三项结果为 、 和 ,综合分数为:
失败尝试保留在分母中。这个分数衡量交付可靠性与参考视角下的重建质量,没有检验全部不可见结构,也不能直接证明场景具有完整的物理真实性。
3.3 LEGO-Plugin:把改进落实到可检查的局部变化
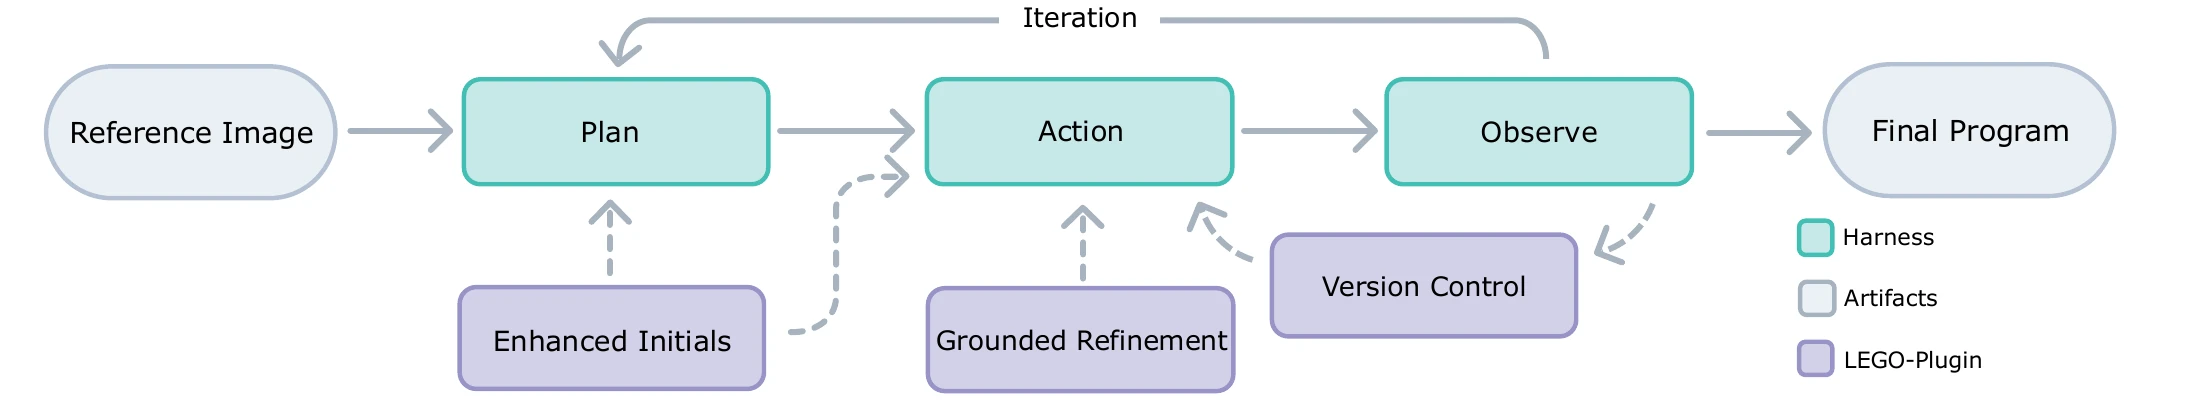
图 2. LEGO-Plugin 的三个模块。图源:原论文 Figure 7。
Enhanced Initialization 利用 VGGT 从参考图像估计场景坐标与相机,再结合可见物体布局形成初始化建议,使最初的几何摆放有明确依据。
Grounded Refinement 使用 SAM 3 提取参考物体区域、Depth Anything V2 提供相对深度,再比较场景投影范围、相对深度等残差。反馈因而对应到具体几何关系,便于 Agent 决定修改哪个对象、哪个参数。
Version Control 将有界编辑作为候选版本,根据这些参考残差决定接受、修复或回退,避免后续修改无声地覆盖此前进展。三个模块通过工具、工作流技能和运行时钩子接入框架,Agent 仍负责规划,Blender MCP 仍负责编辑。
插件不访问基准的私有真值或正式分数,但它新增了专门的视觉模型。其反馈是从输入图像估计得到的代理证据,仍可能受分割、深度和相机估计错误影响;结果也不能解释为完全依靠通用 Agent 自我反思获得的提升。
4. Experiments:提升发生在哪里,证据又覆盖多大范围?
4.1 文件交付接近可靠,几何质量仍受模型能力限制
主实验使用 Blender 5.0.1、Blender-MCP 与 Harbor 执行环境。以下摘录原论文 Table 3 的均值,原表还报告了三次运行的标准差,指标均以百分制展示。
| 模型与框架 | 室内有效率 V | 室内几何 R | 室内外观 A | 室内综合 S | 室外综合 S |
|---|---|---|---|---|---|
| GPT-6-astra + Codex | 100.0 | 52.4 | 54.4 | 53.4 | 39.6 |
| GPT-6-sol + Codex | 99.4 | 22.2 | 42.5 | 32.3 | 24.2 |
| GPT-6-luna + Codex | 99.7 | 15.8 | 30.5 | 23.2 | 17.3 |
这些结果说明,模型差异主要体现为几何与外观保真度。专门方法 Gen3DSR 的室内几何分数为 65.4,高于 Astra 的 52.4,但外观项记为 0,综合分数较低。因此,综合排名不能被改写成 Astra 在每一种重建能力上都优于专门模型。
跨方法比较统一了评分终点,但各方法保留原生流程,并不共享完全相同的工具、计算预算和信息访问方式。它更适合作为端到端系统比较,而不是隔离某个架构因素的消融。
4.2 更多推理与插件收益,都要放回实验子集理解
推理强度实验只使用固定的 42 个 Office 样例。在相同输入、提示、执行预算与评分协议下,Astra 从 Low 到 XHigh 的综合分数由 32.3 升到 61.8;三种 GPT-6 模型都受益,而 GPT-5.6 系列变化较弱或不单调。这说明能否利用新增推理,依赖模型原本的构建与纠错能力。
LEGO-Plugin 同样在这 42 个样例上做有无插件对照。六种模型全部提升,三种 GPT-5.6 模型获得约 55%–63% 的相对收益,绝对提升约 7–8 个百分点;Astra 的相对收益只有 2.1%。摘要中的最高 62.7% 是Office 子集上的相对提升,不能理解为全基准增加了 62.7 个百分点。
4.3 自我评价的几何盲点,为工具反馈提供了动机
给裁判两张同一场景的渲染图,让它选择更好的结果,再检查方向是否与确定性指标一致:自评在几何项上的平均一致率为 45.8%,外观项为 62.2%;换成其他模型裁判时分别为 45.4% 和 63.9%。几何判断接近或低于二选一随机水平,自评没有表现出稳定优势。
这支持引入几何证据,但也需要尊重测试边界:裁判仅看渲染,而几何指标使用场景与私有深度。部分深度错误本来就难以从相似的二维投影区分。结果说明当前视觉自评不足以替代这一几何评估,不意味着模型在所有形式的三维判断上都没有能力。
4.4 一个场景能支持多个视觉任务,但精度仍有缺口
LEGO-World 分别从 COCO、LVIS 与 ETH3D 随机采样 100 张图像,用 Astra 重建场景,不启用 LEGO-Plugin,再从冻结场景投影得到框、掩码与深度。
| 下游任务 | 指标 | LEGO-Anything | 专门模型 |
|---|---|---|---|
| COCO 检测 | Box AP ↑ | 30.14 | DINO:59.88 |
| LVIS 分割 | Mask AP ↑ | 14.75 | SAM 3:53.96 |
| ETH3D 深度 | AbsRel ↓ | 0.1554 | Depth Anything 3:0.0783 |
每项只覆盖对应的 100 图子集。场景导出没有校准后的预测置信度,框与掩码按等置信度协议评估,不能将这些数字直接当作完整官方榜单成绩。它们仍揭示了一个清楚的差异:场景程序能保留部分对象级结构,但精确轮廓与深度还有较大损失,尤其不足以替代专门分割模型。
5. Conclusion
LEGO-Anything 将视觉理解落实为可执行场景,并同时检查交付、几何和外观。它最有启发的地方,是让失败不再只表现为一张“不够像”的渲染图:可以继续追问初始结构是否错误、哪些修改导致退步、反馈是否真正对应到几何。
对空间感知研究,一个值得验证的方向是把对象级证据与场景程序的局部编辑绑定:每次只改变少量可解释参数,用独立的投影、轮廓和关系检查决定保留或回退。这需要区分工具提供了多少额外感知能力,以及编辑控制本身贡献了多少收益;可以固定视觉工具与调用预算,再分别消融初始化、反馈和回退。
单视图下不可见结构仍然不确定,代理分割和深度也可能带来共同偏差。后续若增加跨视角验证、明确记录对象的不确定性,并在更多真实图像上评估共享场景的多任务输出,就能进一步判断这种表示是否同时改善可编辑性、跨任务一致性与实际感知精度。
References
- LEGO-Anything: Coding Agents for 3D Scene Reconstruction, arXiv:2609.36380v1, September 28, 2026.