作者:Yibo Li、Jinhang Qiu、Zhi Zheng、Qianyun Guo、Jiaying Wu、Shuo Ji、Bryan Hooi
单位: National University of Singapore
1. Motivation:熟悉任务的高分,能证明学会了新规则吗?
Agent 能在已知游戏或常见工具任务中取得高分,可能来自预训练知识、成熟提示和工具流程。若要评价从经验中学习,就需要让它遇到尚不熟悉的规则,并观察它如何试探、保留反馈、修订假设和迁移到新实例。
Learn2Play Bench 用 20 个手工编写的隐藏规则文字游戏构造这种情境。其中一些规则故意违背生活常识,Agent 需要根据游戏反馈判断有效动作,而非直接套用现实中的因果关系。
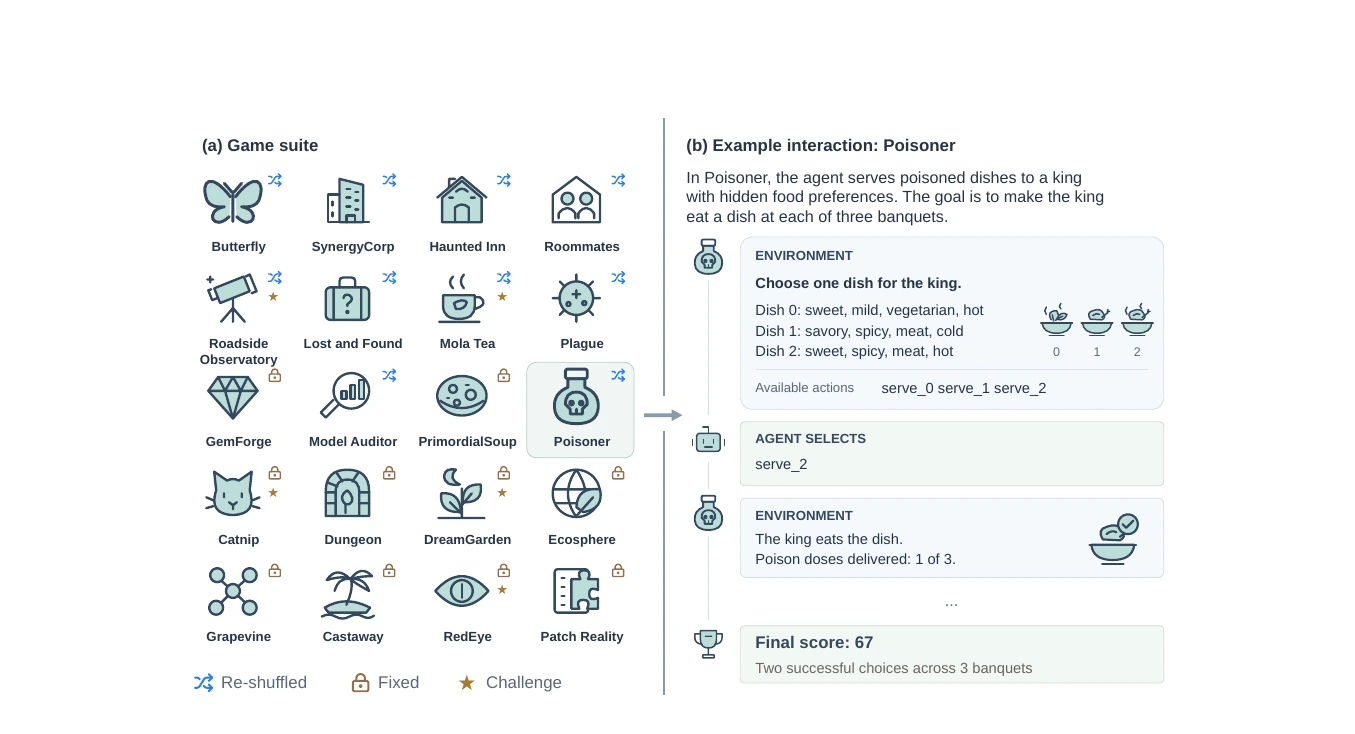
图 1. 游戏套件与通过交互发现规则的示例。图源:原论文 Figure 1,PDF 第 3 页。
2. Insight:学得快、最终高分和经验可迁移需要分别测
2.1 起点高的模型不一定进步最快
一个模型第一局已经解决大部分问题,另一个从低分起步却逐渐发现规则。只看最佳成绩会漏掉学习过程,只看首尾增益又可能奖励低起点。因此论文同时报告达到的表现和跨局改善。
这里的学习发生在上下文、记忆和执行框架中,评测期间不更新模型权重。因此,多局成绩改善说明系统能够利用保留的经验,不能据此推断模型参数获得了新能力。
2.2 原始证据与抽象经验各有代价
完整历史保留了成功、失败与具体条件,模型有机会重新解释证据;压缩规则和工作流更便宜,却可能把偶然关联写成固定结论。尤其在隐藏规则尚未识别充分时,过早概括会影响后续探索。
论文通过同一主干的多种记忆方案检查这一点。结论需要按模型与方法比较,不能从某个主干的结果推出原始记忆永远优于反思。
3. Method:隐藏规则、重复交互与四个指标
3.1 20 个确定性游戏
十个 fixed 游戏跨局重复相同实例,十个 re-shuffled 游戏改变可见实例但保留核心规则。另按先导实验划分五个 challenge 游戏与十五个 normal 游戏,分别评测十局和五局。
Agent 通过黑盒命令接口执行动作、接收文字反馈和终局得分,不能读取游戏源码或 oracle。自动评分与确定性环境便于重放。主评测每个游戏模板使用一个固定种子,做三个独立 trial;trial 之间清空记忆,trial 内的信息保留由框架决定。
人工设计的新规则降低了直接套用常见游戏知识的机会,但不能仅凭设计意图证明全部任务与训练数据完全无重叠。单模板种子的覆盖范围也限制了对广泛环境分布的推断。
3.2 四种成绩对应不同问题
各游戏先按参考分数归一化:
| 指标 | 计算方式 | 评价对象 |
|---|---|---|
| Max | 每个 trial 取局内峰值,再平均这些峰值 | 曾经达到的能力 |
| Mean | 对全部评测局的得分求平均 | 全程表现 |
| Learning Gain(LG) | 最后若干局均分减去最前若干局均分,每端最多三局 | 首尾改善 |
| Learning Slope(LS) | 用每局均分对局数拟合直线,取斜率 | 整段学习趋势 |
Max 不是挑出所有 trial 中最好的一局。LG 每端取 min(3, floor(T/2)) 局,normal 游戏实际取两局,challenge 取三局。
汇总时 challenge 权重为 3、normal 为 1,五个难游戏与十五个普通游戏各占总权重的一半。总体成绩因此不是二十个游戏的等权平均;不同长度曲线映射到统一进度,只用于可视化。
3.3 记忆和执行框架单独对照
Naive 在每局后清空历史;Memory 保留完整交互记录;Reflexion 提炼反思;EvoTest 更新指导提示与状态提取程序;ReasoningBank 形成经验条目;AWM 从成功轨迹中归纳工作流。AWM 不使用失败轨迹,方法间输入证据也有差别。
OpenCode 为模型提供文件、shell 和自由检查计划的能力,模型可以自行决定什么时候回顾反馈和调整方案。论文再固定主干,比较 OpenCode 与 Claude Code/Codex,评价完整 Agent 系统如何影响经验利用。
4. Experiments:模型、记忆、框架与迁移
4.1 高分和学习速度的排名不同
同一 OpenCode 框架下,主结果摘录如下,分数为归一化汇总,LS 表示每局趋势:
| 主干 | Max | Mean | LG | LS |
|---|---|---|---|---|
| Claude Opus 5.5 | 80.1 | 61.0 | 23.0 | 5.22 |
| GPT-6 Astra | 76.2 | 56.1 | 23.8 | 5.88 |
| Claude Opus 5 | 74.5 | 53.8 | 21.3 | 5.13 |
| Qwen 3.8 Max | 72.5 | 51.1 | 25.2 | 6.30 |
| Kimi K3 | 68.5 | 50.2 | 17.1 | 4.24 |
Opus 5.5 的峰值和平均成绩最高,Qwen 3.8 Max 的 LG、LS 更高。这个结果说明最终表现与学习变化不同,也提醒我们改善幅度受到起点和剩余提升空间影响。
日志中的失败不只有记不住规则:有的 Agent 同时改变多种因素,无法隔离因果;有的已经说出约束,行动时仍贪心分配资源;还有的找到一个部分有效策略后停止试探。发现规则、正确规划和持续探索是不同瓶颈。
4.2 简单记忆有竞争力,但优势并不普遍
固定 Kimi K3 后,Memory 的 Max 为 63.3,EvoTest 62.4、Reflexion 61.6、ReasoningBank 59.9、AWM 56.1、Naive 54.7。Memory 的 LG/LS 为 16.9/4.69,也领先这些预设方法;EvoTest 为 1.8/1.01,Naive 为 0.3/0.42。
但 Opus 5 上 EvoTest 的 Max 为 66.1,Memory 为 60.9,排序改变。原始历史能避免过早丢弃证据,并不保证每个主干都最善于重新解释这些记录。
Kimi K3 的 OpenCode 组合还取得 68.5 的 Max,超过以上预设方案。这里同时改变了工具、行动循环和经验处理,不是只增加一个记忆字段的纯消融。将错误概括保存为长期规则的日志案例提供了机制线索,不能单独证明全部成绩差异的因果来源。
4.3 相同主干,换框架会改变表现
原论文 Table 2 的同主干对照为:
| 主干与框架 | Max | Mean | LG | LS |
|---|---|---|---|---|
| Opus 5 + OpenCode | 74.5 | 53.8 | 21.3 | 5.13 |
| Opus 5 + Claude Code | 81.8 | 62.3 | 27.1 | 6.59 |
| GPT-5.6-SOL + OpenCode | 57.0 | 41.1 | 14.5 | 3.71 |
| GPT-5.6-SOL + Codex | 74.3 | 54.8 | 22.2 | 5.66 |
保持主干和评测协议后,框架组合仍影响四项指标。作者将其联系到模型与框架的训练及适配,但实验没有拆分提示、工具设计、历史管理等各因素的单独效应。实际选用 Agent 时,应评价完整组合。
4.4 换实例能检查记住位置还是学会规则
迁移实验对 re-shuffled 游戏另设重复同一实例的 control,统一使用十局、三个 trial,只改变可见实例。Opus 5 + OpenCode 的 LS 从 control 4.10 到重排 3.51,Sonnet 5 从 4.90 到 2.23;Qwen 3.8 Max 反而从 3.16 到 3.57。
变化并不总是降低学习速度。该实验检验核心规则保留时跨实例应用,尚不是迁移到全新游戏规则。重复菜单位置和能解释食物属性规则,属于不同类型的记忆,重排能暴露前者的脆弱性。
4.5 人类最佳记录不是平均人类表现
每个游戏招募 21–30 位参与者,再按 Max 选 Top-1、Top-3、Top-5。Human Top-1 汇总 Max 为 84.3,高于主干比较中最高 Agent 的 80.1;它是每个游戏选出的最佳人类记录,不能表述为普通参与者平均超过所有 Agent。
Top-3 人类在 fixed 游戏的连续动作相似度为 0.54,Agent 为 0.66;低分后下一局创新个人最高分的比例为 33% 与 22%。这些行为相关性提示人类更常改变策略,但不能直接证明更大探索一定带来更高成绩。
5. Conclusion
Learn2Play Bench 把经验学习落实为可重放的陌生规则交互,并同时检查成绩、进步、记忆方式和实例迁移。它表明,保留原始证据、允许模型检查计划和选择合适执行框架,都可能影响学习效果。
评价交互中的学习时,应固定任务和信息预算,检查模型是否从反馈中发现可迁移规则,再区分上下文学习与参数更新。更广的模板种子、较长学习窗口和独立规则审计,会帮助判断现有结果能否推广到开放任务。
References
- Learn2Play Bench: How Well Do LLM Agents Learn from Experience in Unfamiliar Environments?, arXiv:2610.08215v2, 2026-10-08.