作者:Yuhao Wu、Jingyuan Zhang、Jiajun Shi、Xinping Lei、Qingshui Gu、Yuxuan Zhang、Zexuan Wang、Chen He、Chen Huang、Maojia Song、Zhiyuan Zeng、Shaowen Wang、Jinkai Liu、Yunfeng Shi、Jiaheng Liu、Shen Yan、Wenhao Huang、Ge Zhang、Wenxuan Zhang
单位: ByteDance Seed、Singapore University of Technology and Design、Georgia Institute of Technology、M-A-P、TokenWave.AI
1. Motivation:完成一个任务,与造出能持续做任务的系统
一个模型能修改代码,并不意味着它已经具备完整的编程 Agent 能力。真实执行还依赖工具接口、上下文压缩、状态保存、重试、停止条件与结果验证。模型相同,这些外围机制不同,最终任务表现也可能明显变化。这套围绕模型组织执行的软件,通常称为 agent harness。
如果希望模型自动改进 Agent,就需要检验它能否从失败轨迹中识别这些机制的问题,并把修复写成可以在未来任务中复用的代码。一次成功的补丁可能只是照顾了当前样例;一个新加的记忆模块也可能从未进入执行路径。只看几道任务最后是否做对,很难判断系统本身是否获得了持久改进。
HarnessDev 因此把评测对象转向冻结后可以重复运行的执行框架。它研究两个阶段:Creation 从一个弱但可运行的起点创建框架,Evolution 根据下游执行反馈继续修改已有框架。最终评价的仍是框架在实际任务中的表现,而不是代码量、模块名字或模型对自身改进的描述。
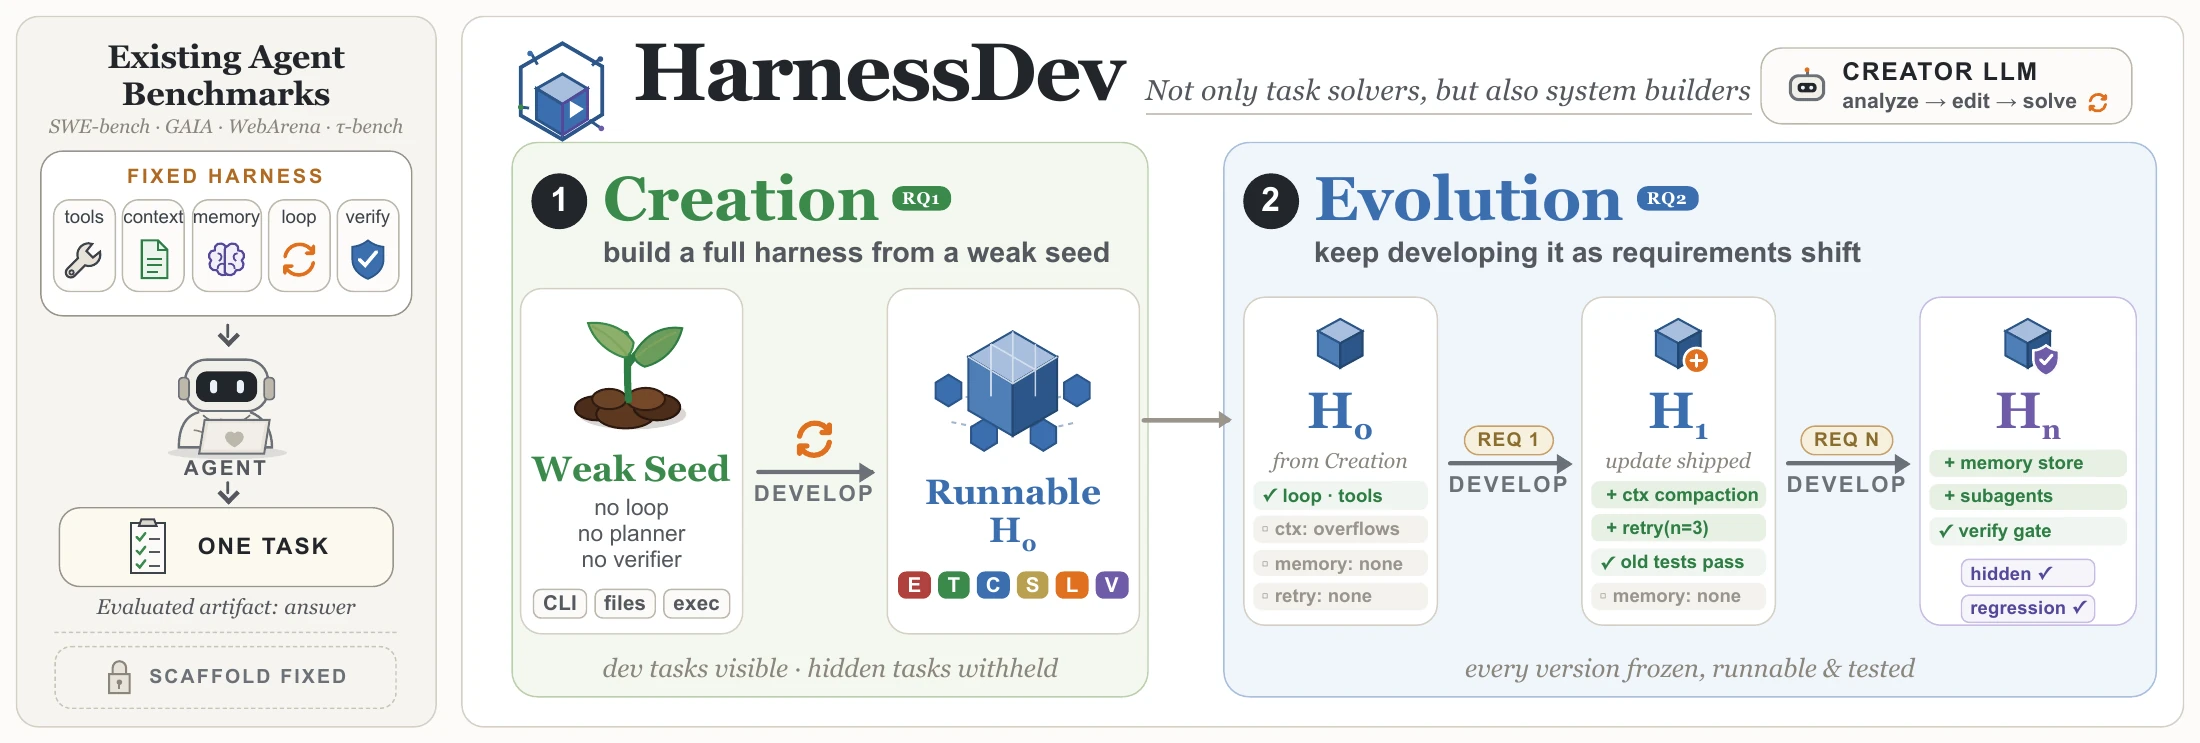
图 1. HarnessDev 的两阶段设计。图源:原论文 Figure 1。
2. Insight:框架质量要通过迁移与真实执行来检验
2.1 创建者与执行者是两个不同角色
创建框架的模型决定提示、控制流、工具协议和停止规则;执行模型则在冻结后的框架中解决任务。如果两者相同,结果混合了框架设计、模型能力和两者的适配程度。一个框架可能恰好适合创建者的输出习惯,却在换模型后过早停止、重复搜索或错误处理工具返回。
论文因此同时报告 Self-Eval 和 Unified-Eval:前者让创建者执行自己的框架,后者把执行模型统一为 Gemini 3.1 Pro。固定执行者能够更清楚地比较框架,但模型与框架仍会交互,因此它并不提供一个完全脱离运行模型的“纯框架能力分数”。
2.2 可见反馈上的改进与新任务上的收益需要分开
Evolution 必须给创建者反馈,否则它不知道哪里失败。但反复查看同一批任务的结果,也可能促使系统适应这些任务的特点。由此产生的分数上涨,可以证明框架学会利用反馈,却不能单独证明改进会迁移。
HarnessDev 将开发阶段可见的反馈集与冻结后才运行的 held-out 集分开,后者的成绩不返回给创建者。这里的 held-out 指从开发循环中隔离,仍来自公开基准;它不代表整个任务域都未见过,也不构成基础模型没有接触过相关数据的证明。
2.3 机制写进代码,不等于机制发挥作用
如果一个框架定义了 State 类,却从不保存或恢复状态,就不能据此认为它已经具备长期记忆。论文将源代码检查与执行轨迹结合,观察机制是否真正进入主路径、是否在正式运行中触发。
这使评测从“有没有某个模块”进一步走向“模块在什么情况下改变了执行”。同样,测试次数多也不必然意味着工程能力强,关键在于是否读懂失败、作出有针对性的修改,并重新验证。
3. Method:怎样让框架成为一个可比较的产物?
3.1 弱种子只提供兼容层,任务策略由创建者补齐
创建者拿到统一的输入输出契约、允许使用的底层工具,以及任务说明、设计教程和 1–3 个开发样例。弱种子可以解析配置、读写文件、调用被动工具并留下日志,但没有解决任务所需的 Agent 循环、任务分解、上下文管理、持久状态、重试或验证逻辑。
未经修改的种子在下游基准上得零分。这个起点避免把大量接口样板工作混入评测,同时也没有预先提供成熟的解题策略。创建者仍得到工程环境与教程,因此 Creation 不能理解为完全没有先验约束的从零发明。
记创建者为 、开发环境为 、生成框架为 、执行者为 ,流程可写成:
框架在评价前冻结;任务 的产物由外部评估器 打分。框架自己写下“成功”不会直接增加分数,例如代码任务检查真实工作区补丁,终端任务检查最终环境状态。
3.2 Creation 覆盖四类场景、五个下游基准
| 领域 | 基准 | 实例数 | 原生指标 |
|---|---|---|---|
| 代码 | SWE-bench Pro public split | 731 | 任务成功率 |
| 代码 | Terminal-Bench 2.1 | 89 | 任务成功率 |
| 机器学习实验 | MLE-bench | 75 | 奖牌分数 |
| 写作 | EQ-Bench3 | 46 | 量规评分 |
| 搜索与研究 | BrowseComp | 1,266 | 回答准确率 |
五个基准共 2,207 个不同实例。论文评估六个创建模型,并对每个创建者与基准组合独立创建、评价三次,报告 avg@3,而非挑选最好的一次。
创建环境主要为 Claude Code 2.1.177,GPT-5.5 使用 Codex 0.144.3。模型和开发环境并未在所有创建者之间完全相同,因此跨创建者排名也包含工具环境与模型使用方式的影响。
3.3 Evolution 的候选必须完成成对评价
Evolution 当前聚焦代码框架,从 Creation 的冻结版本 出发。创建者可以看到固定的 100 道 SWE-Pro 任务与全部 89 道 Terminal-Bench 任务的执行结果。每个正式候选版本必须用同一提交完整跑完这两组任务,才进入正式轨迹。
初始版本之后最多有十次完整评价对;两个收费评价对之间最多使用两次固定小子集探测,每次覆盖两个基准各自的前五题。小探测用于诊断,不作为正式分数。创建者最终声明一个完成正式评价的非初始版本。
所有开发轨迹结束后,再将每个正式版本放到与反馈集不重叠的 630 道 SWE-Pro 任务上评价。成绩不参与修改、停止或最终版本选择。开发反馈分数为两个基准百分制成绩的等权平均,而 held-out 分数只来自 SWE-Pro,二者的任务构成不同。
3.4 效率统计什么,人工参考又代表什么?
论文统计冻结框架完成下游任务时消耗的执行模型 token,不包含创建者开发和修改框架所消耗的 token。因此它衡量部署后的执行效率,没有给出完整的自动开发成本,也不能直接换算成墙钟时间或统一费用。
人工工程框架的参考值来自经过核实的公开系统结果,部分没有在本实验中重跑,且使用不同的框架与模型组合。它们用于展示距离所选成熟系统还有多远,并非所有方法在同一个执行模型下的配对对照;超过参考值也不意味着超过人类能力。
4. Experiments:系统能被创建,但稳定改进和复用仍然困难
4.1 Creation 的差距随领域变化
以下摘录原论文 Table 3 的 Self-Eval 结果,每个分数为三次独立创建的平均,单位为百分制。
| 创建并执行框架的模型 | SWE-Pro | Terminal-Bench 2.1 | BrowseComp |
|---|---|---|---|
| Opus 4.8 High | 69.3 | 64.8 | 52.4 |
| GPT-5.5 High | 32.8 | 52.1 | 52.6 |
| Gemini 3.1 Pro High | 43.6 | 68.8 | 35.2 |
| DeepSeek V4 Pro High | 28.9 | 35.6 | 40.9 |
| Qwen 3.7 Max | 33.5 | 41.3 | 32.3 |
| Seed 2.0 Pro High | 10.8 | 6.0 | 3.2 |
| 所选人工工程系统参考 | 80.0 | 88.8 | 92.2 |
自动构建的框架在代码和搜索研究任务上仍落后于这些系统参考。写作与机器学习实验的情况不同:例如 Opus 的 EQ-Bench3 为 84.6,参考为 83.7;MLE-bench 奖牌分数为 32.9,参考为 24.0。它们说明某些任务族已经可以由模型构造有效执行流程,但不能把不同指标直接混成一种统一成功率。
生成更多代码也不是可靠的进步指标。六种创建者的 18 个代码框架共增加 17,111 行净代码,Gemini 对应的总增量最少,却取得最高的 Terminal-Bench Self-Eval 成绩。这里是观察到的关系,不能进一步推出代码越少表现就越好。
4.2 换一个执行者,框架表现可能反转
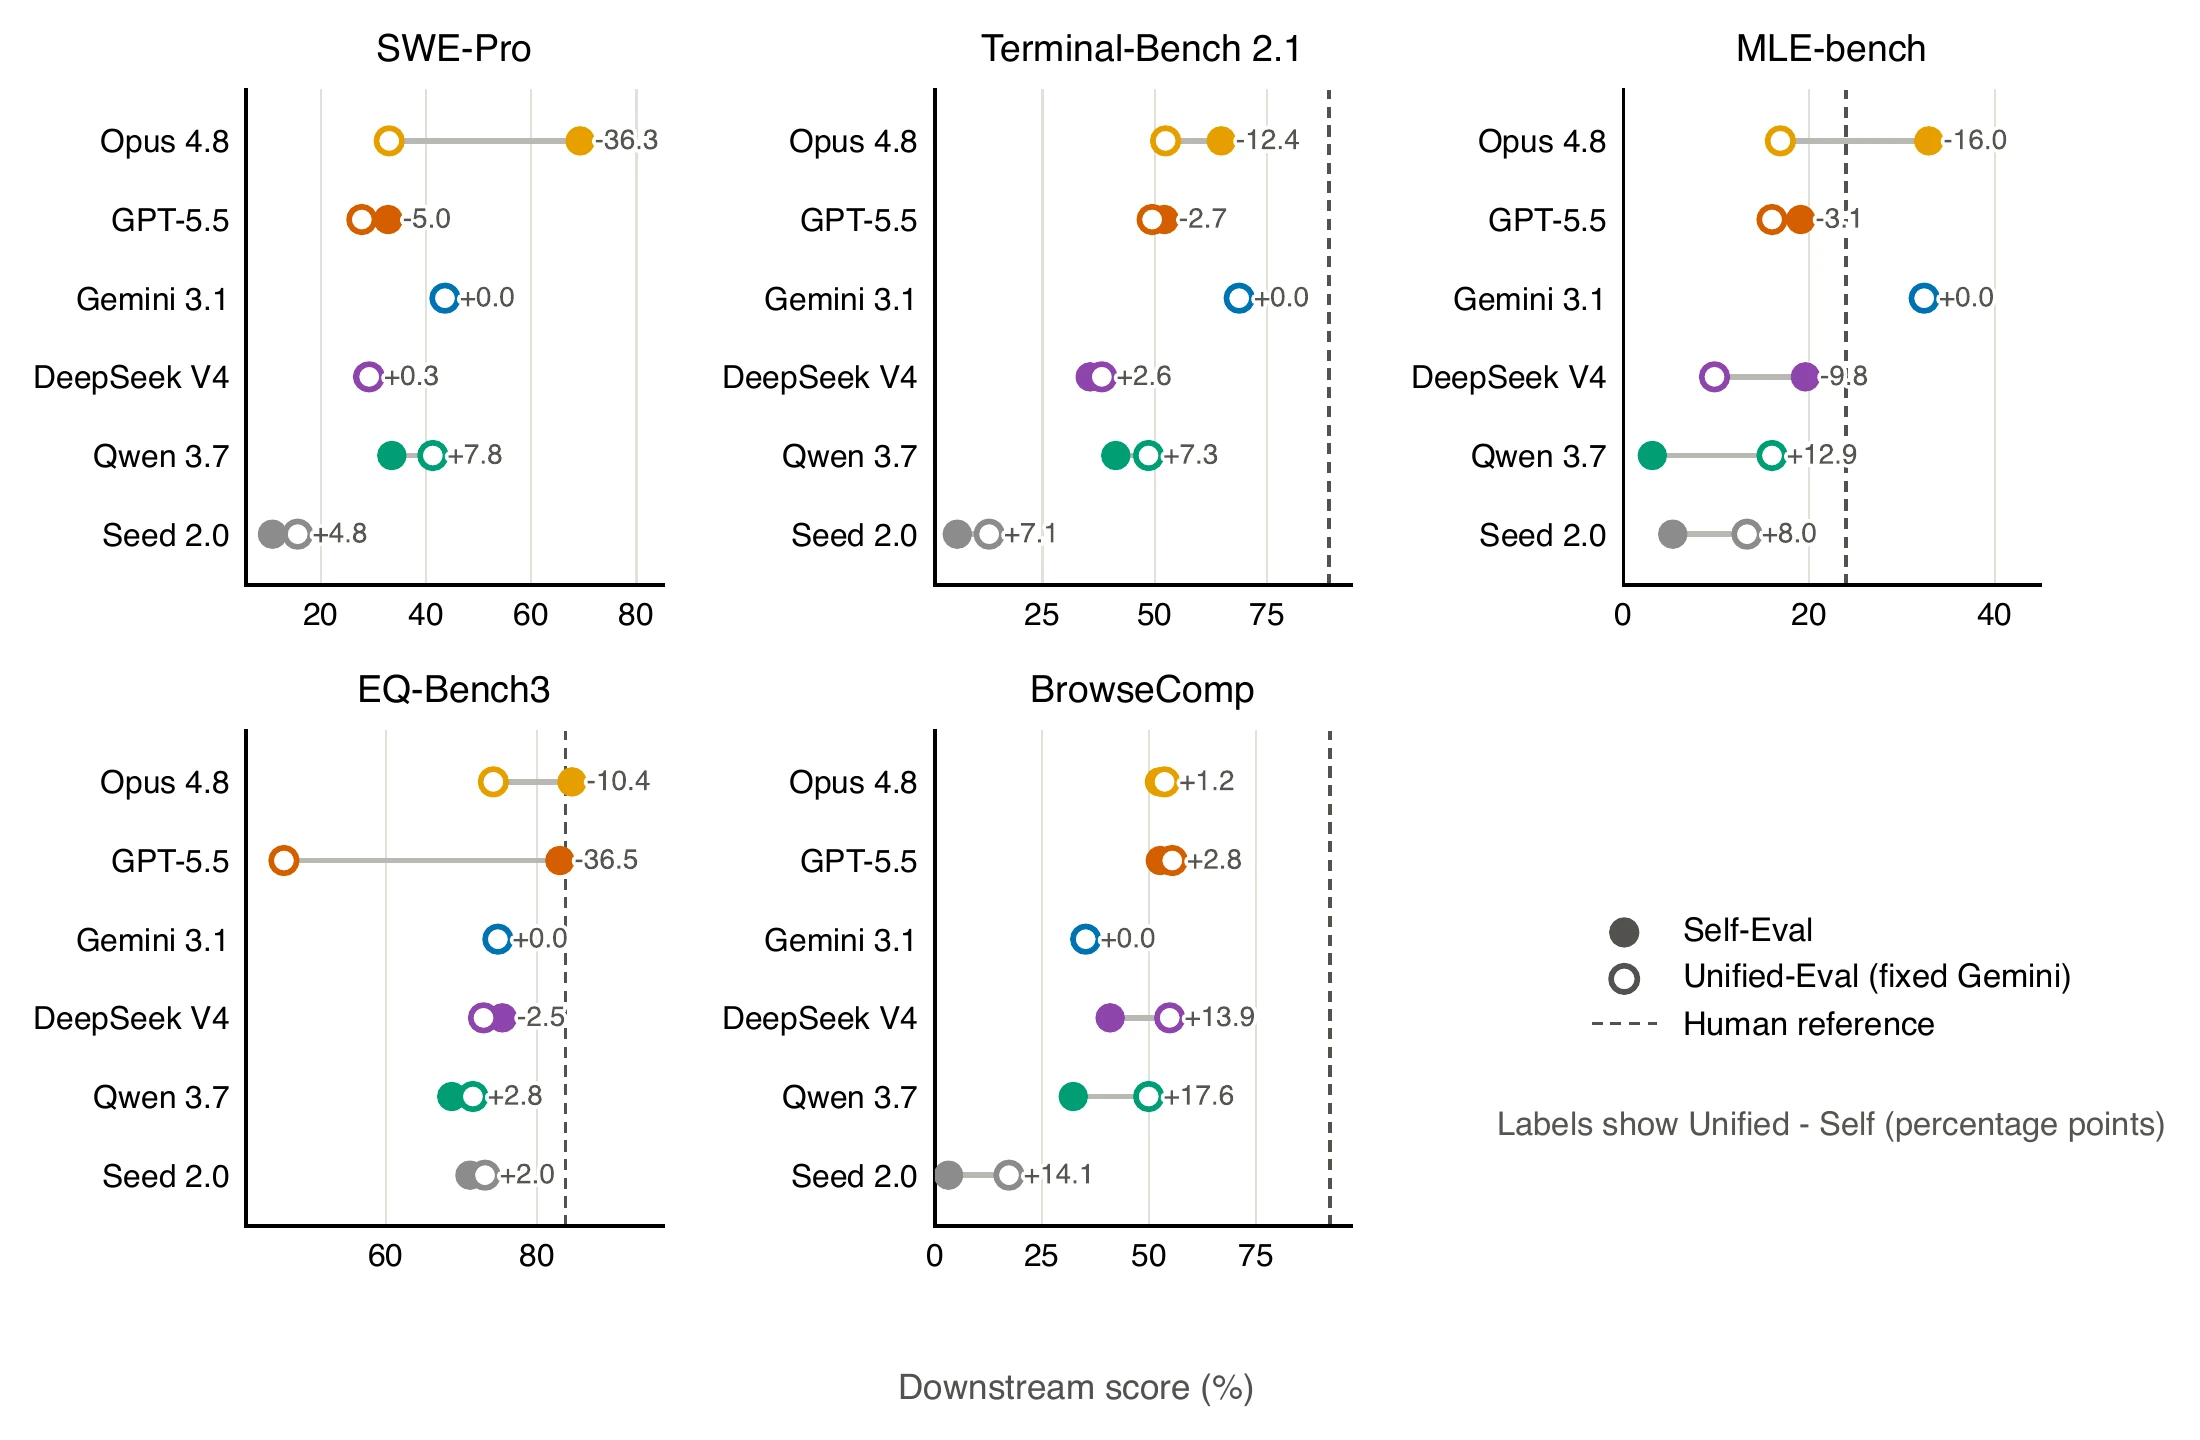
图 2. 同一框架在不同执行者下的迁移结果;实心点为 Self-Eval,空心点为固定 Gemini 执行。图源:原论文 Figure 6。
固定 Gemini 后,Opus 创建框架的 SWE-Pro 分数从 69.3 降到 33.0,而 Qwen 创建框架的 BrowseComp 从 32.3 升到 49.9。前者的平均值还包含一个明显失效的独立副本,原论文报告剔除后的敏感性均值为 49.1;不能把一次副本失效掩盖掉,也不能将原始均值下降全部解释为稳定的模型间差距。
轨迹分析给出了更具体的例子:某个 Opus 代码框架围绕原执行者硬编码了 120 步限制,换模型后接近失效;搜索框架的重复查询率则从 10.1% 升到 88.2%。提示、去重、预算与停止规则都可能适应了原模型,接口可运行并不保证行为可迁移。
4.3 反馈分数上涨,不能替代 held-out 检验
下表摘录原论文 Table 6,比较初始框架与创建者最终选定版本,变化单位均为百分点。Self 表示由创建者自己执行,Fixed Gemini 表示统一执行模型。
| 执行设置 | 创建者 | 可见反馈对分数变化 | Held-out SWE-Pro 变化 |
|---|---|---|---|
| Self | Gemini 3.1 Pro | +8.8 | +2.70 |
| Self | Opus 4.8 | +3.0 | +4.44 |
| Self | Qwen 3.7 Max | +13.9 | +1.43 |
| Self | DeepSeek V4 Pro | +13.4 | +3.17 |
| Self | GPT-5.5 | +5.9 | +3.81 |
| Fixed Gemini | Opus 4.8 | +9.7 | +2.70 |
| Fixed Gemini | Qwen 3.7 Max | +1.1 | −1.11 |
| Fixed Gemini | DeepSeek V4 Pro | +6.5 | −2.38 |
| Fixed Gemini | GPT-5.5 | +2.4 | −10.32 |
五条 Self 轨迹最终在 held-out 集上都取得正收益,但收益大小与可见反馈提升并不成比例。固定 Gemini 的四条轨迹中,只有 Opus 保留正收益,其余三条在 held-out 上退步。这说明框架搜索可以找到局部有效修改,却仍容易适应当前执行者或反馈集。
最终选中的版本也不一定是隐藏测试上最好的中间版本。固定 Gemini 的 GPT-5.5 轨迹,最终版本落后于其最佳 held-out 中间版本 16.51 个百分点。这个最佳版本由事后检查得知,不是开发时可以直接使用的选择信号;它指出的是版本选择与回退机制仍有改进空间。
4.4 运行证据揭示了“看起来完整”的框架缺在哪里
18 个代码框架中,11 个定义了状态类,但只有一个暴露状态保存接口、一个实现周期检查点;26,679 条正式任务轨迹中没有出现检查点事件。跨领域检查还发现未进入实际路径的功能,以及形式上生成了提交文件、内容却退化的机器学习实验产物。
这些观察说明,自动框架开发容易偏向容易命名和添加的模块,而缺少验证机制真正触发的证据。更有用的工程检查应围绕具体失败场景展开:上下文溢出之后能否继续,工具返回异常时能否恢复,保存的状态是否真的被读回,验证器能否发现内容错误,而不只检查文件是否存在。
5. Conclusion
HarnessDev 让执行框架成为可冻结、可检查、可迁移测试的产物。其结果表明,模型能够创建有用的 Agent 系统,也能通过执行反馈获得一定改进;但任务族、运行模型、停止规则与版本选择都会影响这些收益是否保留下来。
HarnessDev 的迁移与隐藏测试结果说明,筛选所得收益仍需在开发循环之外、不同执行者与真实执行轨迹中验证。后续可以在固定开发预算下比较不同验证集划分、行为回归检查和版本回退,检查它们是否减少无效机制与测试集退步。
论文也有明确边界:Evolution 每个创建者—执行者组合只有一条轨迹,held-out 评价只覆盖 SWE-Pro,因此不能据此估计稳定的模型总体排名或收益置信区间。开发环境本身在两阶段中保持固定,也没有把进化后的框架递归替换成下一轮的开发环境。当前证据支持的是模型外部软件机制的可学习性,持续、跨任务且跨模型的可靠自我改进仍需进一步验证。
References
- HarnessDev: Can LLMs Create and Evolve Their Own Agent Harness?, arXiv:2609.01437v1, September 1, 2026.