作者:Qize Yu、Lianrui Fan、Boyu Chen、Jiaqi Liang、Xini Ding、Yue Chen、Zetian Song、Yuran Wang、Yi Zou、Kaixuan Wang、Tianxing Chen、Wenxuan Song、Bohan Zhou、Mingleyang Li、Siqiao Huang、Yuqi Ye、Caigao Jiang、Wei Wei、Ruihai Wu、Hang Zhang、Yixiao Ge、Shuchang Zhou、Shilong Liu、Xianming Liu、Ping Luo、Shiyu Huang
单位: XPeng Inc.、Peking University、The University of Hong Kong、University of California, Berkeley、Princeton University、National University of Singapore、Tsinghua University、HKUST (GZ)
1. Motivation:动作数据还要承担多少感知学习?
机器人收到“拿起桌上的杯子”时,至少要解决两件事:确定哪个物体是杯子、杯子和可交互部位在哪里;再生成能够接近、抓取和移动它的动作。在杂乱桌面上,目标可能被遮挡,与其他物体紧贴,或只占画面很小一部分。语义上理解了指令,并不意味着定位足够精确。
视觉语言动作模型(VLA)通常继承通用视觉语言模型的表示,世界动作模型(WAM)则可能继承视频生成骨干。这些预训练提供了语义或动态先验,但其主要目标未必要求模型保留抓取、接触与避障所需的细粒度空间信息。动作微调于是同时承担“学会看”和“学会动”的任务,而机器人示范通常比图像标注更难获得。
GroundingPI 研究的是:先把语言条件下的精确定位训练成基础能力,再让动作学习使用这套表示,能否改善泛化并减少所需的机器人示范? 论文既测试 grounding 本身,也把训练后的骨干接到动作模型和驾驶轨迹预测接口,检验感知收益是否能传到下游。
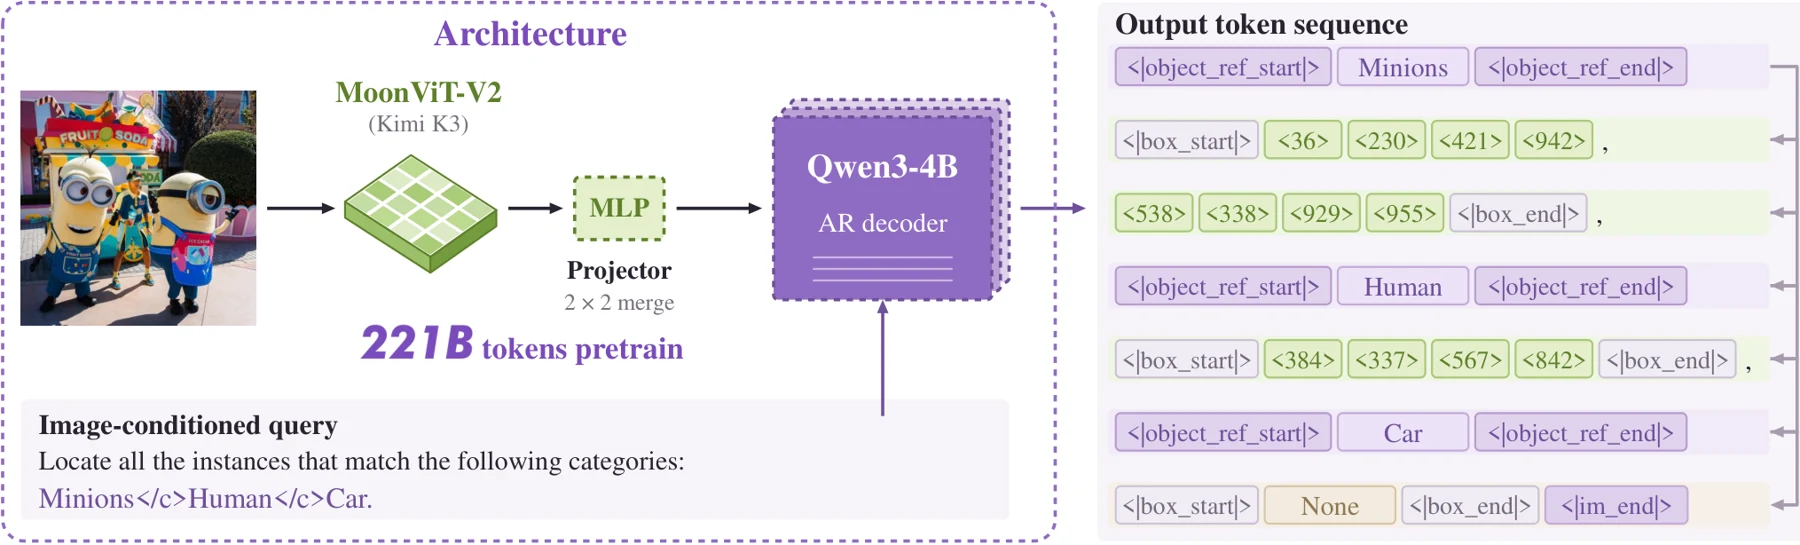
图 1. GroundingPI 的架构与结构化输出。多个同类实例共享类别标记,明确查询但不存在的类别输出 None。图源:原论文 HTML Figure 1(PDF Figure 2)。
2. Insight:定位既是输出任务,也是表示学习目标
2.1 点和框把语义绑定到可检查的位置
Grounding 指把语言中的对象或关系对应到图像位置。GroundingPI 用点和边界框作为视觉基元:类别检测输出对象的框,指代表达定位输出描述所指对象的框,pointing 输出目标内部或任务要求的位置,OCR 则把识别文本与其区域绑定。
这些任务共享一个要求:模型必须在图像中保留足够精细的证据,才能把“是什么”与“在哪里”对应起来。密集场景还要求区分相邻实例并找全目标,不能只返回最显眼的一个。
这也解释了小目标为什么难。按照论文附录中的简化推导,两个同宽同高的框只在水平方向偏移 ,且 时:
若要求 IoU 至少为 0.5,可容忍的偏移只有框宽的三分之一。目标越小,同样几个像素的误差越容易破坏定位。这是几何上的说明,并不直接等价于机器人成功率,但说明了细粒度监督的必要性。
2.2 下游可以直接读取表示,不必先生成框
GroundingPI 的机器人实验并不是“先输出目标框,再把框交给控制器”。动作模型读取骨干的多层隐藏状态,生成连续动作。点和框首先是预训练监督,它们是否改善动作学习,要通过迁移实验验证。
因此,论文最关键的比较是固定动作专家、动作数据和训练预算,只替换预训练骨干。这比比较两个完整机器人系统更接近要回答的问题,不过不同骨干仍有架构、规模和预训练数据差异,不能据此把全部收益归因于单一设计。
3. Method:统一坐标、数据验证与任务级奖励
3.1 用同一词表生成类别、文本、点和框
视觉侧使用 MoonViT-V2,投影器合并相邻 特征,再映射到 Qwen3-4B 解码器的嵌入空间。解码器的 36 层均采用全注意力。论文称其为 4B 级模型;按附录 Table 9 计入视觉编码器、投影器和不共享的输入/输出词表矩阵后,完整多模态模型约为 4.844B 参数。
输出词表加入 <0> 到 <999> 共 1,000 个原子坐标 token。框使用四个坐标,顺序为 ;点使用两个坐标。坐标按图像宽高归一化,标签、结构标记与坐标由同一个输出头预测。下面是按论文协议改写的示意,坐标仅用于说明格式:
<|object_ref_start|>cup<|object_ref_end|><|box_start|><100><200><300><450><|box_end|>
同类多实例可以共用标签,减少重复开销;明确查询但不存在的目标保留标签,几何部分写为 None。点的位置依据任务标注定义,不能把所有 pointing 都理解为框中心。用于驾驶的坐标虽然复用相同 token,却对应米制范围,与图像归一化坐标是不同约定。
3.2 训练数据:公开了任务组成,尚缺逐数据集清单
根据附录 A.4–A.6,可整理出以下训练流程。
| 阶段 | 训练数据与监督 | 训练范围与上下文 |
|---|---|---|
| Pretrain 1 / Stage 1:投影器对齐 | 图像—caption,对 assistant 描述计算交叉熵 | 仅投影器;8,192 tokens |
| Pretrain 1 / Stage 2:联合多模态预训练 | 纯文本与通用图文;文本做完整因果监督,图文监督 assistant 响应 | 全部模块;8,192 tokens |
| Pretrain 1 / Stage 3:通用视觉/视频理解 | 视觉问答、指令跟随、图像 caption 和视频;不另混入空间专门化数据或独立纯文本配额 | 全部模块;32,768 tokens |
| Pretrain 2 / Stage 4:空间感知 SFT | 以下八组空间任务,对标签、坐标与协议标记做监督 | 附录配置更新全部模块;8,192 tokens |
| RL:强化后训练 | 图像—查询及参考标注;grounding 使用覆盖/严格定位奖励,OCR 使用文字—几何奖励 | 冻结视觉编码器和投影器,只更新语言侧;每个查询采样 8 个响应 |
Stage 4 列出的八组任务具体如下。
| 空间训练任务组 | 输入与目标 | 核心监督内容 |
|---|---|---|
| Detection | 类别查询 → 目标框 | 类别与实例区域对应,多目标覆盖及目标缺失 |
| GUI grounding | 操作指令 → 界面元素位置 | 可点击位置与指令含义对应 |
| Referring-expression grounding | 指代表达 → 目标框 | 属性、关系等描述与具体实例对应 |
| Referring-expression pointing | 指代表达 → 目标点 | 通过点定位描述指向的对象或位置 |
| OCR | 图像 → 转写文本与区域 | 局部文字识别、边界及文本—区域对应 |
| Document layout | 版面类别 → 区域框 | 文档元素的类别与空间布局 |
| Dense pointing and counting | 密集目标查询 → 多个点及计数相关监督 | 相邻实例区分、目标覆盖与数量一致性 |
| Visual prompting | 示例框 → 相似对象的框 | 从视觉示例识别并定位同类实例 |
这里的八组训练任务与实验中的六组数据消融是两套分组方式。 消融把任务重新归并为基础 grounding、密集 grounding、指代定位、基础 pointing、机器人 pointing 和 OCR/版面/GUI 辅助组。
规模方面,附录报告累计训练暴露量为 500.41B + 221.17B tokens,合计约 721.58B;感知 scaling 图使用 88.4B、132.6B、176.8B、221B 四个数据量。
3.3 数据引擎检查语义、几何与覆盖率
训练结合公开数据与专用数据引擎生成的标注。引擎融合多个教师在目标定位、分割、文字识别、GUI 和文档区域上的预测,分别处理语义字段与几何字段,再做任务相关验证。
这里有两个重要约束。第一,“定位所有目标”除了单个框正确,还必须验证目标是否找全;有一个实例尚未解决,就可能阻止整条计数或全目标查询进入训练。第二,空预测不能证明目标不存在,None 也需要证据。已经确认的局部标注则可以用于不依赖完整覆盖的任务。
通过验证的标注训练统一 grounding 专家,再用于下一轮候选生成;不确定区域可以请求其他教师或局部观察。裁剪结果要映射回原图,如果判断依赖原始输入看不到的局部细节,训练样本也需要保留相应视图。多教师一致只是验证依据之一,并不保证标签正确。
3.4 从逐 token 监督到 GRPO 的输出质量奖励
空间感知 SFT 学习坐标对齐和统一输出协议:在 assistant 响应中的标签、结构标记与坐标位置计算交叉熵,不另加 IoU 回归损失。它能有效学习标准答案,但逐 token 的分类误差与完整输出的几何质量并不总是一致。例如,坐标相邻的两个 token 在分类上是不同类别,图像中却可能只相差很小距离;少量 token 出错也可能让整个框偏离目标。
强化后训练采用 GRPO,每个图像—查询采样 8 个响应。它补充了逐 token 监督不容易直接表达的目标:不仅格式要对,目标还要找全、边界要准确,文字内容也要与区域一致。
对于 grounding,集合奖励 通过带类别验证的最大 IoU 匹配衡量目标覆盖;严格奖励 综合多阈值 F1、定位、格式、数量和排序,并惩罚重复框与过大的框。两类奖励先在同一查询内分别标准化,再组合:
组合后的优势还会在响应批次上标准化。OCR 使用文字与几何共同参与的匈牙利一对一匹配,处理词级/行级参考和输出格式。GRPO 保留冻结的 SFT 参考模型,只更新语言侧参数;这里优化的是感知输出奖励,不是机器人交互回报。
3.5 机器人读取多层特征,驾驶生成未来轨迹
机器人适配从骨干按相对深度均匀取 8 层隐藏状态,经投影与重采样后,每层得到 64 个、宽度为 1024 的条件 token。它们分别注入统一 Action DiT 的 8 个交叉注意力块,与 8 个动作自注意力块交替排列。
动作专家以本体状态和感知条件为输入,通过 flow matching 学习将噪声变成连续动作段。动作 horizon 为 16,推理使用 4 步 Euler 求解;每次观察只运行一次骨干,特征在动作去噪期间缓存复用。各骨干统一训练 40,000 次更新,使用相同示范池、动作表示和优化协议。视频生成骨干也接入这一共同接口,实验比较的是它们提供的表示,而非完整原生 WAM 系统。
nuScenes 的适配路径不同:输入当前前视图和最多 3 秒的历史自车状态,由语言输出头自回归生成未来 3 秒内、间隔 0.5 秒的 6 个位置。位置是当前自车坐标系下的累计位置,前向与左向分别映射到固定米制区间,训练仍使用响应交叉熵。它没有使用机器人实验中的 Action DiT。
4. Experiments:定位、迁移与数据效率分别证明了什么?
4.1 感知平均分领先,单项能力仍有明显差距
论文与 44 个基线比较,覆盖 34 个 benchmark、11 类感知能力,报告 GroundingPI 的平均分为 73.68%,GPT-6 Astra 为 71.54%。Astra 使用 High 推理设置。下面列出三项代表性框定位任务,指标均为 F1mIoU,越高越好;对有多个版本的相关工作,选择原比较中在这三项任务上均最优的版本。
| 模型 | COCO | Dense200 密集框定位 | VisDrone 小目标框定位 |
|---|---|---|---|
| Rex-Omni | 56.28 | 53.29 | 27.19 |
| LocateAnything(Slow NTP) | 59.37 | 62.04 | 40.31 |
| GroundingPI | 62.98 | 74.53 | 40.44 |
| GroundAnything-VLM | 63.70 | 75.55 | 40.74 |
| GPT-6 Astra | 62.75 | 65.04 | 37.12 |
在这些任务上,GroundingPI 超过 Rex-Omni 与 LocateAnything,但并非全面领先:VisDrone 与 LocateAnything 的差距只有 0.13 个百分点,GroundAnything-VLM 在三项上均略高。框定位指标结合目标覆盖与边界重叠;目标指点则依据实例 mask 判断点是否正确,并用 F1 平衡漏检和误报。Dense200 指点中 GroundingPI 为 81.27,低于 Astra 的 86.57,说明“边界画准”和“选到正确实例内部”不能互相替代。
其他能力也各有强弱。GroundingPI 在 SROIE OCR 上为 72.47,高于 Astra 的 53.57;RefSpatial 平均准确率为 75.50%,低于 Astra 的 85.93%;ScreenSpot-Pro 准确率为 65.78%,低于 Astra 的 93.17%。TotalText OCR 则为 49.32,低于 Rex-Omni 的 52.35。平均分领先不代表具备更强的通用推理或 Agent 能力。
论文在评估说明中将自有模型结果报告为五个随机种子、每个种子两次运行的十次均值,主榜本地基线为三次运行均值;另有来自外部论文的结果。部分模型存在提示、解析器或输出接口兼容性问题,缺失或不支持的条目不能视为零能力。附录还明确指出 scaling 分析没有给出重复种子不确定性,因此不能把上述均值约定当作每项消融均已提供误差估计。
4.2 机器人:四项 OOD 分布在两个基准
RoboTwin 2.0 包含 50 个双臂桌面操作任务。Full 使用 Clean 与 Randomized 数据;Clean2Random 只用 Clean 示范训练,再测试包含杂物、光照、纹理、桌面高度和指令变化的 Randomized 场景。后者主要检验相同操作任务下的环境鲁棒性。
RoboCasa-GR1 使用头部相机、没有腕部相机,测试人形机器人的灵巧手操作。它包含 Full/ID,以及三种实体泛化:未见外观、未见物体类别、已见物体与容器的新组合。
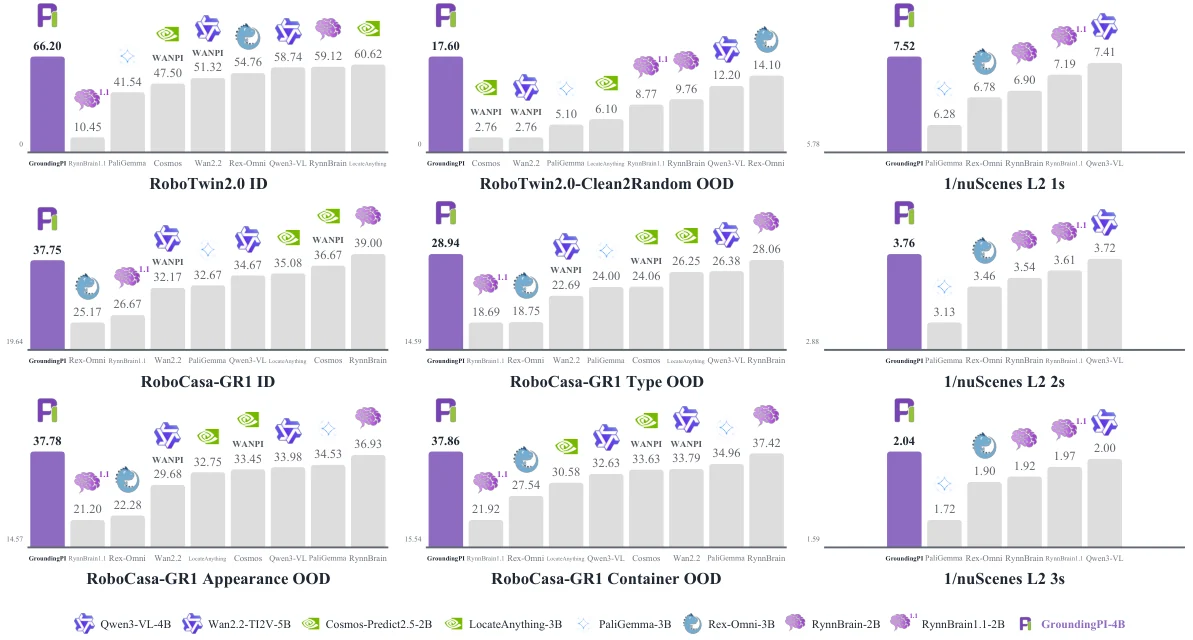
图 2. 下游迁移比较。机器人面板为成功率;驾驶面板绘制 L2 误差的倒数,数值越高越好,不能直接读作误差。部分纵轴未从零开始。图源:原论文 HTML Figure 5(PDF Figure 6)。
| 设置 | GroundingPI 成功率 | 该设置最强对照 |
|---|---|---|
| RoboTwin Full | 66.20% | LocateAnything,60.62% |
| RoboTwin Clean2Random | 17.60% | Rex-Omni,14.10% |
| RoboCasa-GR1 Full/ID | 37.75% | RynnBrain,39.00% |
| RoboCasa-GR1 未见类别 | 28.94% | RynnBrain,28.06% |
| RoboCasa-GR1 未见外观 | 37.78% | RynnBrain,36.93% |
| RoboCasa-GR1 新容器组合 | 37.86% | RynnBrain,37.42% |
GroundingPI 在六种设置中的五种领先,包含全部四项 OOD。四项 OOD 是 RoboTwin 的一项加 RoboCasa-GR1 的三项;不能把摘要中的相关表述读成 RoboTwin 单独有四项 OOD。
Clean2Random 从 14.10% 到 17.60%,增加 3.50 个百分点,相对提升约 24.8%。这个相对数值不等于增加 24.8 个百分点,17.60% 的绝对成功率也表明随机场景仍然困难。RoboCasa-GR1 的 OOD 优势更小,Full/ID 则由 RynnBrain 领先,结论应限定在所测协议与数据范围。
4.3 示范效率:半量数据超过对照的四分之三数据
在 RoboCasa-GR1 ID 中,作者分别使用 25%、50%、75% 和 100% 的示范,其余动作学习设置不变。GroundingPI 在三种减少数据的条件下均领先;使用 50% 示范时成功率为 28.75%,超过所有使用 75% 示范的对照,其中最强的 RynnBrain 为 27.75%。
这支持“感知预训练可以改善有限示范下的适配”。但满量数据时 GroundingPI 仍低于 RynnBrain,因此不能解释为任何数据规模下均最优。实验也没有分别测量感知与运动学习各自的样本复杂度,更没有证明总训练成本更低:感知预训练本身消耗了额外数据与计算。
4.4 驾驶:0.296 米是开环轨迹误差
nuScenes 上,GroundingPI 的平均开环 L2 为 0.296 m,Qwen3-VL-4B 为 0.301 m,RynnBrain 为 0.308 m。相对 Qwen3-VL-4B 的差值是 0.005 m,属于较小改善。
这里的 L2@1s、2s、3s 分别平均截至对应时长的各个未来步误差,再将三个时长指标平均得到 L2 Avg;它不是仅对 1、2、3 秒终点误差求平均。预测还以历史自车状态为条件,因此不应视为只凭单张图像完成驾驶。
开环指标测量预测轨迹与记录轨迹的一致性,没有测试闭环控制、交通参与者响应或实际部署延迟。论文提到 OCR 可能帮助读路标,但当前实验没有单独隔离路标识别的贡献。
4.5 数据配方:密集定位与辅助任务互补
数据消融将监督分成六组:基础 grounding、密集 grounding、指代定位、基础 pointing、机器人 pointing,以及含 OCR、版面与 GUI 的辅助组。以下摘录附录 Table 17,动作学习设置保持一致。
| 感知训练数据 | RoboCasa ID | RoboCasa OOD 平均 | nuScenes L2,越低越好 |
|---|---|---|---|
| 全部六组 | 37.75% | 33.38% | 0.296 m |
| 移除密集 grounding | 33.08% | 29.91% | 0.311 m |
| 移除指代定位 | 35.67% | 32.28% | 0.298 m |
| 移除机器人 pointing | 35.83% | 31.84% | 0.296 m |
| 移除 OCR/版面/GUI 组 | 32.42% | 29.75% | 0.308 m |
| 仅 OCR/版面/GUI 组 | 24.42% | 7.28% | 0.391 m |
这里 OOD 平均按容器组合、外观和类别套件的规模以 14∶18∶32 加权,并非三个分数的简单平均。移除密集定位使 ID/OOD 分别下降 4.67/3.47 个百分点,驾驶误差增加 0.015 m;其影响大于移除指代定位或机器人 pointing,说明密集空间监督在这套配方中有较强的迁移价值。
移除辅助组造成最大的机器人成功率下降,但只用辅助组又表现最弱。这支持任务组之间的互补,不能把各组消融差值当作可直接相加的独立贡献。全配方在机器人指标上最好,驾驶指标则与移除机器人 pointing 的配置在显示精度下持平。
作者进一步提出 OCR 可能充当感知学习的“催化剂”:字符边界要求局部精度,文字转写把局部视觉区域与语义绑定。早期加入 OCR 与持续 batch 混合共同使用时,机器人表现优于单独使用任一方式,但驾驶 L2 在显示精度下不变。联合组消融没有隔离 OCR 本身,更没有证明文字转写就是改善非文字定位的原因。 附录提出了保持文字条件与损失归一化不变、只移除转写损失的验证思路,机制仍待实验确认。
4.6 更大训练规模与更短输出,不能直接推成动作能力定律
grounding 训练暴露量从 88.4B 增至 221B tokens 的四个设置中,感知平均分从 61.69 升到 73.68,RoboCasa OOD 平均成功率从 26.59% 升到 33.38%。但 ID 成功率在倒数第二个设置达到 38.75%,最终回落到 37.75%。因此,结果支持感知与泛化共同改善,不支持“grounding 每提高一点,所有动作指标都单调提高”的规律。
坐标量化使感知平均分由文本坐标配置的 71.21 提高到 73.68;移除强化后训练则降到 72.86。输出统计中,GroundingPI 在 COCO 和 Dense200 上每个框平均使用 7.6 和 5.1 个 token,相比外部报告的 SEED1.5-VL 更紧凑。
这些结果分别支持坐标表示、后训练与序列压缩的价值,但 token 数减少不是端到端控制加速比。自回归模型输出更多实例时仍会增加生成耗时,而机器人动作分支读取隐藏状态,不能把框生成速度直接当作其控制频率。
5. Related Work:生成式定位、并行解码与动作迁移
把 GroundingPI 放在生成式 grounding 的发展中看,量化坐标、统一点框输出、数据引擎和 GRPO 并不是它独有的思路。Rex-Omni 已经把这些要素组合到 Qwen2.5-VL-3B 上;LocateAnything 进一步研究如何并行输出几何结构;同一团队的 GroundAnything 则探索扩散式并行生成。四项工作的主要问题不同。
| 工作 | 骨干与输出方式 | 训练重点 | 主要验证问题 |
|---|---|---|---|
| Rex-Omni | Qwen2.5-VL-3B;自回归生成 0–999 量化坐标 | 多任务 SFT + 几何感知 GRPO | 通用 MLLM 能否成为准确、少重复且覆盖充分的检测与定位模型? |
| LocateAnything | MoonViT + Qwen2.5;以固定长度几何块做 Parallel Box Decoding(PBD) | 联合 next-token prediction(NTP)与 multi-token prediction(MTP) | 能否减少串行步骤,同时保持框内几何一致性? |
| GroundingPI | MoonViT-V2 + Qwen3-4B;自回归生成点框 | 通用预训练、空间 SFT、感知 GRPO,以及数据配方分析 | 精确感知表示能否改善动作学习、OOD 泛化与示范效率? |
| GroundAnything | MoonViT-V2 + Qwen3-4B;保留 AR 分支并支持块内双向扩散解码 | AR 与 masked denoising 联合训练,再做 causal GRPO | 能否通过并行恢复与有限去噪提高 grounding 的速度—精度表现? |
Rex-Omni:GroundingPI 最直接的方法参照。 Rex-Omni 从原有词表末尾复用 1,000 个 token 表示坐标,在约 22M 训练样本上做 SFT,再从 SFT 数据中采样 66K 进行 GRPO。其 box IoU、point-in-mask 和 point-in-box 奖励直接检查几何结果,并调节漏检与重复输出。GroundingPI 延续了这一路线,换用新的视觉与语言骨干,加入通用多模态预训练与更细的感知数据、奖励设计,并把主要证据推进到动作迁移。它不是第一次证明“坐标 token + RL”可行,也不能仅凭更高分数判定某一个奖励项带来了全部收益。
LocateAnything:把一个框作为并行单元。 PBD 将输出组织为长度为 6 的块,可容纳四个坐标及两个结构标记,并定义语义块、框块、负例块和结束块。块间保持因果顺序,块内使用双向注意力;因此是框内并行、块间依次生成,不是一次生成整张图的全部目标。Fast 使用 MTP;Slow 使用逐 token NTP;Hybrid 在格式异常或空间歧义较大时回退到 NTP 重解当前块,再恢复 MTP。原论文的主训练是联合 NTP/MTP 的监督微调,将 RL 留作后续方向。
GroundAnything:并行单元不再要求与框边界对齐。 GroundAnything 的转换训练把响应分为 32-token 块,在块内掩码并联合恢复 token,块间保留已完成前缀;一个块可以包含标签、多个坐标或部分几何结构。训练同时优化 AR 和 masked denoising,各占 0.5 权重。默认熵引导解码优先提交低熵位置,已提交 token 固定;还提供扩散草稿加 AR 验证的自推测模式。它与 LocateAnything 都使用块内双向信息,但块的组织方式、监督目标和提交/纠错机制不同。
GroundAnything-VLM 是该论文单独报告的自回归模型,GroundAnything 是支持扩散的转换模型;它们不能直接与 GroundingPI 视为同一个 checkpoint 的三个推理开关。 GroundAnything 的后训练也有差别:使用 causal rollout 的精确似然做 GRPO,冻结视觉编码器,更新投影器与语言侧,不使用参考策略 KL 项,再将共享权重用于扩散推理。其 DLM–MTP 控制实验主要比较自行实现的 causal MTP,并非对 LocateAnything 的完整复现,不能将该实验解读为所有 MTP 方法都弱于扩散。
6. Conclusion
GroundingPI 展示了一条清晰的路线:在动作学习之前,通过点、框和局部文字等监督训练可迁移的感知表示。在固定动作专家与训练协议后,这套表示在两类机器人本体的所测 OOD 条件下取得优势,也改善了有限示范下的适配;nuScenes 则提供了较小的开环轨迹误差改善。
与相关工作相比,Rex-Omni 奠定了统一量化坐标与感知后训练的直接参照,LocateAnything 优化几何块的并行解码,GroundAnything 进一步研究扩散恢复与自推测加速。GroundingPI 最有辨识度的贡献是把感知训练的价值放到动作迁移与示范效率中检验。定位精度、生成速度与动作表示质量是相关但不同的目标,需要分别评估。
更有启发的证据来自数据配方。密集定位具有跨任务的边际价值,OCR、版面和 GUI 等辅助监督在与 grounding 联合时效果更好。不过,当前结果尚未隔离 OCR 的具体机制,也没有排除不同预训练骨干的架构与数据差异。微小目标的高精度边界、部分空间与 GUI 任务仍有不足。
后续值得在固定骨干、数据量和训练预算下分别改变定位密度、文字转写监督与空间表示,再测量闭环成功率、恢复能力和墙钟延迟。点与框还可以作为人或规划器提供给策略的提示,但论文尚未独立验证这种 physical prompting,也未评估与高层推理模型协作的完整双系统控制器。现有证据最直接支持的是:精确感知可以成为动作学习的有效预训练基础,其价值需要在具体动作接口、数据条件和泛化任务中衡量。
References
- Detect Anything via Next Point Prediction, arXiv:2510.12798v1, 2025-10-14.
- LocateAnything: Fast and High-Quality Vision-Language Grounding with Parallel Box Decoding, arXiv:2605.27365v2, 2026-05-27.
- GroundAnything: Reconciling Parallel Decoding with Precise Visual Grounding at Flash Speed, arXiv:2609.39600v1, 2026-09-30.
- GroundingPI: A Grounding Foundation Model towards Physical Intelligence with Visual Primitives, arXiv:2609.39601v1, 2026-09-30.