作者:Gehao Zhang、Weikai Huang、Shailesh Shailesh、Yiyan Peng、Jiafei Duan、Ranjay Krishna
单位: Northwestern University、University of Washington、National University of Singapore
1. Motivation:识别了物体,为什么仍会抓错地方?
机器人收到“把海绵放进碗里”时,需要确定海绵和碗分别在哪里、具有怎样的形状和朝向,再结合自身姿态生成动作。知道画面中有海绵,只解决了其中一部分问题。若示范总在同一桌面、同一物体布局下采集,策略还可能把背景纹理或固定抓取位置当作完成任务的线索;换一块桌布、移动目标,动作就不再可靠。
视觉语言动作模型(VLA)通常从图文预训练获得语义能力,世界动作模型(WAM)则借助视频生成预训练获得动态先验。这些能力有价值,但其预训练目标未必直接要求模型给出操作对象的精确三维位置和尺寸。有限的机器人示范因而还要承担把语义和视觉特征转换成空间动作依据的工作。
Grounded Action Model(GAM)提出:先用可提示的三维定位模型明确“操作谁、在哪里、占据多大空间”,再让机器人示范教会策略如何操作这些对象。 本文依据 arXiv v2(2026-09-25),初版发布于 2026-09-20。
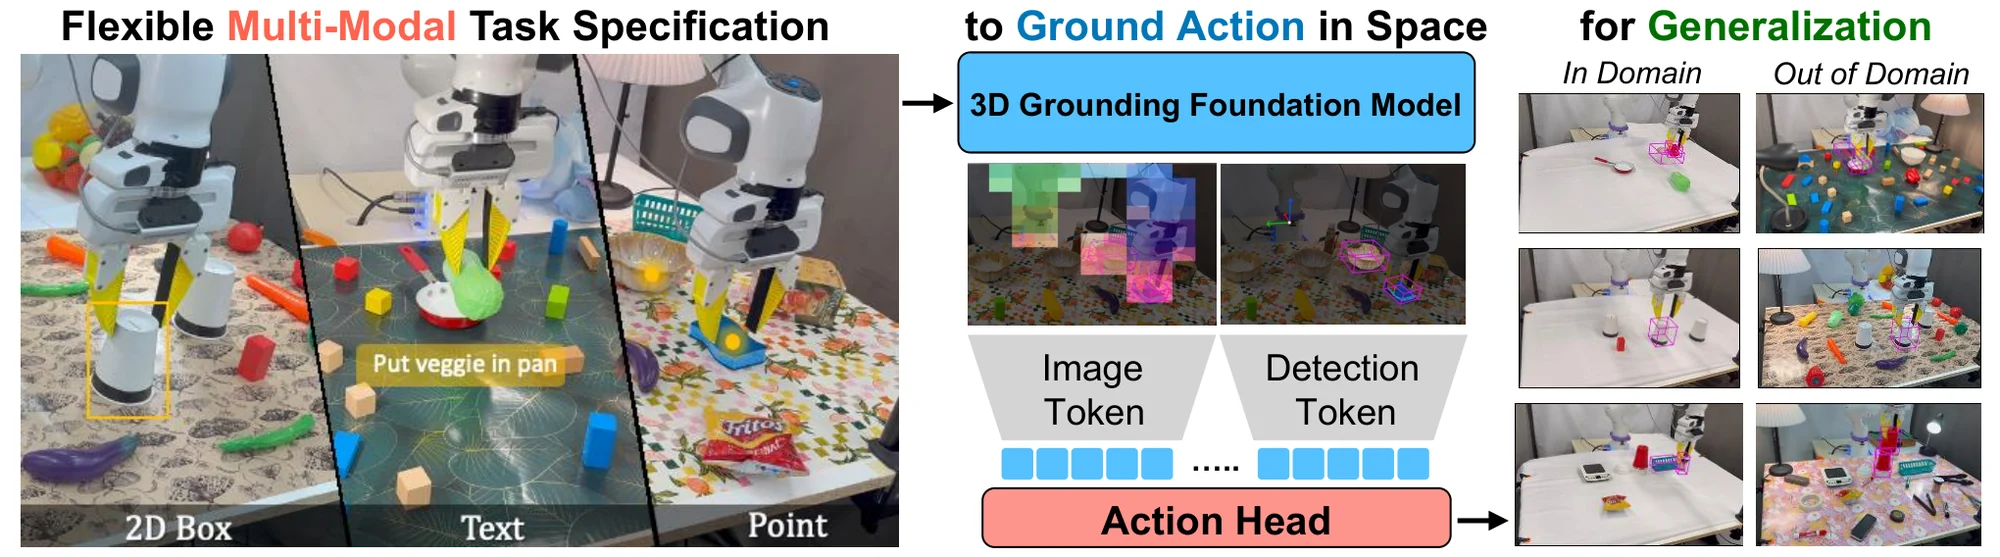
图 1. 三类任务提示通过三维 grounding 骨干进入同一动作接口。右侧展示不同场景条件下的目标定位。图源:原论文 Figure 1。
2. Insight:让策略的观察随目标选择而变化
2.1 三维表示还需要明确任务对象
Grounding 指把任务中提到或选中的对象对应到视觉空间。GAM 使用的米制三维表示进一步提供实际尺度下的位置、尺寸和朝向,并将几何转换到机器人基座坐标系。它给动作预测提供了比类别名称更直接的空间依据。
但把整幅场景换成点云,并不会自动消除无关线索。桌面、背景和干扰物仍会进入策略。GAM 的关键选择是同时限制两路输入:图像特征只保留目标物体和机械臂区域,几何特征只描述被选中物体的点云与框。这里的“目标”包括操作对象和必要的目的地,例如海绵与碗,而不只是被抓取的物体。
因此,目标移动时,输入中的几何位置随之更新;改为选择另一个物体时,进入策略的物体特征也改变。这给策略提供了跟随当前目标的依据。不过,筛选发生在骨干提取特征之后,并不能据此保证表示完全不含背景信息。
2.2 “选哪个”和“做什么”可以分别表达
语言、二维点和二维框都用于指定对象,最终得到相同形式的物体表示。与此同时,动作头仍接收语言嵌入来表达操作语义。一个点可以说明“选这个物体”,却不能单独说明要拿起、放下还是移动它。
这种接口允许人直接点击目标,也允许高层视觉语言规划器根据任务与历史选择对象,再将坐标传给底层策略。长程决策和记忆由规划器提供;GAM 负责在当前对象与操作条件下生成动作。论文中的两帧关节状态历史与规划器的 episode memory 是不同层次的信息。
3. Method:从提示到物体表示,再到动作块
3.1 冻结的 WildDet3D 负责定位与估计几何
输入为当前 RGB 图像和任务提示。语言路径先通过一个在冻结 Flan-T5 编码器之上、用合成指令模板训练的 span-tagging head 提取对象短语。例如“把海绵放进碗里”会产生 sponge 和 bowl 两个查询。点和框则直接指定对象。
查询交给 WildDet3D 后,每个对象得到二维框和带真实尺度的三维框;骨干还预测稠密深度图,并提供视觉特征。这里的深度来自 RGB 预测,不是直接把真实深度或仿真真值作为部署时的观察。点云反投影与坐标变换仍依赖相机内参及相机到机器人坐标系的标定。
论文中的“冻结”指动作学习期间不更新 grounding 骨干。RoboTwin 实验在此之前还单独进行了仿真域适配,具体训练条件在实验部分说明。
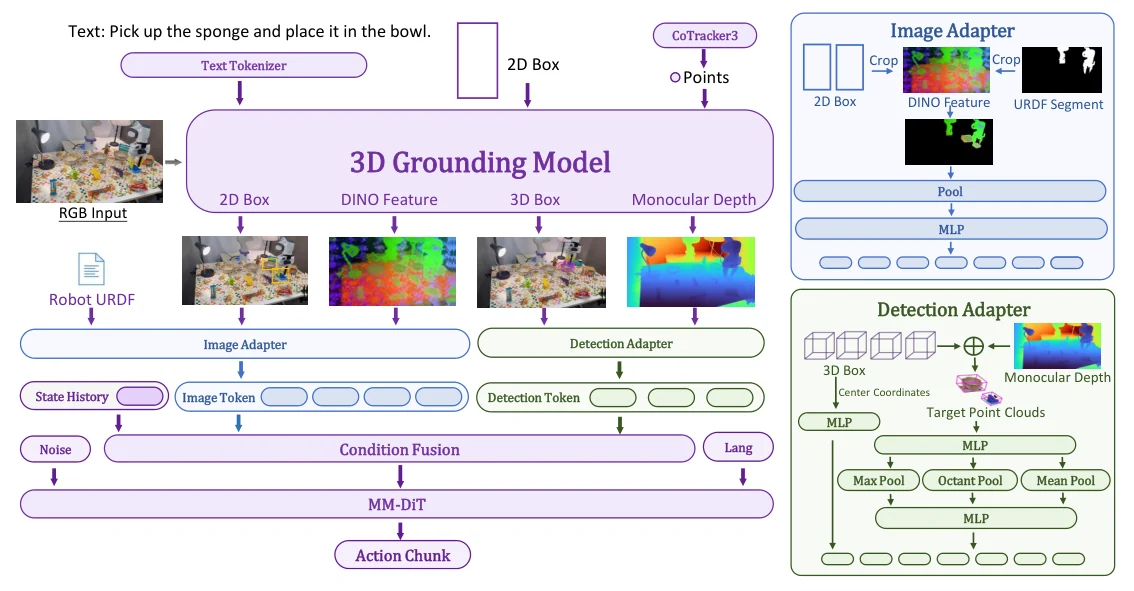
图 2. WildDet3D 提供视觉特征、框和单目深度;图像与几何两路表示和关节状态融合后,由动作头预测动作块。图源:原论文 Figure 2。
3.2 图像 token:保留对象,也保留机械臂
视觉特征被平均池化到 网格。若任务对象的二维框覆盖某个网格至少 30% 的面积,或机械臂轮廓覆盖超过 10%,则保留该网格;其余位置的特征置零。机械臂轮廓通过关节状态、正向运动学、URDF 网格与相机标定投影得到。
随后,共享线性适配器将网格映射成 256 个图像 token。保留机械臂区域有助于表达夹爪与物体的相对关系。置零不等于删除 token:这一路保持完整网格的 token 数,因此论文中的筛选主要是表示设计,不能直接换算成序列缩短或推理加速。
3.3 检测 token:把局部形状和全局位置一起交给策略
模型先将预测深度反投影成场景点云,再转换到机器人基座坐标系。对每个对象,使用略微扩张的有向三维框裁剪点云,采样 512 个点。共享逐点 MLP 提取特征,通过全局最大池化、全局平均池化,以及围绕质心的八个卦限内最大池化,得到 512 维形状表示。
对象描述符将形状和位置显式组合:
其中, 是归一化二维框, 是三维中心, 是八个频率的中心位置 Fourier 特征, 是点云形状特征, 是三维尺寸, 是框旋转的六维表示。线性适配器将每个对象映射成 8 个检测 token;检测失败的对象槽位以学习到的 null token 填充,保持 token 数。
当前帧与上一帧的关节位置拼接后投影成一个状态历史 token。三路条件加入模态嵌入,经过共享自注意力层融合。若有 个任务对象,条件序列长度为:
3.4 多流 Transformer 用 flow matching 学习动作
动作头是 12 个 block 的 MM-DiT,分别处理图像、检测、状态历史和带噪动作四路 token。各路使用独立的投影、前馈与自适应层归一化参数,通过联合注意力交换信息。语言嵌入与流时间步嵌入一起进入自适应层归一化,不增加额外的语言 token。
模型预测一段绝对关节位置目标及夹爪命令。对示范动作块 和高斯噪声 ,flow matching 构造插值:
也就是让网络学习从噪声走向示范动作的速度场。推理时从噪声出发,用 Euler 积分生成动作块;执行预定数量的动作后重新观察与预测。动作学习会更新图像适配器、检测适配器及点云编码器、条件融合层、语言投影和动作 Transformer,grounding 骨干保持冻结。
3.5 跟踪维持对象身份,规划器负责切换子目标
首次选定对象后,CoTracker3 跟踪初始二维检测框中的点,并将跟踪点持续作为 grounding 提示。每次查询策略时,骨干重新构造当前物体表示,动作头据此生成下一段动作。
对多步骤任务,Molmo2 规划器读取当前图像和 episode 历史,在子任务切换时输出新的点提示并重新初始化跟踪。底层动作策略在这些子任务之间保持不变。这展示了可组合的控制接口,但不意味着动作头本身学会了长期记忆或高层规划。
4. Experiments:泛化收益出现在哪里?
4.1 RoboTwin 2.0:优势主要来自随机化场景
RoboTwin 2.0 包含 50 个双臂操作任务,分别在干净场景 Easy 和随机化场景 Hard 下评估。GAM 每个任务训练一个策略,使用该任务的 50 条干净场景示范;每个任务在每种测试设置下评估 100 次 rollout。动作策略训练未使用随机化场景。
在训练动作头之前,作者使用模拟器导出的二维框、三维框和深度,单独微调了 grounding 骨干,使其适应渲染域,然后才冻结它。 因此,“只使用 50 条干净示范”描述的是每个动作策略的数据条件;整个系统还使用了 grounding 预训练和额外的仿真几何监督,不能当作未适配感知骨干的直接迁移。
下表摘录原论文 Table I。除作者自行训练评估的 外,基线数字来自 RoboTwin 官方榜单。
| 方法 | 动作训练方式 | Easy | Hard | 两设置平均 |
|---|---|---|---|---|
| DP3 | 每任务独立 | 55.24% | 4.96% | 30.10% |
| 每任务独立 | 64.00% | 25.90% | 44.95% | |
| Abot-M0 | 50 任务联合 | 57.40% | 30.40% | 43.90% |
| Spatial Forcing | 50 任务联合 | 77.20% | 26.70% | 52.00% |
| FastWAM | 50 任务联合 | 77.80% | 1.90% | 39.90% |
| X-WAM | 50 任务联合 | 70.00% | 25.80% | 47.90% |
| GAM | 每任务独立 | 62.96% | 47.62% | 55.29% |
GAM 的平均成功率比 Spatial Forcing 高 3.29 个百分点;Hard 比该表其他方法中的最高值 Abot-M0 高 17.22 个百分点。与同样采用单任务训练的 相比,平均高 10.34 个百分点。Easy 上则有多个方法明显优于 GAM,其优势集中于测试时的场景变化。
这张表混合了不同预训练来源、规模与单/多任务训练方式,支持所报告系统的表现比较,不能单独证明三维 grounding 骨干在相同总数据和算力下必然优于其他预训练路线。DP3 的下降也提示:仅仅使用整场景三维输入,还不足以保证鲁棒性。
4.2 LIBERO-PRO:移动目标和重新指定对象,收益最明显
LIBERO-PRO 保留 LIBERO 的训练数据,每个训练任务使用固定物体布局;测试时施加四类扰动:Obj 改变物体外观与尺寸,Pos 改变位置,Sem 改写指令措辞,Task 在原场景中更换目标对象或目标。GAM 在四个 suite 的示范上联合训练一个策略,评估全部 16 种设置。
下表摘录 Table II,数字为成功率(0–1),便于同时看到收益与退步。
| Suite | 方法 | Obj | Pos | Sem | Task |
|---|---|---|---|---|---|
| Spatial | 0.97 | 0.20 | 0.97 | 0.01 | |
| Spatial | GAM | 0.96 | 0.60 | 0.95 | 0.88 |
| Object | 0.98 | 0.17 | 0.96 | 0.01 | |
| Object | GAM | 0.88 | 0.47 | 0.99 | 0.50 |
| Goal | 0.97 | 0.38 | 0.97 | 0.00 | |
| Goal | GAM | 0.69 | 0.19 | 0.97 | 0.16 |
| LIBERO-10 | 0.92 | 0.08 | 0.93 | 0.01 | |
| LIBERO-10 | GAM | 0.50 | 0.05 | 0.89 | 0.08 |
16 个设置的平均值,原表报告 GAM 为 0.61、 为 0.53。最突出的改善是 Spatial/Object 的位置变化,以及重新指定目标:Spatial-Task 从 0.01 到 0.88,Object-Task 从 0.01 到 0.50。这与“目标改变后,策略输入中的对象及几何也改变”的设计相符。
但 GAM 在四个 suite 的 Obj 上均低于 ,Goal-Pos 和 LIBERO-10-Pos 也落后。作者将尺寸变化下的不足解释为策略难以调整训练中未见过的抓取动作;这是合理解释,当前表格没有单独隔离尺寸、定位误差和动作泛化的贡献。
Task 中新指定的对象可能原本只是该任务的背景,但相关对象和动作都在整体训练集中出现过。这里测试的是目标选择与组合泛化,不能扩大为对任意未知类别或新动作的零样本能力。位置扰动下的失败与记忆固定轨迹相容,也不足以仅凭成功率证明某个基线内部采用了哪种机制。
4.3 双臂 YAM:直接点选目标,视觉变化下保持成功
YAM 任务中,每侧有三个同色物体,两只机械臂各将指定对象放进共享容器。作者评估四种目标组合,每种采集 25 条示范,两种方法在相同数据上微调。ID(分布内)与 OOD(视觉变化)各测试 20 次,即每种组合 5 次。
| 方法与任务接口 | ID 成功次数 | OOD 成功次数 | OOD / ID 保留比例 |
|---|---|---|---|
| ,语言 | 19/20 | 4/20 | 21% |
| GAM,点击或二维框 | 19/20 | 17/20 | 89% |
两者均不使用规划器或 episode memory。GAM 在这组小规模视觉变化测试中表现更稳定,但输入接口不同:GAM 得到直接的空间指示,基线通过语言指定目标。因此结果包含感知、接口和策略的共同作用,不能把 17/20 与 4/20 的差距全部归因于动作网络本身。
4.4 Franka:规划器与动作模型组合后的步骤完成率
Franka 包含四个具有 2–4 个连续步骤的任务:把物体分类放进三个碗、清理桌面、按 R/G/B 顺序揭开方块,以及恢复原始布局。后两项需要利用历史观察。各方法都使用每任务 50 条示范微调,每任务测试 20 次 ID 与 10 次 OOD。OOD 改变背景、光照、物体实例和颜色,并加入干扰物。
| 系统 | ID 步骤完成率 | OOD 步骤完成率 | OOD / ID 保留比例 |
|---|---|---|---|
| MolmoAct2,语言接口 | 35.3% | 17.1% | 48% |
| ,语言接口 | 42.4% | 24.0% | 57% |
| GAM + Molmo2 规划器 | 64.7% | 49.8% | 77% |
这里的指标是完成步骤数占总步骤数的比例,不是完整任务成功率。GAM 的高层规划器可以读取历史并更新目标点,而两个基线使用发布的语言接口,没有外部规划器。结果说明这套组合能支持长程和记忆相关操作,但缺少给所有动作模型配备同一规划器、同一记忆的对照,无法从中分离规划器与 GAM 各自的贡献。
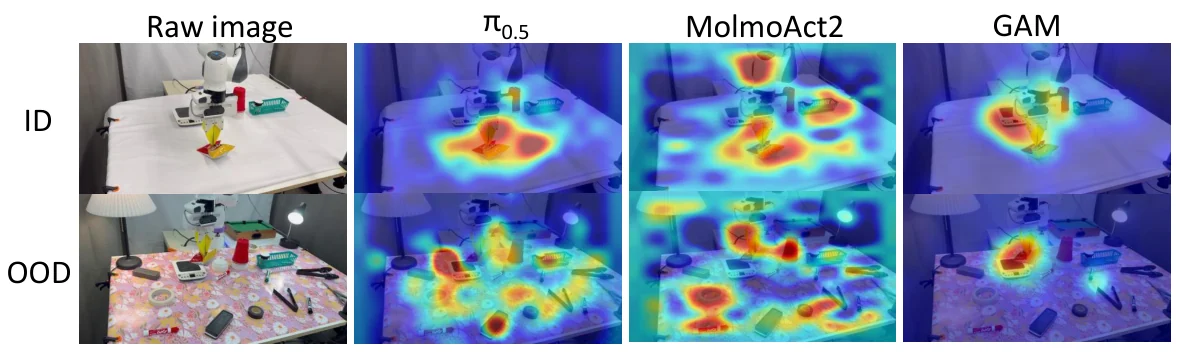
图 3. 清理桌面任务中的动作头注意力,上行为 ID,下行为 OOD。每张图分别做 min-max 归一化;它是定性示例,不能据亮度跨图比较注意力绝对大小,也不是机制的因果验证。图源:原论文 Figure 4。
4.5 消融:两路筛选和两类信息都重要
观察表示消融在 10 个 RoboTwin 任务上进行,每任务、每种设置评估 20 次 rollout,保持骨干、动作头配置、训练数据和日程固定。使用全场景点云的变体保持相同点数预算。下表来自 Table IV,不能与 50 任务主结果的平均值直接比较。
| 观察变体 | Easy | Hard | 平均 |
|---|---|---|---|
| 完整 GAM | 51.5% | 42.0% | 46.8% |
| 不做图像 masking | 30.5% | 14.0% | 22.3% |
| 不裁剪目标点云 | 18.5% | 7.0% | 12.8% |
| 两种筛选均移除 | 17.0% | 3.5% | 10.3% |
| 仅检测 token | 19.5% | 12.5% | 16.0% |
| 仅图像 token | 21.5% | 19.0% | 20.3% |
所有变体共享同一个冻结感知骨干,因而这组结果更直接地支持“如何选择和组织感知输出”对策略的重要性。保留骨干却移除对象筛选,性能仍大幅下降,说明收益并不只是换了一个更好的检测器。
只保留一路的变体仍包含状态历史 token,但都远低于完整模型,支持物体外观、机械臂视觉关系与显式几何之间的互补。相同点数预算下,整场景采样还会减少目标表面得到的采样密度,因此“不裁剪点云”的下降不能全部解释为模型被背景语义干扰。
5. Conclusion
GAM 展示了一个具体、可检查的动作学习接口:先用可提示的三维模型找到任务对象,再将对象视觉特征、米制几何和机器人状态交给动作头。它在 RoboTwin 随机化场景,以及 LIBERO-PRO 的部分位置变化和重新指定目标设置上取得明显收益。共享骨干的观察消融进一步表明,任务相关信息的筛选与组织本身具有价值。
这套设计也有明确代价。作者指出,grounding 错误会传到动作,目前缺少相应恢复机制;只保留选中对象可能漏掉未选中的障碍物。预测深度、三维框和跟踪的可靠性都会影响后续控制,null token 只能维持输入结构,并不解决漏检。尺寸变化下的结果还说明,定位到新几何并不等于已经学会适配它的动作。
真机结果验证了点击接口与规划器组合的可行性,但规模有限,且不同系统使用了不同输入接口或规划配置。当前论文也没有提供完整的感知、跟踪、规划与动作生成端到端延迟对照,不能仅凭骨干冻结或对象筛选就断言部署更快。
接下来值得验证的是:在相同规划器和记忆条件下比较不同动作模型,量化定位与深度误差对成功率的影响,并在保留目标聚焦的同时按需加入障碍物和接触区域。论文也提出用更细的三维实例分割、grounding 感知的失败恢复与自适应上下文选择改进系统。GAM 最有启发的地方,是把“任务选择如何改变策略的观察”变成了明确的架构设计和可消融的实验问题。
References
- Grounded Action Model: 3D Grounding as a Foundation for Robotics, arXiv:2609.23863v2, 2026-09-25.