作者:Bo Yin、Xiaobin Hu、Jiaqi Zhao、Shuicheng Yan
单位: National University of Singapore、Harbin Institute of Technology (Shenzhen)
1. Motivation:当前相关的历史,未必是下一段需要的历史
长视频生成既要继续运动和叙事,也要在角色、物体或场景重新出现时保留原有细节。最近几秒能维持局部连续性,较早的关键画面却可能已经离开模型的输入窗口。保存全部历史会增加计算,也会把大量重复画面带回生成器。
FrameMorrow 关注历史选择:当下一段将回到之前的房间,最近视角相似的画面不一定比早先的房间全景更有用。它根据目前已知的下一段条件,预测将需要什么信息,再选择少量明确的历史帧。
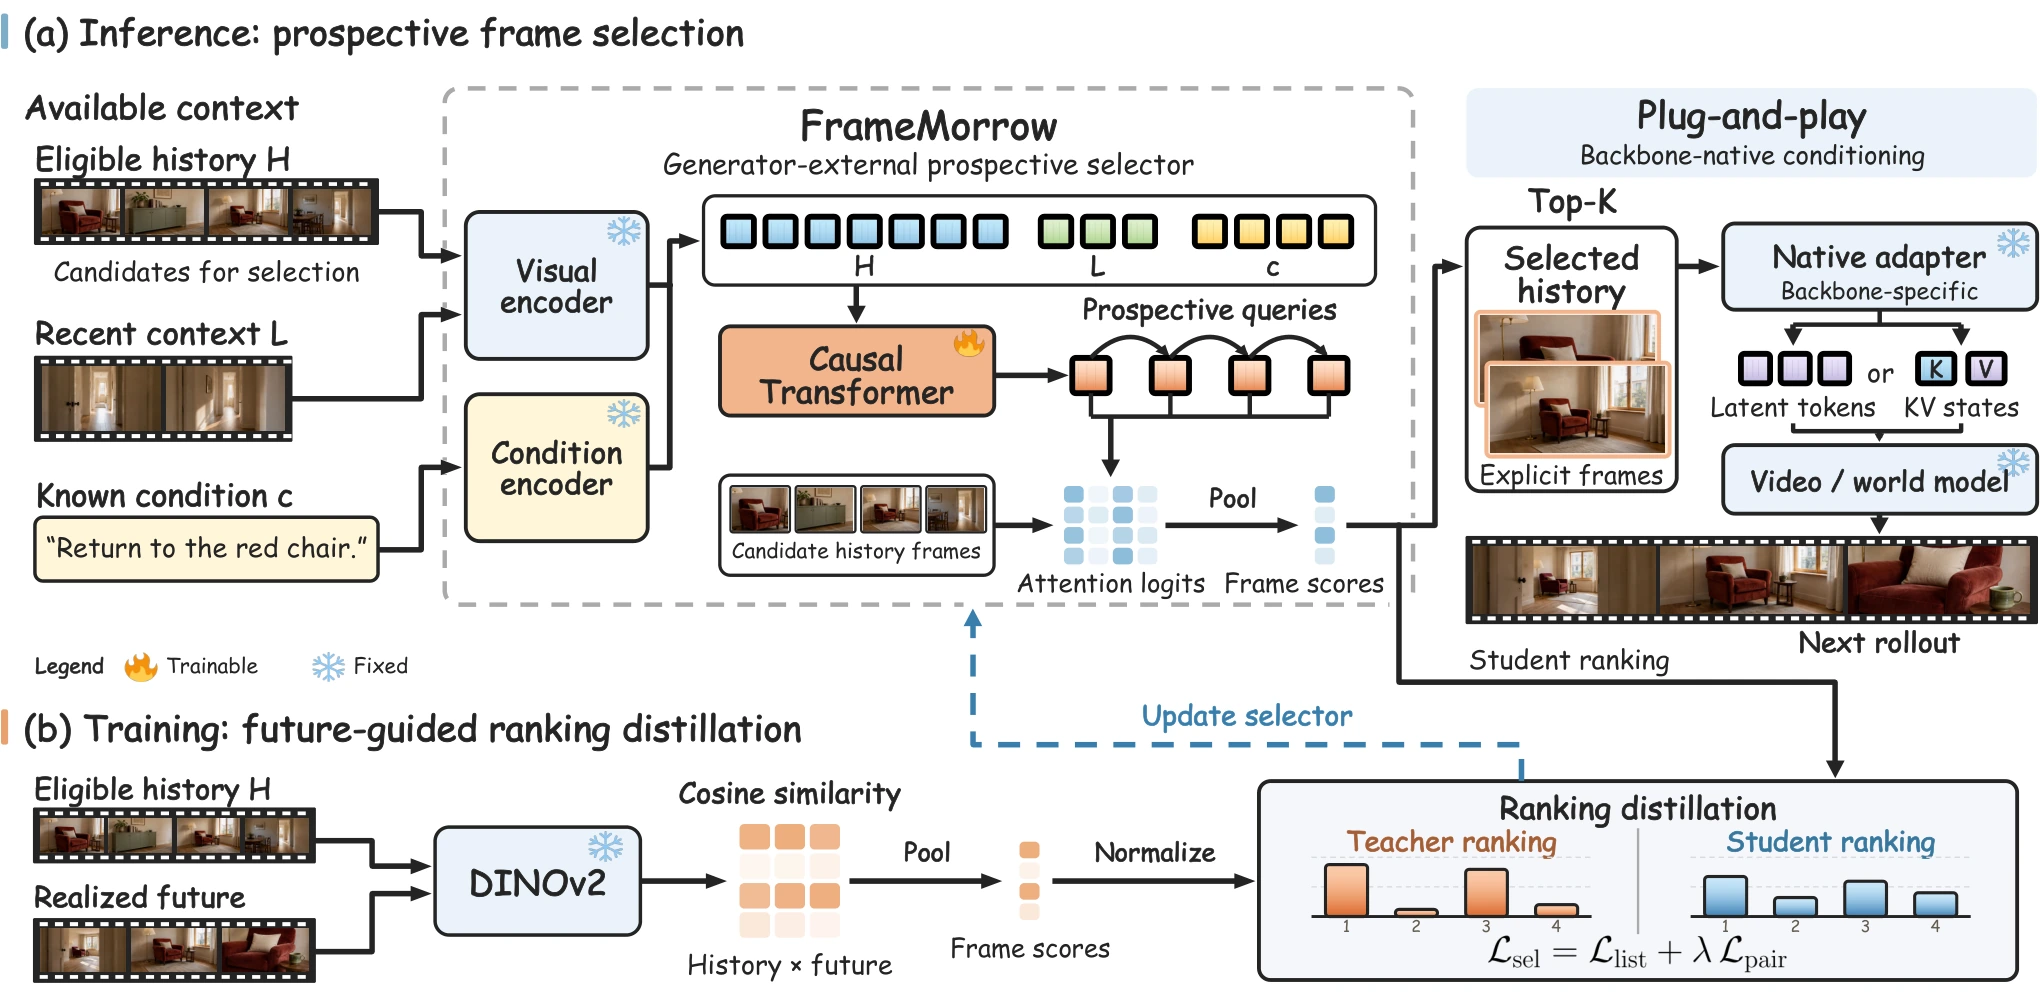
图 1. 推理时预测信息需求并选择历史,训练时用已实现的未来构造排序监督。图源:原论文 Figure 2。
2. Insight:预测信息需求,比生成一段未来更轻
2.1 用紧凑查询表示将要需要的内容
选择器不用先生成未来视频,而是产生少量 prospective tokens,作为检索历史的查询。它们没有预先指定的角色、场景或运动语义,而是在未来相关性监督下共同学习排序。
持续到来的视频应留下哪些事实,与哪些历史应成为下一段生成的条件,是不同层面的选择。FrameMorrow 聚焦后者:即使候选历史已经完整保留,调用时仍需要根据下一段条件决定哪些最有用。
2.2 训练中的未来,必须留在训练中
训练轨迹已经包含后续观察,可以用它解释哪些旧帧将再次相关。部署时只允许看到历史、最近上下文,以及决策时已经给定的下一段文本、动作序列或控制信号。后来的用户输入与环境反馈不属于可用条件。
因此,“future-guided”指训练监督和信息需求预测,而非推理时预知真实未来。未知转折仍可能让选择器漏掉有用记忆。
3. Method:把前瞻查询蒸馏为可接入的历史帧
3.1 最近上下文与长期候选分开
最近上下文用于理解当前位置,但不占长期历史的选帧预算。选择器同时观察两者,只有更早的历史帧能进入 Top-K 结果;选中后重新按时间排序,再送给生成器。
冻结视觉编码器将观察压缩为帧特征,条件编码器处理下一段提示或动作。小型因果 Transformer 自回归预测默认 4 个 prospective tokens,每个可以依赖此前预测的 token。同一条件模态内,选择器权重可跨兼容生成器使用;不同条件模态共享结构与接口,并不意味着所有模态使用同一套权重。
3.2 多个查询共同形成一个排序
每个 token 与候选帧计算注意力分数,再用 smooth maximum 聚合。一个历史帧只要与某个前瞻查询高度匹配,就可能获得较高分;默认保留 4 帧。
这种设计能表示多种信息需求,但目标没有显式约束 token 或选中帧的多样性。相近的多个旧视角仍可能一起占满预算,不能仅从“多个 token”推出覆盖完整。
3.3 未来视觉相似性提供排序监督
冻结的 DINOv2 教师比较每个候选旧帧与真实后续帧的余弦相似度,并对后续帧做平滑最大聚合。学生用 listwise 分布匹配学习整体排序,再对教师分数差超过阈值的帧对加入 pairwise 损失。
这里的监督是“未来视觉相关性”的代理:未来再次出现的角色或场景,往往能从旧帧中取得参考。但相似度没有直接测量加入该帧后生成质量增加多少,也没有扣除最近上下文已经提供的信息。它与实际生成效用的关系需要下游实验支持。
文本条件训练使用 10K 个 OpenVidHD 视频,动作条件使用另 10K 个 Sekai Game-Walking 对齐样本,其伪动作来自相机运动。真实未来只用于教师目标,学生训练输入与部署输入保持因果一致。
3.4 接入依赖生成器已有的参考接口
生成器保持冻结,以现有参考图像或记忆条件接口处理选中帧,不训练新的条件模块。输出明确图像而非某个模型独有的缓存状态,使闭源接口也有机会使用这套选择器。
兼容性仍有条件:生成器需要能够接收历史参考,并正确使用它们。固定选帧数约束了额外输入预算,选择器自身的开销仍随候选数、近期上下文和条件长度变化。
4. Experiments:长期收益、参考预算与计算代价
4.1 后半段的收益更明显,但单项指标有取舍
论文在五类评测设置、11 个生成器上测试。60 秒长视频实验使用 128 个 MovieGenBench 提示;VBench-Long 六个维度的平均排名在三个长视频主干上均改善,单项指标却不总是最好。
交互长视频的原论文 Table 2 摘录如下,分数为各自评测量表:
| 生成器 | 一致性:原模型 → 加入 FrameMorrow | 美学:原模型 → 加入 FrameMorrow |
|---|---|---|
| Self-Forcing | 84.95 → 89.30 | 58.16 → 60.62 |
| LongLive 1.0 | 92.62 → 93.21 | 64.21 → 64.56 |
| ShotStream | 92.75 → 96.76 | 62.30 → 61.74 |
Self-Forcing 的分段 CLIP 提示对齐增益从前 10 秒的 0.16 增至最后 10 秒的 2.99,符合历史遗忘在后段更严重的现象。ShotStream 的一致性提高 4.01 分,美学却下降 0.56 分,说明历史约束与画面质量仍有权衡。
4.2 匹配预算能区分选得好与给得多
闭源实验包含 30 个、每个 30 秒的多轮案例。各路线都提供最近生成片段,Uniform 与 FrameMorrow 再通过图像参考接口提供等量旧帧:
| 模型 | 原模型一致性 | Uniform | FrameMorrow |
|---|---|---|---|
| Seedance 2.0 | 94.02 | 93.54 | 95.31 |
| Kling O3 | 91.28 | 90.84 | 92.61 |
随机覆盖式增加参考并不自动有效;在等量附加帧条件下,前瞻选择更好地利用了接口。这个小规模结果支持跨模型适用性,尚不足以证明对任意闭源生成器都有效。
4.3 消融支持前瞻目标的价值
Self-Forcing 的一致性比较为:最近帧 85.70、均匀采样 86.60、当前上下文匹配 87.85、提示匹配 88.35、直接打分 88.22、FrameMorrow 89.30。选择 2 帧得到 88.00,也超过均匀选择 16 帧的 87.10。
相对 84.95 的原模型,不用未来监督的训练增益为 1.25 分,未来排序蒸馏为 4.35 分,直接访问真实未来的 oracle 为 5.65 分。oracle 只是不可部署的参照上限;学生收益表明它学到了有用预测,同时还没有完全恢复教师的信息优势。
4.4 动作对齐与实时性需要分别评价
Matrix-Game 3.0、WorldMem、YuMe 1.5 的动作对齐分别从 0.842/0.866/0.883 提升到 0.861/0.889/0.912。指标由 Qwen3-VL-8B-Instruct 判断生成视频是否遵循动作,反映视觉上的控制对齐,不能等同于物理动力学正确。
一次历史刷新选择约需 109–115 ms,实验每 5 秒刷新。LongLive 1.0 生成 60 秒视频的总耗时从 67.8 秒变为 69.2 秒,增加约 2.1%;Self-Forcing 从 82.6 秒变为 84.0 秒,增加约 1.7%。额外开销较小,但这些配置本身仍慢于播放时长,不能把它写成所有主干都实现实时生成。
5. Conclusion
FrameMorrow 将历史调用从当前相似度扩展到预计将要需要的证据,并以明确参考帧接入冻结生成器。等量参考预算和不同选择策略的消融,比单纯增加历史输入更能说明选择器的作用。
它的局限集中在信息需求预测、视觉相似度监督和记忆覆盖:意外转折可能需要此前低分的帧,重复查询也可能浪费预算。继续结合多样性、条件不确定性和实际生成增益学习排序,会比只追求更高历史相似度更接近长期记忆的目标。
References
- FrameMorrow: Future-guided Frame Selection with Prospective Tokens for Long-Horizon Video Generation, arXiv:2609.38839v1, 2026-09-30.