作者:Meijia Chen、Hao Li、Zheng Lu、Hongshan Lin、Junbai Tian、Yichen Liu、Zijun Tian、Yufan Zou、Shuhan Sun、Hanxin Chen、Zeyu Zhang、Weizhi Du、Yueting Li、Tianyu Shi、Alaa Khamis
单位: Rutgers University、Independent Researchers、UC San Diego、University of Michigan、McGill University、King Fahd University of Petroleum and Minerals
1. Motivation:内部奖励升高,外部答案却没有更正确
自进化搜索系统可以让一个模型提出问题与伪标签,再让另一个模型解答,以解题难度选择下一批训练材料。随着双方更新,内部一致率变高很容易被当成进步。
False Frontiers 检查另一种可能:两个角色逐渐接受相同的错误。错误标签进入解题者训练,又在后续同来源问题中被它复现,最后回到出题者成为奖励。论文称此为 co-cheating,描述优化中的共享错误,不意味着模型有意串通。
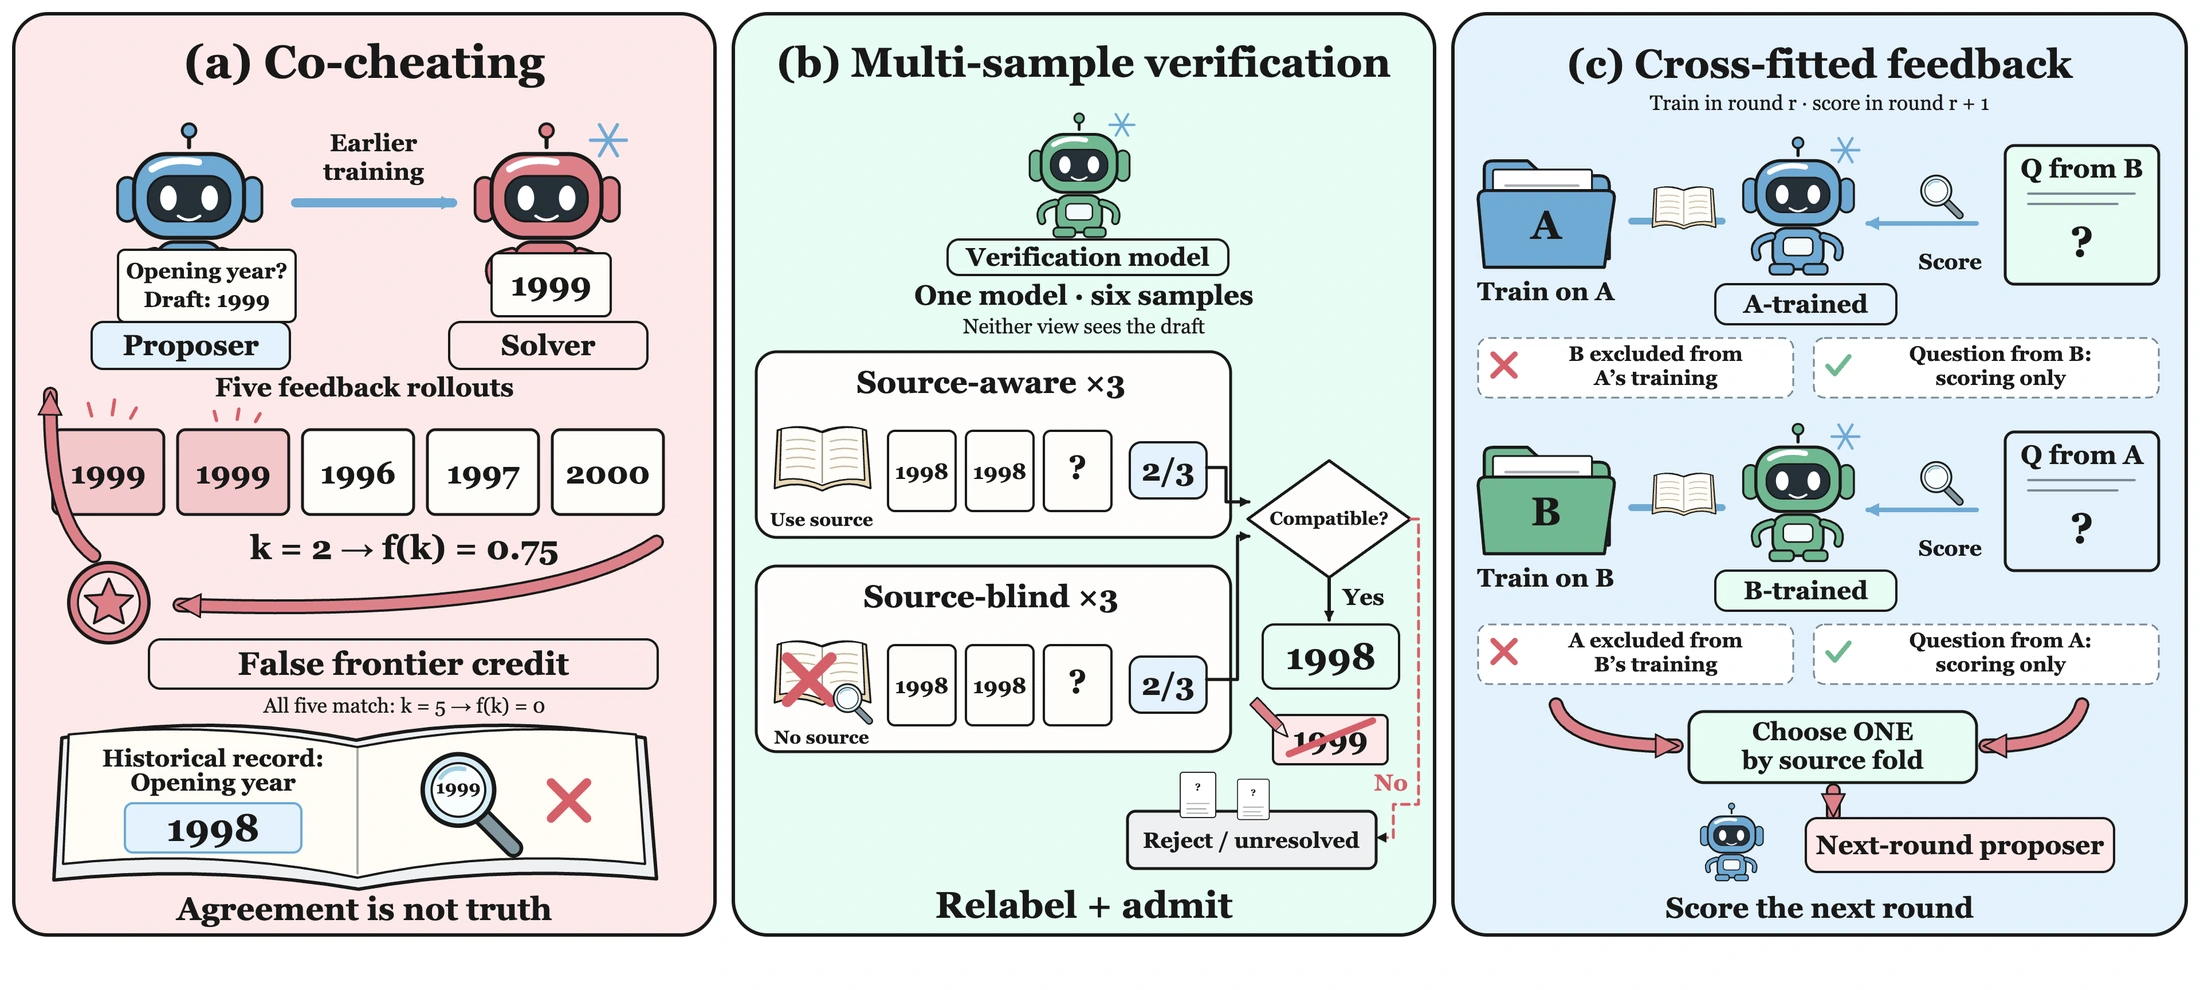
图 1. Co-cheating、MSV 与 CrossFit 的不同干预位置。图源:原论文 Figure 2。
2. Insight:验证样本与验证反馈来源是两种工作
2.1 同意伪标签并不等于答对
论文保存每步的来源文档、采用的伪标签和五次解题者响应,再由未参与训练回路的审计模型依据来源构造参考答案。缺乏证据的情况保持 unresolved,而不是强制给出正确标签。
审计区分标签正确率、解题者正确率、内部匹配率、同错一致质量和正确答案被错误标签拒绝的质量。最后两项揭示标签噪声如何影响反馈:同一个错误被认可,会增加表面一致;真实正确答案与错误标签不符,反而失去信用。
2.2 单独换一个裁判还不够
如果另一个裁判也训练过来自同一文档的伪标签,它仍可能复现相同错误。CrossFit 的关键不是角色数量,而是评估该问题的反馈解题者没有学过其来源文档产生的训练样本。
3. Method:从入库验证到交叉来源反馈
3.1 MSV 在训练前检查答案稳定性
Multi-sample verification(MSV)对每个候选问题生成三次带来源回答、三次不带来源回答,均不显示出题者的初稿。每组至少两次一致,而且两组多数答案相容,才接受样本并用多数答案替换原标签。
这同时检查来源支持和无来源稳定性,但六次回答仍来自同一个模型,可能共享错误。带来源和不带来源的一致要求,也可能筛掉真正需要来源才能回答的问题,进而改变课程分布。
3.2 CrossFit 按文档来源划分
每篇来源文档永久分到 A 或 B,该文档衍生的全部问题继承同一划分。两个辅助解题者分别只学习一个来源组;来自 A 的问题由学习 B 的辅助模型提供出题者反馈,反之亦然。
出题者奖励仍使用原 Dr. Zero 的难度规则。若五次解题中有 次匹配伪标签:
改动的是谁提供这五次反馈,而非主解题者的更新目标。主解题者仍学习两个组的全部入库样本;辅助模型只决定出题者下一轮怎样选题。
3.3 来源排除不等于真值保证
两组仍可能有共同预训练错误、内容重叠或错配的来源标识。CrossFit 切断的是同来源伪标签直接回流的路径,不会让辅助模型成为准确的真值裁判。
系统不断改进时,评价依据是否也在吸收它自己的错误,是必须单独检查的变量。
4. Experiments:自适应训练与固定题库重放
4.1 三轮后的下游搜索结果
实验使用 Qwen3.5-4B 和 9B,评价七个搜索问答基准,共 1,325 道固定题。每个基准等权计算 Cover-EM 平均,全部方法使用相同评价工具预算与提取规则。
| 方法 | 4B 平均 | 9B 平均 |
|---|---|---|
| 初始模型 | 38.4% | 40.9% |
| Search-R1 | 40.1% | 43.4% |
| Dr. Zero | 40.0% | 42.8% |
| MSV | 40.7% | 43.6% |
| CrossFit | 48.8% | 51.2% |
| MSV + CrossFit | 49.1% | 51.5% |
这是原论文 Table 1。CrossFit 比耦合自进化高 8.8、8.4 个百分点;再加 MSV 仅增加 0.3 点。数字支持反馈来源比仅做样本多数验证更重要,尚不能代表任意任务或模型的收益。
4.2 同错一致质量显著下降
最终轮次的同错一致质量,在 4B/9B 的耦合训练中为 6.1%/8.8%;MSV 为 5.7%/7.2%;CrossFit 为 3.0%/3.7%;两者组合为 2.0%/1.7%。这些是审计配对中的质量,不能直接称为“全部一致答案里错误占比”,后者需要另一个条件化分母。
CrossFit 还提升采用标签的外部正确率,从 74.7%/73.7% 到 81.9%/85.1%。内部一致与外部正确的差距,才是比单一训练 reward 更有价值的诊断。
4.3 固定 3,000 道题排除课程变化
自适应重新训练同时改变裁判和后续问题。论文因此保存同一批 3,000 个问题与标签,固定答案匹配器,只改变反馈模型见过的来源。
同来源辅助模型和全数据辅助模型都不能复现完整收益;随机按问题划分也较弱。真正按来源 ID 排除后,同错一致质量降至 0.4%/0.1%。这个数字属于固定题库重放,不能与上一节 3.0%/3.7% 混成同一实验的前后曲线。
4.4 额外训练仍有成本
CrossFit 的主实验额外训练两个辅助模型,预留 H200-hours 比 Dr. Zero 高约 72%/79%;MSV 约高 90%;组合约为 2.6/2.7 倍。预留时间包含等待,并非实际 GPU 利用率。
半预算辅助训练在固定题库重放中保持相近同错一致质量,提示部分额外优化不是主因;这不等于已经在所有下游自适应训练里证实同等收益与更低成本。
5. Conclusion
False Frontiers 将“自进化是不是在进步”变成可审计的问题:记录训练反馈的来源,区分同意、正确和共享错误,再切断同来源监督回流到奖励的路径。
后续可以对来源重复、近义改写和跨文档内容重叠进行更严格分组,并用人工抽查校准外部审计器。同时保留未知判定、分母和全部预算,才能知道减少的是共同错误,还是仅把难题从课程里过滤掉。
References
- False Frontiers: Diagnosing and Mitigating Co-Cheating in Self-Evolving Search Agents, arXiv:2609.39102v2, 2026-10-03.