作者:Python Song、Zhixuan Liang、Kelsey Fu、Mengdi Wang、Junfeng Yang、Shilong Liu
单位: Columbia University、Princeton University
1. Motivation:机器人下一次尝试,应该回答什么问题?
机器人基础模型已经具备可迁移的视觉运动能力,但物体位置、任务指令或技能组合一变,原本有效的行为仍可能失效。继续训练底层模型通常需要额外采集机器人数据;另一条路线是在模型外部调整执行代码、技能组织和反馈流程,让已有控制能力在新的条件下发挥作用。这套围绕模型组织执行的软件,就是 embodied agent harness。
问题在于,修改执行框架也需要试验。一次失败之后,系统可以改规划、调整工具调用,或者换一种技能组合。如果只是不断提出补丁并重试,很容易把有限交互花在相似方向上,却始终分不清真正的失败原因。真机试验还涉及执行时间、场景复位和硬件占用,不能把尝试次数当成没有成本的资源。
EmbodiedRSI 将“接下来试什么”本身作为需要优化的决策。系统维护可被实验支持或反驳的代码与技能假设,选择最能消除当前疑问、且成本较低的实验;执行结果再改变假设、程序和记忆,使下一轮改进有据可依。
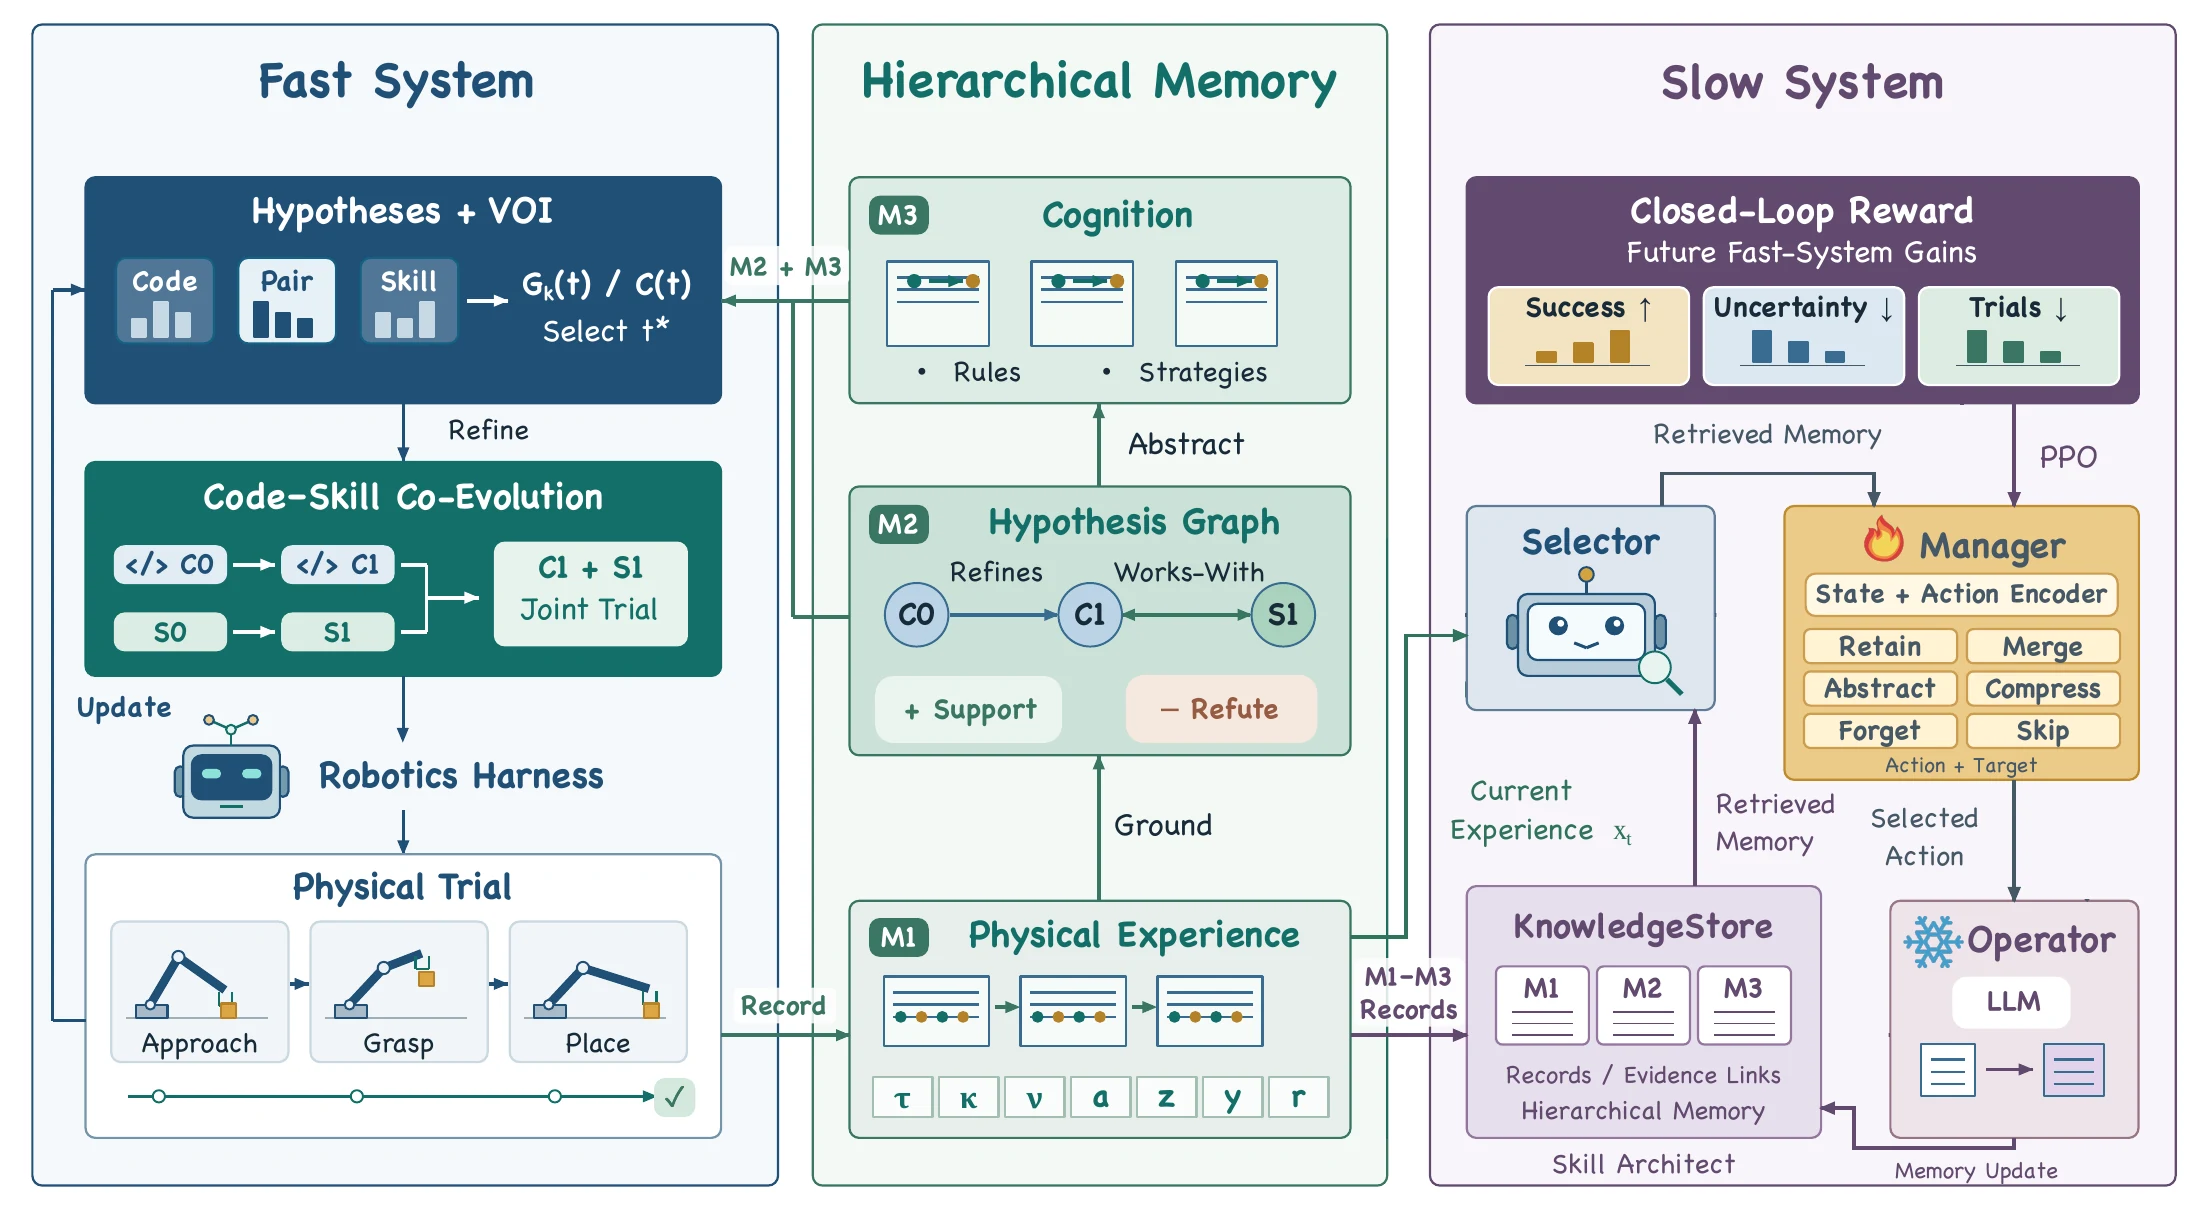
图 1. EmbodiedRSI 的快慢系统、假设图与分层记忆。图源:原论文 Figure 2。
2. Insight:交互的价值,在于它能改变后续决策
2.1 实验既要执行任务,也要区分改进方向
任务成功与获得有效证据并不完全相同。例如,一次抓取失败可能来自接近顺序,也可能来自技能使用的前提不成立。如果同时改动很多因素,下一次成功仍很难说明哪一项修改有效。更有价值的实验会明确自己检验哪些假设,并尽量控制其余条件。
因此,EmbodiedRSI 不仅保留成功或失败,还把结果关联到具体假设及其修订历史。系统选择实验时考虑预期能够减少多少不确定性,而不是只重复当前看起来最容易成功的动作。
2.2 代码与技能的价值可能依赖彼此
代码组织执行流程,技能承载可以复用的行为。单独修改代码时,一项新技能可能无法得到正确调用;单独修改技能时,旧流程也可能没有满足它的执行条件。论文将两者共同更新,并把联合版本与单独修改的版本放在相同初始状态下比较。
这里改进的是模型外部的可执行行为与组织方式。机器人基础模型在演化过程中保持冻结,但整个系统并非完全没有可训练参数:慢系统还会通过 PPO 学习记忆管理策略。
2.3 记忆应按后续用途筛选
一条经验被记录下来,不代表它会帮助未来任务。大量重复描述可能增加检索负担;某个偶然成功的细节,也可能被错误概括成通用规则。EmbodiedRSI 用后续任务改进、不确定性下降和实验成本评价记忆操作,使“保留什么、合并什么、抽象什么”成为可以学习的选择。
这把即时执行和长期复用连接起来:快系统负责实验与代码技能更新,慢系统负责从经验中形成有用的记忆。这里的“快慢”主要描述职责和更新层次,不能直接理解成已经测得的实时控制频率。
3. Method:从假设、实验到可复用的改进
3.1 用假设图保存修改方向与支持证据
Hypothesis Graph 的节点分别表示代码假设和技能假设。有向的 refines 边连接旧假设与修订版本,使系统保留“为什么产生这次修改”的历史。
每个假设的支持率采用相同的 Beta 先验。记支持与反驳该假设的实验计数为 和 ,后验均值为:
支持证据来自匹配试验的成功率差异:初始状态相同,其余调用及顺序保持一致。新假设先获得一次匹配试验的初步证据,后续再自适应分配实验。 表示该假设获得支持的程度,不能直接当成机器人执行任务的成功概率。
选择下一次实验还需要衡量证据是否充分。论文令 ,表示在已有证据 下,假设支持率超过一半的后验概率,并将各假设的二元熵相加,得到探索不确定性 。多个假设可以同时有效,它们不是一组必须选出唯一答案的互斥类别。
3.2 按单位成本的信息增益选择实验
每个候选实验 都声明自己能够更新的假设子集。它的预期信息增益,是当前不确定性减去观察结果之后的预期不确定性:
成本 则组合执行时间、仿真步数、GPU 开销与复位成本。系统选择信息增益与成本之比最大的候选:
执行后,实际结果更新被检验假设的后验,进而改变下一轮实验排序。当总体不确定性足够低、最大信息价值低于阈值、交互预算耗尽,或所有假设都达到评价次数上限时,广泛探索结束。
这一规则的价值在于让昂贵试验有明确目的,但预期信息增益仍依赖假设集合和结果概率模型。如果关键失败原因没有进入候选假设,系统即使对现有假设很有信心,也可能继续遗漏真正的问题。
3.3 通过匹配试验检验代码与技能的联合收益
对代码候选 和技能候选 ,系统分别运行代码单独更新、技能单独更新和联合更新,并计算:
是匹配试验中的任务成功率。若 ,说明联合版本在这些试验中优于两个单项版本,慢系统就将这组关系记录为双向 works-with 边,并优先保留更强的关系。
这个指标比较的是联合版本与最佳单项版本,不能进一步解释为联合收益超过两个单项收益之和,也不能仅凭一次正差值判断组合已稳定泛化。它提供的是一条可追溯的实验证据,后续仍需在新条件下验证。
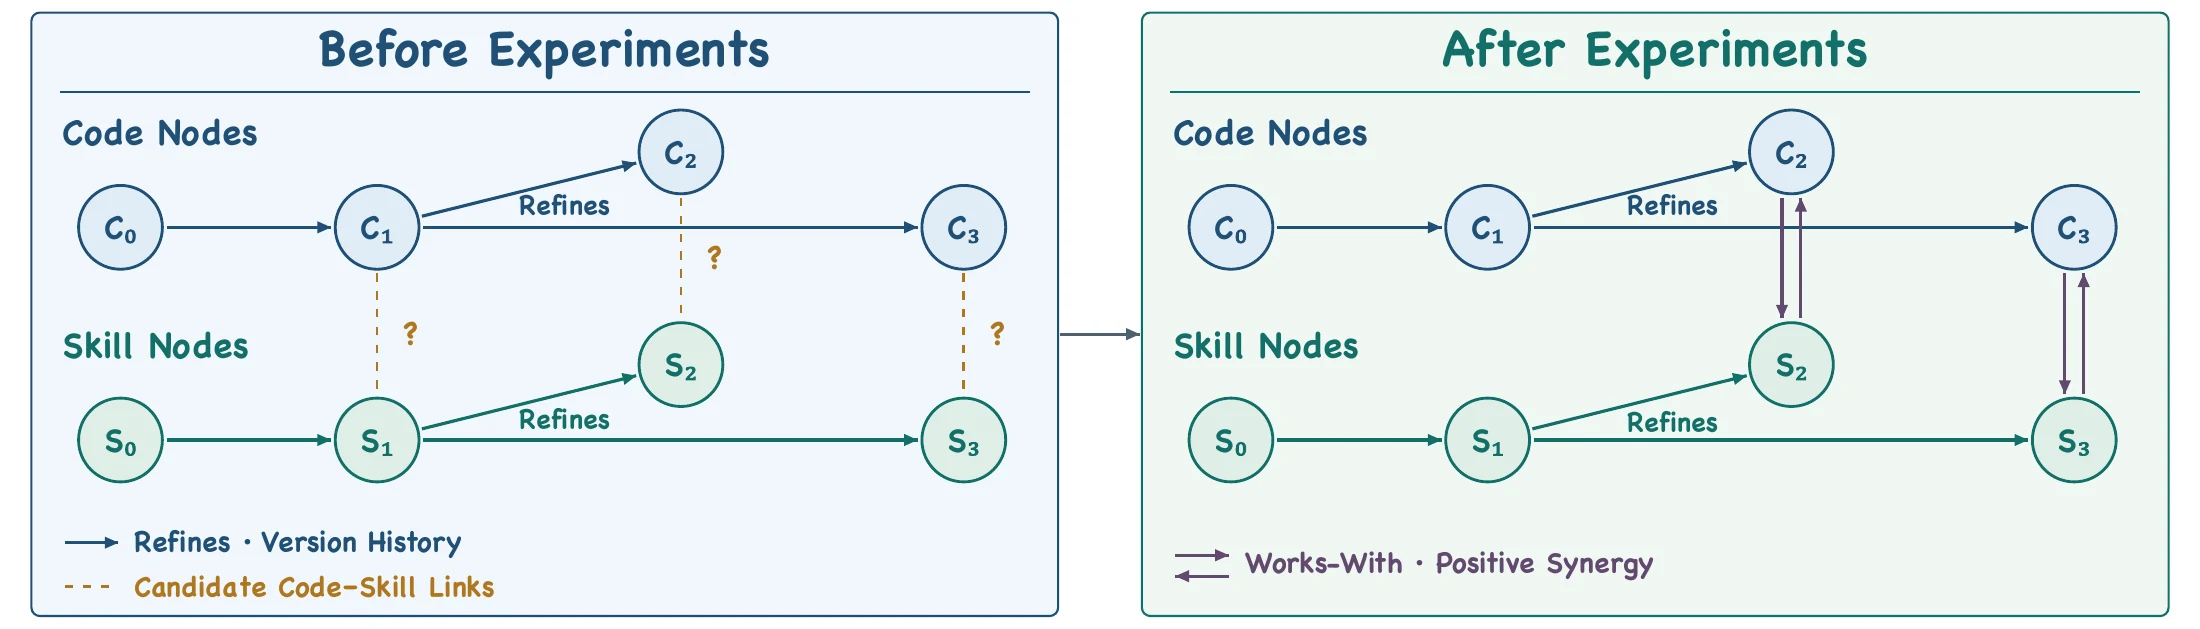
图 2. 实验结果如何将候选关系转为有证据支持的代码技能组合。图源:原论文 Figure 3。
3.4 分层记忆与基于回报的记忆管理
| 层次 | 保存的内容 | 对后续改进的作用 |
|---|---|---|
| M1:执行经验 | 轨迹、工具调用、VLA 调用时刻、动作、遥测、结果与奖励 | 保留可以回查的原始证据 |
| M2:假设图 | 代码与技能假设、支持计数、修订和组合关系 | 组织候选修改及其依据 |
| M3:可复用认知 | 从重复证据中提炼的规则与策略 | 为新实验提供更高层的指导 |
每次执行自动进入 M1,匹配证据按照快系统规则更新 M2。慢系统再从经验与图中形成 M3;下一轮实验检索 M2 和 M3,以生成、筛选候选。
记忆 Manager 在当前经验和检索记录的基础上,选择操作及其目标,动作包括 Retain、Merge、Abstract、Compress、Forget 和 Skip。冻结的 Qwen3-Embedding-0.6B 提供文本表示,可训练的上下文、候选表示与评分模块决定动作概率;冻结的 Qwen3.5-122B-A10B Operator 负责执行记忆操作。
这些操作更新检索索引或 M3,同时保留原始 M1 记录与 M2 的证据更新。因此,Forget 不宜被理解为直接擦除原始试验历史。
Manager 用 PPO 训练。一次记忆操作之后,下一个实验带来的奖励同时考虑成功率变化、不确定性减少和实际成本:
成功率在同一评价协议下比较,熵变化在同一假设集合上计算,再以多步折扣回报训练策略。这个设计避免只奖励记忆写入本身,而是把奖励连接到记忆之后发生的实验;不过,成功率估计噪声与延迟归因仍会影响学习质量。
4. Experiments:收益出现在哪里,比较条件是什么?
4.1 仿真泛化:未见组合与位置变化
RoboCasa365 区分 Atomic-Seen、Composite-Seen 和 Composite-Unseen,分别检查已见原子任务、已见组合与预训练中未出现的技能组合。LIBERO-Pro 则使用指令重定向(T)和物体位置交换(S),检验目标及布局变化。
论文报告,两套仿真基准均对每个任务使用 10 个随机种子、每个种子 10 次试验。演化使用另一组 10 个种子,与最终评价种子互不重叠。种子隔离有助于检验对初始条件的泛化;“未见组合”还应按基准自身的划分理解,不能扩展为对所有未知家庭任务的保证。
下面摘录原论文 Table 1,单位为成功率百分数;Overall 保留论文汇总值。
| 方法 | Atomic-Seen | Composite-Seen | Composite-Unseen | Overall |
|---|---|---|---|---|
| π0.5 | 39.6 | 7.1 | 1.2 | 16.9 |
| Xiaomi-Robotics-1 | 80.2 | 57.1 | 32.1 | 57.4 |
| Harness VLA | 91.3 | 55.8 | 40.1 | 63.6 |
| EmbodiedRSI | 94.4 | 63.1 | 71.3 | 77.0 |
最明显的变化出现在 Composite-Unseen:从最佳基线 Harness VLA 的 40.1% 提升至 71.3%,增加 31.2 个百分点。这支持一个重要方向:底层运动模型不变时,改进外部代码、技能组织与执行条件,仍能显著影响新组合任务的完成率。
LIBERO-Pro 上,EmbodiedRSI 的总体成功率为 86.8%,Harness VLA 为 72.1%;相对这个基线,八个任务族与扰动组合都有提升。其中 SPATIAL 的位置交换从 69.0% 升至 93.0%,LIBERO-10 的位置交换从 49.0% 升至 71.0%。这并不意味着每个单元都领先所有方法:例如 GOAL-T 上 Zetta 为 92.5%,EmbodiedRSI 为 78.0%。
4.2 真机迁移:迁移的是框架,底层模型已经过示范微调
真机使用 SO-101 机械臂,比较 SmolVLA 单独执行与同一底层模型加上 EmbodiedRSI。每个任务收集 50 条人工遥操作示范,在 4 张 NVIDIA H200 上对 SmolVLA 全量微调 20,000 步,随后在全部评测试验中冻结模型。
零样本迁移指在仿真中演化的代码与技能框架直接用于真机,而不是整个机器人系统从未使用真机训练数据。 这个区分决定了如何理解 46.0% 到 71.3% 的提升:两种条件共享经过适配的底层模型,差别在于是否使用演化后的执行框架。
原论文 Table 3 对每个任务、每种条件各运行 30 次;五项任务合计每种条件 150 次。
| 真机任务 | SmolVLA | EmbodiedRSI |
|---|---|---|
| 将 Oreo 放入红碗 | 70.0% | 86.7% |
| 选出面值乘以 5 等于 100 的筹码 | 10.0% | 90.0% |
| 在午餐肉罐头上叠放两块蛋糕 | 63.3% | 76.7% |
| 从鼻梁处抓起眼镜 | 60.0% | 56.7% |
| 折叠毛巾 | 26.7% | 46.7% |
| Overall | 46.0% | 71.3% |
最大收益来自筹码任务:系统先根据算术指令定位面值为 20 的目标,再组织执行;每次试验都会打乱筹码位置和朝向。它展示了高层推理与视觉目标定位对已有运动能力的补充。
眼镜精细抓取从 60.0% 降至 56.7%,对应 30 次试验中少成功一次。样本量不足以据此判断稳定退化,但它说明总体提升并不覆盖每种能力,语义推理和流程改进也不能自动解决窄抓取点的控制误差。
4.3 同样的交互预算,实验选择会改变学习进度
原论文 Table 4 比较 50 个物理交互回合后的学习效果。这里的 Physical Episodes 是论文对环境执行回合的称呼,应与前面的真机示范采集和真机评测次数分开理解。
| 方法 | 50 回合后总体成功率 | Learning AUC |
|---|---|---|
| Random Exploration | 27.1% | 0.309 |
| EmbodiedRSI | 72.9% | 0.635 |
固定 50 回合时,最终成功率相差 45.8 个百分点。Learning AUC 同时反映学习过程中的表现,论文报告完整方法更高;不过,相同回合数并不等于相同墙钟时间或总算力,完整成本还应包括候选生成、匹配试验、记忆策略训练与复位开销。
论文还展示了一个独立的 LIBERO-Pro SPAT-T 代表性案例:信息价值选择在第 48 回合达到并维持八回合滚动成功率 100%,随机选择到第 100 回合仍在波动。这个案例帮助理解实验选择如何改变局部学习过程,但滚动窗口高度重叠,单条曲线也不能当成全基准稳定达到 100% 的证据。
4.4 联合更新与记忆学习各自带来什么?
代码技能消融固定底层 VLA、任务套件、物理实验预算与评价协议,只改变允许更新的部分。Composite-Unseen 上,联合更新为 71.3%,仅更新技能为 55.6%。同时,代码单独更新在 Atomic-Seen 上优于技能单独更新,但在 Composite-Unseen 上次序反转,说明适合熟悉原子任务的改动不一定最有利于新组合。
记忆消融则比较基于检索的选择、只用任务奖励的 PPO,以及包含不确定性与成本项的完整奖励。原论文 Table 5 如下。
| 记忆管理方式 | Composite-Unseen 成功率 | Learning AUC |
|---|---|---|
| Retrieval-Based | 61.7% | 0.556 |
| PPO + Task Reward Only | 65.2% | 0.589 |
| 完整 EmbodiedRSI | 71.3% | 0.635 |
这些结果支持两点:代码与技能共同调整比单独更新更适合所测的新组合任务;记忆管理除了关心任务是否成功,还可以从证据减少和交互成本中获得有效信号。它们尚不能独立分解完整奖励中每一个权重的贡献,也没有证明任意任务上都会得到相同收益。
4.5 当前版本的复现信息边界
本文依据 arXiv v1 核对结果。该版本公开 PDF 共 12 页,包含正文与参考文献;文中将部分实现和训练设置指向另行提供的补充材料,但本次获取的 PDF、HTML 与源码包没有包含这些附录内容。
因此,VOI 的结果概率细节、成本权重与停止阈值、PPO 训练配置,以及仿真实验的完整骨干模型对应关系,尚无法从这份公开正文逐项核实。主结果表也未同时给出误差区间。方法闭环和报告数值可以分析,但对严格复现、完整成本和跨方法控制条件的判断仍需要这些补充信息。
5. Conclusion
EmbodiedRSI 最值得关注的地方,是把机器人试验从反复消耗的机会,变成可以主动分配的证据来源。假设图保留修改方向及其依据,信息价值决定下一次实验,匹配试验检验代码技能组合,记忆策略再学习哪些经验值得影响未来决策。这些环节共同构成了模型外部的持续改进过程。
实验中最突出的收益出现在未见组合、位置扰动和需要语义推理的真机任务;精细抓取则提醒我们,执行框架的改进仍受到底层感知与控制能力约束。后续值得在固定总时间预算下,检验实验选择是否仍然占优,并用更多任务和独立重复评价收益的稳定性。
另一个关键问题是证据如何随系统变化而更新。代码、技能与环境持续改变时,旧假设的支持计数未必一直适用;从仿真走向真机,匹配初始状态也更困难。若能识别旧证据何时失效、重新检验关键组合,并把真实复位成本与失败后果纳入实验选择,这套方法才更有机会从有限任务上的有效闭环,走向长期运行的机器人自我改进。
References
- EmbodiedRSI: Active Continual Robot Learning Through Hypothesis-Guided Co-Evolution, arXiv:2610.10498v1, October 7, 2026.