作者:Hanyang Wang、Yimo Cai、Weiliang Chen、Jiawei Chi、Haowen Sun、Qiyu Dai、Yi-Hsin Hung、Xingzhuo Guo、Jinshan Ren、Runmao Yao、Ziwei Liu、Mingsheng Long、Yueqi Duan、Jun Gao、Jiangran Lyu、Fangfu Liu、Jialong Wu
单位: MirroS、Tsinghua University、Peking University、Nanyang Technological University
1. Motivation:看见运动,还需要能查询和修改运动的表示
一段视频可以让模型描述“球沿斜坡滚下”,却不一定让它回答球的实际速度、哪个接触条件改变了轨迹,或者初速度改变后会发生什么。像素保留了丰富外观,但相似画面可能对应不同的物体尺度、相机位置和动力学过程;自然语言便于描述事件,却很难精确承载连续位置、速度和物理参数。
三维重建补充了几何结构,但几何正确也不自动意味着运动机制正确。一个场景可以通过逐帧摆放物体复现视频,却没有解释物体为什么加速、碰撞之后为什么改变方向。若希望从观察走向定量推理,还需要能够显式表示状态、执行演化过程并接受干预的中间产物。
Code as Worlds 提出的 Code-as-World 范式,将物理世界表示为可执行程序。Agent 从文字或视频提出一个世界假设,执行并渲染它,对照输入证据修改相关部分。保留下来的世界不仅能生成视频,还能提供与视频同步的状态和数值标签,供视觉语言模型学习物体尺寸、位移、速度与加速度。
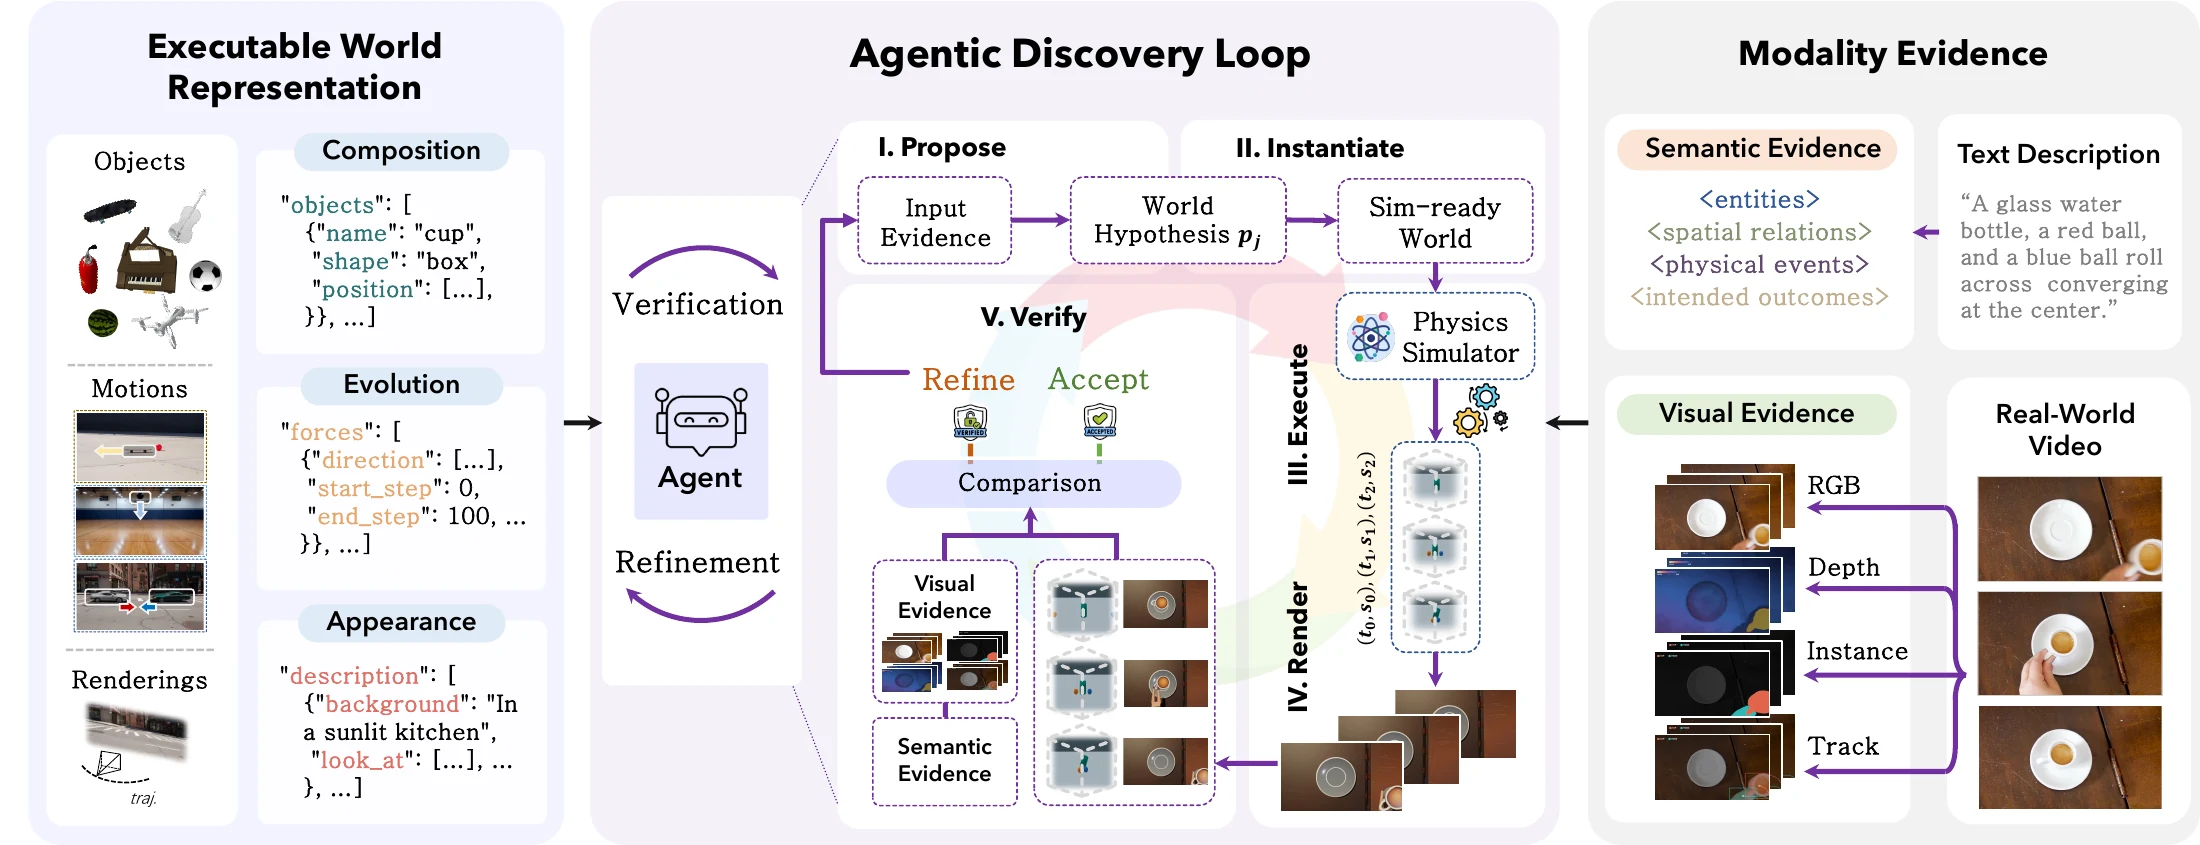
图 1. 可执行世界的 Agentic Discovery Loop。图源:原论文 PDF Figure 3。
2. Insight:显式世界既是可检验的假设,也是监督数据的来源
2.1 世界状态与观察方式应当分开
同一条物体轨迹可以从不同相机观察,也可以换材质和背景;物体初速度变化则应当改变状态演化。把这些因素分开,才能区分“改变世界”和“改变世界的外观”,也能检查一个编辑是否只影响了预期部分。
论文因此追求对物体、约束和演化过程的可操作描述,而不是要求每个像素都与原视频一致。这里的可操作性是表示的优势;它是否对应真实物理机制,仍然取决于输入证据和执行引擎。
2.2 发现世界是带反馈的搜索
单目视频没有直接给出完整尺度、遮挡后的几何或接触参数,文字描述通常更不完整。把观察一次性映射成程序,容易把不确定的猜测固化成结果。Code-as-World 将候选表示留在一个可修改的假设空间中,通过运行结果定位几何、运动或外观上的偏差,再进行局部修订。
这个循环采用溯因推理的思路:寻找能够解释现有证据的世界,而不是保证恢复唯一真实世界。多个程序仍可能解释同一段有限观察,模拟器无法表达的过程也可能被其他参数近似。
2.3 可执行状态能够补足视频缺少的数值标签
真实视频常常没有精确速度、实际尺寸或加速度标注。一个执行后的世界则能同时输出视频、相机、物体几何、时间戳和状态轨迹,从同一份状态记录中生成问题与答案。
这种标签在对应的模拟世界内部可以精确计算,但“模拟器里的真值”与“源视频真实世界里的真值”仍有区别。世界假设与原观察的偏差,会成为生成监督的误差来源。因此,数据构建既需要执行正确,也需要证据核对和可见性筛选。
3. Method:从观察发现世界,再从世界训练测量能力
3.1 Executable World Representation 的三个组成部分
论文将可执行世界表示 EWR 写为:
| 组成 | 表达什么 | 典型内容 |
|---|---|---|
| Physical Composition: | 世界中存在什么 | 物体、几何、实际尺寸、质量、摩擦、重力、支撑与碰撞结构 |
| Dynamic Evolution: | 世界怎样随时间变化 | 初始状态、运动过程、事件、接触及终止条件 |
| Visual Appearance: | 世界怎样被观察 | 相机、材质、光照、纯视觉背景、帧率与渲染设置 |
地面或桌子如果参与接触,就属于物理构成;只提供视觉背景的元素则属于外观。分开这些职责后,Agent 可以修改一个物理量或相机参数,同时保留其他部分。
实现使用 MuJoCo 平台,并提供共享 EWR 接口的两种执行引擎。动画引擎用随时间变化的位姿与轨迹描述运动;物理引擎根据力、接触和约束推导运动。主文的发现循环实验使用视频证据加动画引擎,附录再报告物理引擎实验。两者能够接受相同表示接口,但对“解释运动原因”的支持程度不同。
3.2 不同输入先转成不同证据
文字输入先提取实体、空间关系、物理事件和预期结果。对于文字没有规定的几何、参数或相机,Agent 结合先验和默认条件初始化,再通过语义与物理约束核对。这类世界是满足描述的一种实例化,不应理解成文字唯一决定了所有物理参数。
视频输入则先提取结构化视觉证据:SAM3 提供实例掩码与图像平面轨迹,VGGT-Omega 提供深度和相机几何,SAM3D 为分割对象生成三维几何。Agent 将这些结果组合成对象位置、尺度和动态状态,再把执行后的世界投影回输入视角比较。
视频候选来自 WISA-80K,筛选重点是明显的刚体运动或碰撞。显著相机运动、物体运动不足、严重剪辑或事件不完整的片段会被移除,并经过人工复核。这些条件也说明当前实验覆盖的是经过筛选、适合可执行重建的场景。
3.3 提出、实例化、执行、渲染、验证
每轮循环先根据证据和上一轮反馈修改 EWR,再将它转换为引擎参数,运行得到状态轨迹。视频候选会进一步渲染 RGB,并投影深度、掩码和图像平面轨迹;验证器在选定关键帧上比较这些结果,将差异汇总成结构化反馈。
文字候选主要核对语义和物理约束,视频候选同时核对外观、几何与运动。满足接受条件的世界被保留;到达迭代预算仍未通过的候选被拒绝。最终评测使用不进入验证信号的独立指标,以减少只优化内部判断的影响。
获得世界后,可以改变初速度、物体属性或相机重新执行。论文还使用 Wan2.2-VACE 与内部视频生成模型改善渲染视频的真实感。这里的 sim-to-real 指视频外观转换;这些结果本身不构成机器人从仿真迁移到真机的证据。
3.4 先学图像测量,再学世界尺度
第一阶段从 RefCOCO 系列、RefCLEF 和 GOT-10K 的框与轨迹构造图像空间监督,进行 SFT。它让模型学习目标定位、像素尺寸,以及由轨迹计算的运动量。对于等间隔采样的中心位置 ,例如:
第二阶段从保留的 EWR 生成世界空间问答,利用同步几何和轨迹计算数值答案。题目涉及目标、时间范围、物理量和输出单位,并检查目标及参考量在对应观察中是否有效。
世界单位通常需要尺度参照。若已知参考量的实际值 ,并测得其图像值 ,基本标定关系为:
三维情形还需要深度和透视信息。因此,这里的定量推理利用题目提供的物理先验,不能解释为仅从无尺度单目像素恢复绝对物理单位。
4B 和 9B 直接回答模型在第二阶段使用 GRPO,奖励结合相对数值误差、单位正确性和格式。数值项为 。27B 推理模型采用单独协议,以最终答案的 MRA 作为结果奖励,不对推理过程内容提供过程监督。
4. Experiments:世界拟合与下游推理需要分别评价
4.1 五次评价预算下,反馈修订通常优于独立采样
主文将最多五轮的发现循环,与一次生成和 Best-of-5 独立采样比较。图中观察的是输入视频与模拟器渲染结果的差异,而不是经过真实感转换后的视觉效果。
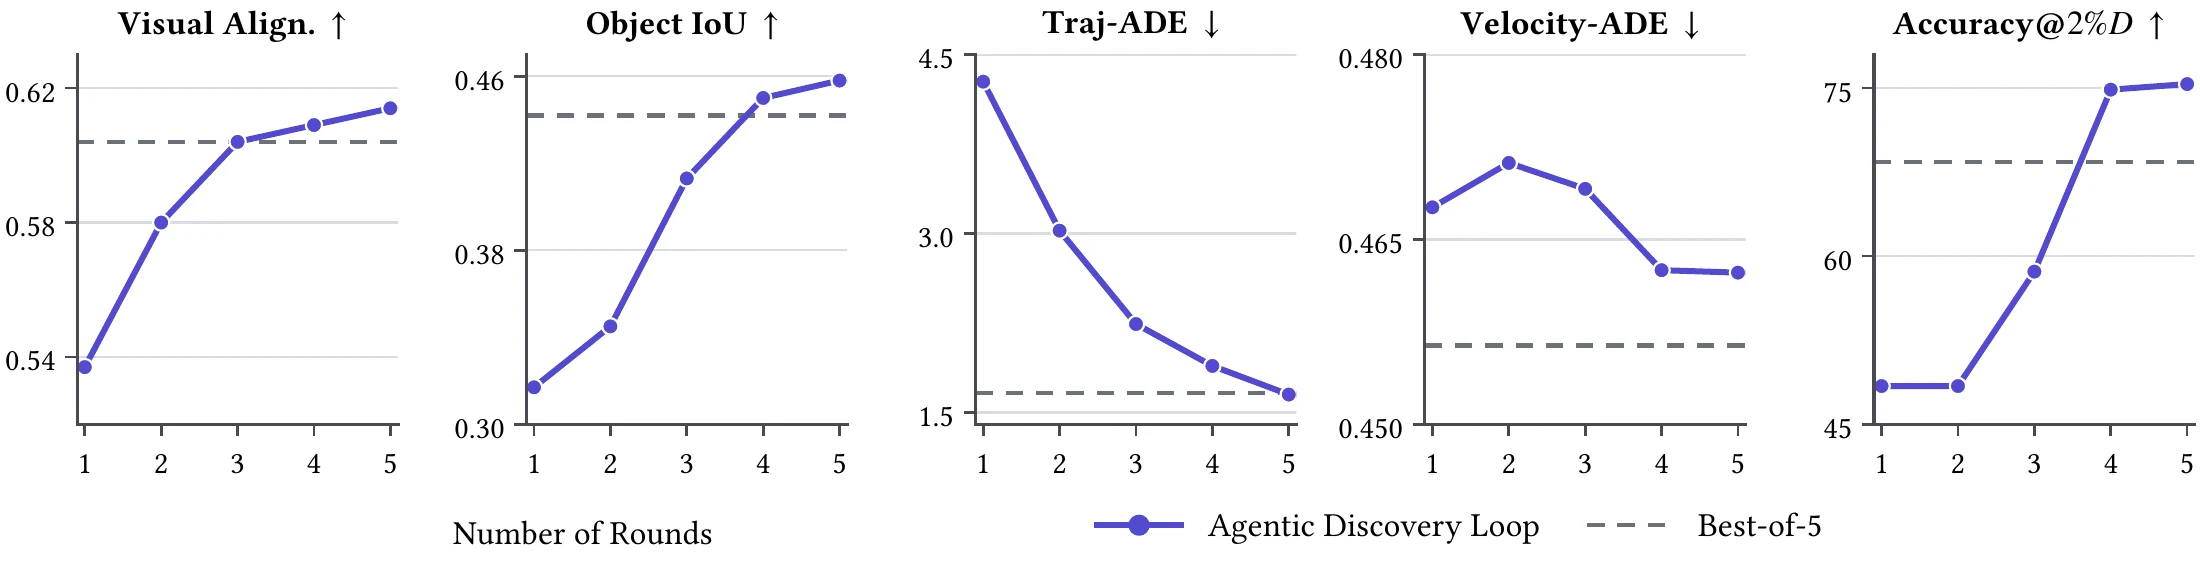
图 2. 相同五次评价预算下的迭代发现与独立采样。图源:原论文 PDF Figure 5。
Visual Alignment 综合轮廓、深度和 RGB 一致性,Object IoU 衡量对象区域重叠;Traj-ADE 衡量位置轨迹误差,Velocity-ADE 衡量相邻采样间的位移误差,Accuracy@2% D 则统计误差小于图像对角线 2% 的有效观测比例。
五轮修订在视觉一致性、IoU、轨迹误差和位置准确率上优于 Best-of-5,但主文图中的 Velocity-ADE 仍由 Best-of-5 更好,不能概括为所有运动指标都领先。附录的物理引擎实验报告五项指标均优于对应的独立采样基线。
这些结果支持利用反馈修订世界假设的价值,但匹配的是评价次数,未必是完整 token、运行时间或生成成本。图像平面轨迹吻合也不能单独证明质量、摩擦等不可直接观察参数被正确恢复。
4.2 训练数据与 QuantiPhy 的评分范围
论文的图像空间训练集包含 73,335 个问答样本,其中 46,763 个来自 GOT-10K,其余来自四个指代表达数据集。世界空间监督包含 1,585 个文字驱动和 988 个视频驱动问答,共 2,573 个;这些是问答数量,不是独立世界或视频数量。
QuantiPhy-validation 只有 159 个公开问答样本。模型每段视频均匀采样 16 帧,并获得题目、单位和基准给定的物理先验;涉及三维的问题还提供相应深度背景。2S、2D、3S、3D 中,数字区分平面与深度相关设置,字母区分提供的是静态还是动态先验,并非目标答案本身必须静态或动态。
MRA 在十个相对误差阈值上给分,再对四个子集作等权宏平均。无法解析成有限数值的回答为零分;协议将解析值取绝对值后评价。因此,MRA 58.6 不是“58.6% 的题完全答对”,也不衡量带符号方向的完整恢复。这个小型公开验证集上的结果,应与更广泛的隐藏测试和物理能力分开理解。
4.3 定量物理推理结果
下表摘录原论文 Table 1,数值为百分制 MRA。
| 模型 | 2S | 2D | 3S | 3D | 宏平均 |
|---|---|---|---|---|---|
| Qwen3-VL-32B-Instruct | 38.1 | 39.7 | 39.8 | 43.0 | 40.2 |
| Gemini-3.1 Flash | 49.4 | 47.5 | 61.4 | 61.1 | 54.8 |
| Code-as-World-VL-4B | 45.4 | 55.4 | 45.8 | 56.0 | 50.6 |
| Code-as-World-VL-9B | 55.0 | 52.9 | 55.6 | 58.1 | 55.4 |
| Code-as-World-VL-27B(Reasoning) | 48.7 | 62.4 | 60.5 | 62.8 | 58.6 |
9B 模型的宏平均略高于表中 Gemini-3.1 Flash,27B 推理版本进一步提高。但不同子集仍有取舍,例如 9B 的 3S 和 3D 均低于 Gemini。27B 同时改变参数规模和回答协议,所以不能把 58.6 与 55.4 的差异全部归因于推理链。
27B 的报告结果来自训练第 60 步的一次验证运行,每题采样一个回答,最多输出 6,144 tokens,不使用多次投票、Best-of-N 或工具调用。测试时也不能访问生成题目的 EWR、模拟器状态、对象轨迹或检索信息。当前模型学到的是世界监督下的回答能力,外部发现循环并没有在每道测试题中重新运行。
4.4 文字与视频世界监督的增益
原论文 Table 4 比较在图像空间训练之后加入不同世界数据的结果,以下列出宏平均 MRA。
| 训练配置 | 4B | 9B |
|---|---|---|
| 仅图像空间监督 | 44.2 | 50.9 |
| 再加入文字驱动世界 | 48.5 | 52.5 |
| 再加入视频驱动世界 | 47.8 | 53.1 |
| 同时加入两种世界数据 | 50.6 | 55.4 |
两类世界数据单独加入均改善平均结果,混合后最高。这与“文字世界提供可控状态,视频世界补充真实观察分布”的设计相符。联合训练也不是每个子集都最优,例如 9B 的 3D 在仅加入视频世界时为 61.5,混合后为 58.1。
论文 Table 1 和 Table 4 均给出完整 9B 模型为 55.4,但附录紧随表格的总结句写成 56.8;本文统一采用两张表中的 55.4。数据来源消融也不等同于等数据量、等成本的因果比较,不能仅凭这张表完全分离数据种类与训练量的影响。
5. Conclusion
Code as Worlds 的价值,是在观察与答案之间留下一个可以执行、查询和干预的世界表示。它既让世界假设接受多种证据检查,也让同步状态成为数值监督来源,使视觉模型获得仅靠自然视频较难收集的测量与尺度标定训练。
当前证据最直接支持的是经过筛选场景中的可执行重建,以及有限定量物理问答上的改进。轨迹拟合、模拟状态正确和真实机制正确是不同层面的要求;动画引擎能复现运动,不能自动识别动力学,物理引擎也会受到模型范围与参数歧义的限制。
后续值得用未参与拟合的干预来检验世界:改变初速度、接触条件或外力后,预测能否仍与真实结果对应。训练方面,则需要从数值答案进一步走向假设生成、执行诊断与修订过程的学习。把这些能力纳入评价,才能判断模型是否不仅会利用世界产生的标签,也能独立发现和修正自己的世界解释。
References
- Code as Worlds: Agentic Discovery of Executable World Representations for Physical Reasoning, arXiv:2608.27549v1, August 27, 2026.