作者:Jiawei Chi、Shangchen Miao、Zhiyuan Shi、Kailu Wu、Hanyang Wang、Weiliang Chen、Qiyu Dai、Jinshan Ren、Jun Gao、Mingsheng Long、Yueqi Duan、Jiangran Lyu、Jialong Wu、Fangfu Liu
单位: MirroS、Tsinghua University、Peking University
1. Motivation:Agent 练习的世界,能否同时可信与丰富?
让 Agent 在环境中练习,需要两个条件:动作造成的后果能够保留,视觉观测又足够丰富。推开一块挡板之后,下一次观察应当反映它的新位置;走到另一侧,物体的形状、身份和遮挡关系也应当一致。
模拟器和游戏引擎擅长维护状态与规则,但提高视觉多样性通常依赖资产和材质制作。视频模型能够生成丰富外观,任务状态却经常隐含在生成历史中,难以单独检查某个对象是否仍存在、某次动作是否真的改变了它。
AgentGarten 将这两项职责分开:代码和引擎维护世界,神经渲染器负责把世界显示给 Agent。随后,Agent 在这些环境中执行任务,将经验写成下一轮可以继承的 playbook。
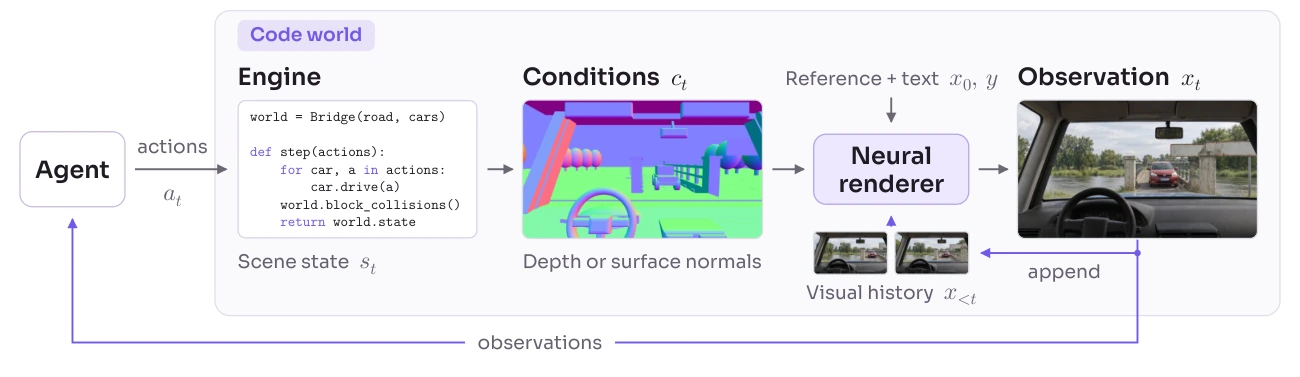
图 1. 世界状态、几何条件与神经观测的交互回路。图源:原论文 Figure 1。PDF 首页另有未按 HTML 相同方式编号的总览图。
2. Insight:状态可靠性与观测真实性需要分别检查
2.1 渲染错误不会直接改写引擎状态
引擎接收 Agent 的动作并更新对象位置、关节和任务变量,状态转移不以生成图像为输入。因此,画面偶尔漏掉一个物体,不会直接把它从引擎中删除。同一条状态轨迹还能用不同外观参考重新渲染。
但错误观测仍可能让 Agent 选择错误动作,随后间接影响真实状态。状态与渲染分开,消除了一个错误累积路径,并没有保证 Agent 看到的每个事实都正确。
2.2 几何条件决定哪些事实能传给渲染器
深度和法线能够表达轮廓、位置与遮挡,却不能完整表达颜色、材质、身份和所有动力学状态。例如,一个绕自身轴旋转的对称物体,几何图可能不变,表面标记却应当移动。相关属性需要参考图、文字或视觉历史补充。
因此,这里的可执行世界比渲染器实际获得的信息更完整。未来最值得检查的不是画面是否漂亮,而是控制任务所需的状态是否都能从条件接口中恢复。
3. Method:代码世界、实时渲染和跨轮经验
3.1 一个可执行、可回放的世界
记场景程序为 ,世界状态为 ,相机为 ,动作是 。引擎更新状态并导出几何条件:
渲染器利用历史画面、条件、外观参考 和文字 生成新观测:
代码世界可以从文字或单张图构建。图像路线调用分割、深度、三维框和网格工具,由编程 Agent 组装场景,再通过多视角试运行及接触、碰撞、净空检查修订。补全不可见区域属于合理创作,不能当成原图中已经观测到的事实。
3.2 Adversarial Forcing 为什么需要重放历史?
渲染器以 Cosmos 3-Nano 为初始化,先加入几何条件,再适配分块自回归生成,最后蒸馏为少步推理。Adversarial Forcing 同时使用分布匹配、历史梯度重放和真实视频对抗监督。
普通 Self Forcing 将已生成历史写进分离梯度的 KV cache,后续损失无法直接训练“如何编码这段历史”。本文先无梯度生成并保存轨迹,再重算历史编码与当前预测,使后面的损失可以更新缓存形成过程。
重放采用与生成相同的逐块执行形状、KV 顺序和注意力调用,减少有限精度下重算路径的数值偏差。这不是对整个采样链完整反向传播;保存的历史 latent 仍分离梯度,重新计算的是它们的编码。
真实视频的对抗项则补充纯分布匹配在长生成中丢失的纹理与细节。判别器使用冻结骨干和可训练头,通过向量—雅可比与雅可比—向量乘积计算精确 R1/R2 头部梯度,避免穿过融合注意力的双重反向传播。
3.3 Playbook 改变的是后续上下文
练习完成后,Agent 回看自己允许接收的视觉证据和动作程序,将成功、失败、疑问和下一步检查写成技能文件。下一轮从新的对话开始,读取任务和此前的 playbook。
这个过程保留了经验,但没有展示基础模型权重被持续训练。它主要研究预训练知识怎样通过环境交互被落实为可复用策略。
4. Experiments:渲染、执行成本与学习案例分别说明什么?
4.1 重放精度与吞吐
原论文 Table 1 在单张 H100、BF16、480×832、61 个 latent 帧上比较重放。FlexAttention 路线的相对 L2 重放误差是 3.99%,逐块 SDPA 达到逐位一致;前向时间从 2.95 秒降到 2.79 秒,显存从 50.83 GiB 变为 50.92 GiB。这些时间取三次预热运行的中位数,排除了反向传播和优化器更新。
Table 2 使用满缓存、四步去噪和 tiny decoder,每块输出 16 帧:
| 环节 | 时间 |
|---|---|
| 条件编码 | 10.6 ms |
| Transformer 去噪与缓存发布 | 414.4 ms |
| 解码与主机传输 | 8.8 ms |
| 总墙钟时间 | 438.8 ms |
| 吞吐 | 36.5 帧/秒 |
阶段时间和总时间使用不同统计方式,总时间还覆盖额外工作,所以不应要求三项严格相加。吞吐说明渲染可以追上其 16 fps 时间网格,但一次 16 帧块仍有约 439 ms 的等待,也未包含 Agent 决策的全部延迟。
4.2 “4 轮对比千万次”不是同条件效率比
躲猫猫中,预训练视觉 Agent 在第 4 轮搭建遮蔽物,第 10 轮利用斜坡越墙。论文对照 2019 年从随机权重训练的自博弈策略,其对应行为约在 2,500 万和 1 亿训练 episode 后出现。
两组系统的先验、输入、动作和训练机制不同:旧策略从零学习,读取特权对象状态;这里的 Agent 已有大规模预训练知识,只读取神经渲染的第一视角画面,并通过短 Python 程序行动。论文明确将此作为不同学习范式的行为里程碑,不能据此计算统一的样本效率倍数。
4.3 四个额外环境仍是小规模轨迹证据
Table 4 给出每轮一局的结果:陪伴犬得分从 13 升至 19;单车道桥两车换边用时从 71 秒降至 41 秒;牧羊从圈入 3 只变为 4 只;装载机得分为 30、0、30、90.9。
装载机第二轮退化说明经验更新并非单调改进。这些轨迹支持 playbook 可帮助后续执行,但没有充分的多种子均值、独立世界迁移和长期遗忘评测,不能解释为已证实持续开放式进化。
5. Conclusion
AgentGarten 的价值是提供一条可检查的环境构建路线:让代码固定动作后果,让共享神经渲染器提供丰富外观,再用可继承的经验连接不同轮次。渲染精度、观测中的事实保留和 Agent 的学习收益,应当分别评价。
后续可以固定世界、种子和预算,对照空 playbook、原始轨迹与抽象技能,并把经验转移到未见布局和规则中。同时为几何接口补充身份与交互状态,检查观测错误是否改变动作选择。这比继续增加演示环境,更能回答这套方法是否形成可靠、可迁移的学习机制。
References
- AgentGarten: Code Worlds for Evolving Agents, arXiv:2610.12374v1, 2026-10-08.